
一、什么是线程池:
线程池主要是为了解决 新任务执行时,应用程序为任务创建一个新线程 以及 任务执行完毕时,销毁线程所带来的开销。通过线程池,可以在项目初始化时就创建一个线程集合,然后在需要执行新任务时重用这些线程而不是每次都新建一个线程,一旦任务已经完成了,线程回到线程池中并等待下一次分配任务,达到资源复用的效果。
1、线程池的主要优势有:
(1)降低资源消耗:通过池化技术重复利用已创建的线程,降低线程创建和销毁造成的损耗。
(2)提高响应速度:任务到达时,无需等待线程创建即可立即执行。
(3)提高线程的可管理性:线程是稀缺资源,如果无限制创建,不仅会消耗系统资源,还会因为线程的不合理分布导致资源调度失衡,降低系统的稳定性。使用线程池可以进行统一的分配、调优和监控。
(4)提供更多更强大的功能:线程池具备可拓展性,允许开发人员向其中增加更多的功能。比如延时定时线程池ScheduledThreadPoolExecutor,就允许任务延期执行或定期执行。
二、创建线程池:
1、通过Executors创建线程池:
在JUC包中的Executors中,提供了一些静态方法,用于快速创建线程池,常见的线程池有:
(1)newSingleThreadExecutor:创建一个只有一个线程的线程池,串行执行所有任务,即使空闲时也不会被关闭。可以保证所有任务的执行顺序按照任务的提交顺序执行。如果这个唯一的线程因为异常结束,那么会有一个新的线程来替代它。
适用场景:需要保证顺序地执行各个任务;并且在任意时间点,不会有多个线程活动的应用场景。
(2)newFixedThreadPool:创建一个固定线程数量的线程池(corePoolSize == maximumPoolSize,使用LinkedBlockingQuene作为阻塞队列)。初始化时线程数量为零,之后每次提交一个任务就创建一个线程,直到线程达到线程池的最大容量。线程池的大小一旦达到最大值就会保持不变,如果某个线程因为执行异常而结束,那么线程池会补充一个新线程。
适用场景:为了满足资源管理的需求,而需要限制当前线程数量的应用场景,它适用于负载比较重的服务器。
(3)newCachedThreadPool:创建一个可缓存的线程池,线程的最大数量为Integer.MAX_VALUE。空闲线程会临时缓存下来,线程会等待60s还是没有任务加入的话就会被关闭。
适用场景:适用于执行很多的短时间异步任务的小程序,或者是负载较轻的服务器。
(4)newScheduledThreadPool:创建一个支持执行延迟任务或者周期性执行任务的线程池。
2、ThreadPoolExecutor构造函数参数的说明:
使用Executors创建的线程池,其本质都是通过不同的参数构造一个ThreadPoolExecutor对象,主要包含以下7个参数:
 public ThreadPoolExecutor(int corePoolSize,
                           int maximumPoolSize,
                           long keepAliveTime,
                           TimeUnit unit,
                           BlockingQueue<Runnable> workQueue,
                           ThreadFactory threadFactory,
                           RejectedExecutionHandler handler) {

     // 省略...
 }
(1)corePoolSize:线程池中的核心线程数,当提交一个任务时,线程池创建一个新线程执行任务,直到当前线程数等于corePoolSize;如果当前线程数为corePoolSize,继续提交的任务被保存到阻塞队列workQueue中,等待被执行;如果执行了线程池的prestartAllCoreThreads()方法,线程池会提前创建并启动所有核心线程。
(2)maximumPoolSize:线程池中允许的最大线程数。如果当前workQueue满了之后可以创建的最大线程数。
(3)keepAliveTime:空闲线程的存活时间。
(4)unit:keepAliveTime空闲线程存活时间的单位;
(5)workQueue:阻塞队列,用来存放等待被执行的任务,且任务必须实现Runnable接口,在JDK中提供了如下阻塞队列:
- ArrayBlockingQueue:基于数组结构的有界阻塞队列,按FIFO排序任务;
- LinkedBlockingQuene:基于链表结构的阻塞队列,按FIFO排序任务,吞吐量通常要高于ArrayBlockingQuene;
- SynchronousQuene:一个不存储元素的阻塞队列,每个插入操作必须等到另一个线程调用移除操作,否则插入操作一直处于阻塞状态,吞吐量通常要高于LinkedBlockingQuene
- PriorityBlockingQuene:具有优先级的无界阻塞队列;
- DelayQueue:一个使用优先级队列实现的无界阻塞队列,只有在延迟期满时才能从中提取元素。
- LinkedTransferQueue:一个由链表结构组成的无界阻塞队列。与SynchronousQueue类似,还含有非阻塞方法。
- LinkedBlockingDeque:一个由链表结构组成的双向阻塞队列。
(6)threadFactory:线程工厂,主要用来创建线程,默认为正常优先级、非守护线程。
(7)handler:线程池拒绝任务时的处理策略。
3、不要使用Executors创建线程池:
阿里巴巴开发手册并发编程有一条规定:线程池不允许使用Executors去创建,而是通过ThreadPoolExecutor的方式,这是为什么呢?主要是因为这样的可以避免资源耗尽的风险,因为使用Executors返回线程池对象的弊端有:
(1)FixedThreadPool 和 SingleThreadPool 允许的阻塞队列长度为 Integer.MAX_VALUE,这样会导致堆积大量的请求,从而导致OOM;
(2)CachedThreadPool 允许创建的线程数量为 Integer.MAX_VALUE,可能会创建大量的线程,从而导致 OOM。
所以创建线程池,最好是根据线程池的用途,然后自己创建线程池。
三、线程池执行策略:
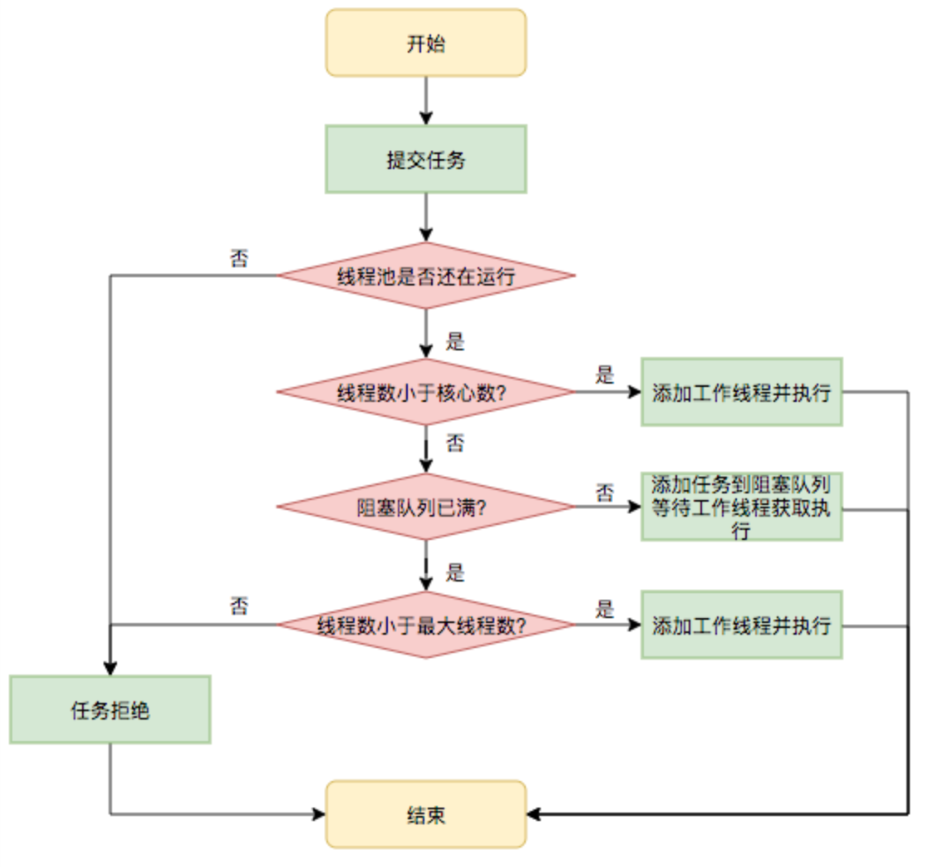

执行逻辑说明:
(1)当客户端提交任务时,线程池先判断核心线程数是否小于corePoolSize,如果是,则创建新的核心线程数运行这个任务;
(2)如果正在运行的线程数大于或等于corePoolSize,则判断workQueue队列是否已满,如果未满,则将任务放入workQueue中;
(3)如果workQueue队列已经满了,则判断当前线程池中的线程数量是否大于maximumPoolSize,如果小于maximumPoolSize,则启动一个非核心线程来执行任务;
(4)如果线程池中线程数量大于或等于maximumPoolSize,那么线程池会根据设定的拒绝策略,做出相应的措施。
- ThreadPoolExecutor.AbortPolic(默认):抛出RejectedExecutionException异常;
- ThereadPoolExecutor.CallerRunsPolicy:在当前正在执行的线程的execute方法中运行被拒绝的任务。
- ThreadPoolExecutor.DiscardOldestPoliy:丢弃workQueue中等待最长时间的任务,并将被拒绝的任务添加到队列之中。
- ThreadPoolExecutor.DiscardPolicy:将直接丢弃此线程。
(5)当一个线程完成任务时,它会从workQueue中获取下一个任务来执行。
(6)当一个线程空闲超过keepAliveTime设定的时间时,线程池会判断,如果当前线程数大于corePoolSize,那么这个线程就被停掉。所以线程池的所有任务完成后,它最终会收缩到corePoolSize的大小。
四、如何合理的配置Java线程池?
1、并发高、任务执行时间短:线程数大概和机器的cpu核数相当,可以使得每个线程都在执行任务,减少线程上下文的切换;
2、并发不高、任务执行时间长:
(1)IO密集型:因为IO操作并不占用CPU,大部分线程都阻塞,故需要多配置线程数,让CPU处理更多的业务;
(2)CPU密集型:线程池中的线程数设置得跟CPU核数差不多,减少线程上下文的切换;
3、并发高、业务执行时间长:
解决这种类型任务的关键不在于线程池而在于整体架构的设计,看看这些业务里面某些数据是否能做缓存是第一步,增加服务器是第二步。最后,业务执行时间长的问题,也可能需要分析一下,看看能不能使用中间件对任务进行拆分和解耦。
4、有界队列和无界队列的配置:
一般情况下配置有界队列,在一些可能会有爆发性增长的情况下使用无界队列。任务非常多时,使用非阻塞队列并使用CAS操作替代锁可以获得好的吞吐量。
发布者:全栈程序员-站长,转载请注明出处:https://javaforall.net/100038.html原文链接:https://javaforall.net



