

这是另一套基于CRF的词法分析系统,类似感知机词法分析器,提供了完善的训练与分析接口。
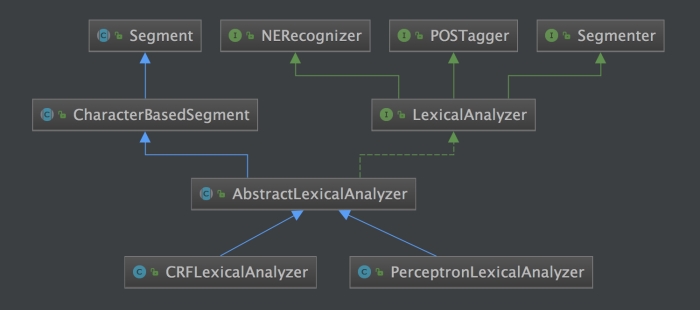

CRF的效果比感知机稍好一些,然而训练速度较慢,也不支持在线学习。
默认模型训练自OpenCorpus/pku98/199801.txt,随hanlp 1.6.2以上版本发布。
语料格式等与感知机词法分析器相同,请先阅读《感知机词法分析器》。
中文分词
训练
CRFSegmenter segmenter = new CRFSegmenter(null);
segmenter.train(“data/test/pku98/199801.txt”, CWS_MODEL_PATH);
输出为HanLP私有的二进制模型,有兴趣的话还可以通过命令导出为兼容CRF++的纯文本格式。
java -cp hanlp.jar com.hankcs.hanlp.model.crf.crfpp.crf_learn -T cws.bin cws.txt
与CRF++兼容
由于C++的运行效率和内存效率优于Java,所以推荐直接利用CRF++执行大规模训练。
首先将人民日报语料转换为CRF++格式:
CRFSegmenter segmenter = new CRFSegmenter(null);
segmenter.convertCorpus(“data/test/pku98/199801.txt”, “data/test/crf/cws-corpus.tsv”);
然后准备一份特征模板,或者直接用HanLP默认的:
segmenter.dumpTemplate(“data/test/crf/cws-template.txt”);
接着用CRF++的crf_learn执行训练:
crf_learn cws-template.txt cws-corpus.tsv cws -t
·此处必须使用-t命令CRF++输出文本格式的模型cws.txt
·HanLP只兼容CRF++的文本模型,不兼容二进制
将cws.txt格式的模型传入CRFSegmenter或CRFLexicalAnalyzer的构造函数即可创建分词器,同时HanLP会自动创建二进制缓存.txt.bin,下次加载耗时将控制在数百毫秒内。
预测
可通过如下方式加载:
CRFSegmenter segmenter = new CRFSegmenter(CWS_MODEL_PATH);
List<String> wordList = segmenter.segment(“商品和服务”);
System.out.println(wordList);
不传入模型路径时将默认加载配置文件指定的模型。
词性标注
CRF词性标注器的训练与加载与中文分词类似,对应CRFPOSTagger。
命名实体识别
CRF命名实体识别也是类似的用法,对应CRFNERecognizer。
CRF词法分析器
训练了1至3个模型后,可以构造CRF词法分析器:
/**
* 构造CRF词法分析器
*
* @param cwsModelPath CRF分词器模型路径
* @param posModelPath CRF词性标注器模型路径
* @param nerModelPath CRF命名实体识别器模型路径
*/
public CRFLexicalAnalyzer(String cwsModelPath, String posModelPath, String nerModelPath) throws IOException
/**
* 加载配置文件指定的模型
*
* @throws IOException
*/
public CRFLexicalAnalyzer() throws IOException
构造后可以调用analyze接口或与旧接口兼容的seg:
CRFLexicalAnalyzer analyzer = new CRFLexicalAnalyzer();
String[] tests = new String[]{
“商品和服务”,
“上海华安工业(集团)公司董事长谭旭光和秘书胡花蕊来到美国纽约现代艺术博物馆参观”,
“微软公司於1975年由比爾·蓋茲和保羅·艾倫創立,18年啟動以智慧雲端、前端為導向的大改組。” // 支持繁体中文
};
for (String sentence : tests)
{
System.out.println(analyzer.analyze(sentence));
System.out.println(analyzer.seg(sentence));
}
在1.6.2以上版本中,所有的词法分析接口都同时支持简繁。
转载于:https://my.oschina.net/u/3793864/blog/3011433
发布者:全栈程序员-站长,转载请注明出处:https://javaforall.net/101115.html原文链接:https://javaforall.net



