
大家好,又见面了,我是你们的朋友全栈君。
什么是网络爬虫
网络爬虫又称网络蜘蛛,是指按照某种规则在网络上爬取所需内容的脚本程序。众所周知,每个网页通常包含其他网页的入口,网络爬虫则通过一个网址依次进入其他网址获取所需内容。
优先申明:我们使用的python编译环境为PyCharm
一、首先一个网络爬虫的组成结构:
- 爬虫调度程序(程序的入口,用于启动整个程序)
- url管理器(用于管理未爬取得url及已经爬取过的url)
- 网页下载器(用于下载网页内容用于分析)
- 网页解析器(用于解析下载的网页,获取新的url和所需内容)
- 网页输出器(用于把获取到的内容以文件的形式输出)
二、编写网络爬虫
(1)准备所需库
我们需要准备一款名为BeautifulSoup(网页解析)的开源库,用于对下载的网页进行解析,我们是用的是PyCharm编译环境所以可以直接下载该开源库。
步骤如下:
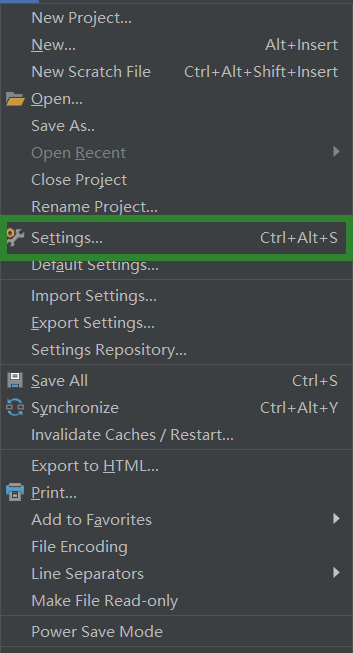
选择File->Settings

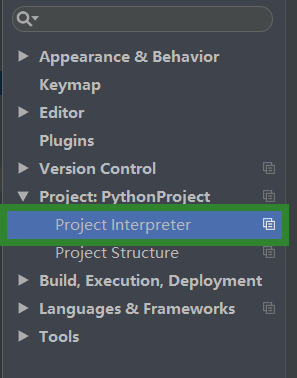
打开Project:PythonProject下的Project interpreter
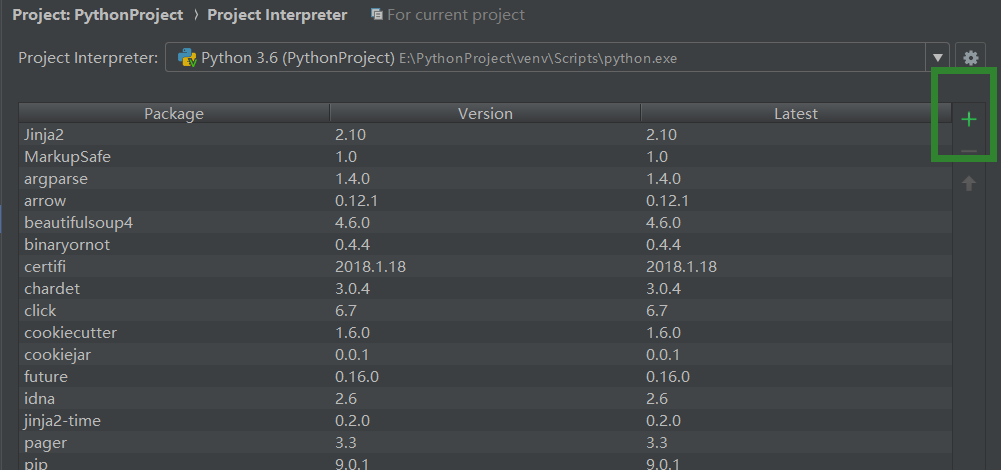
点击加号添加新的库
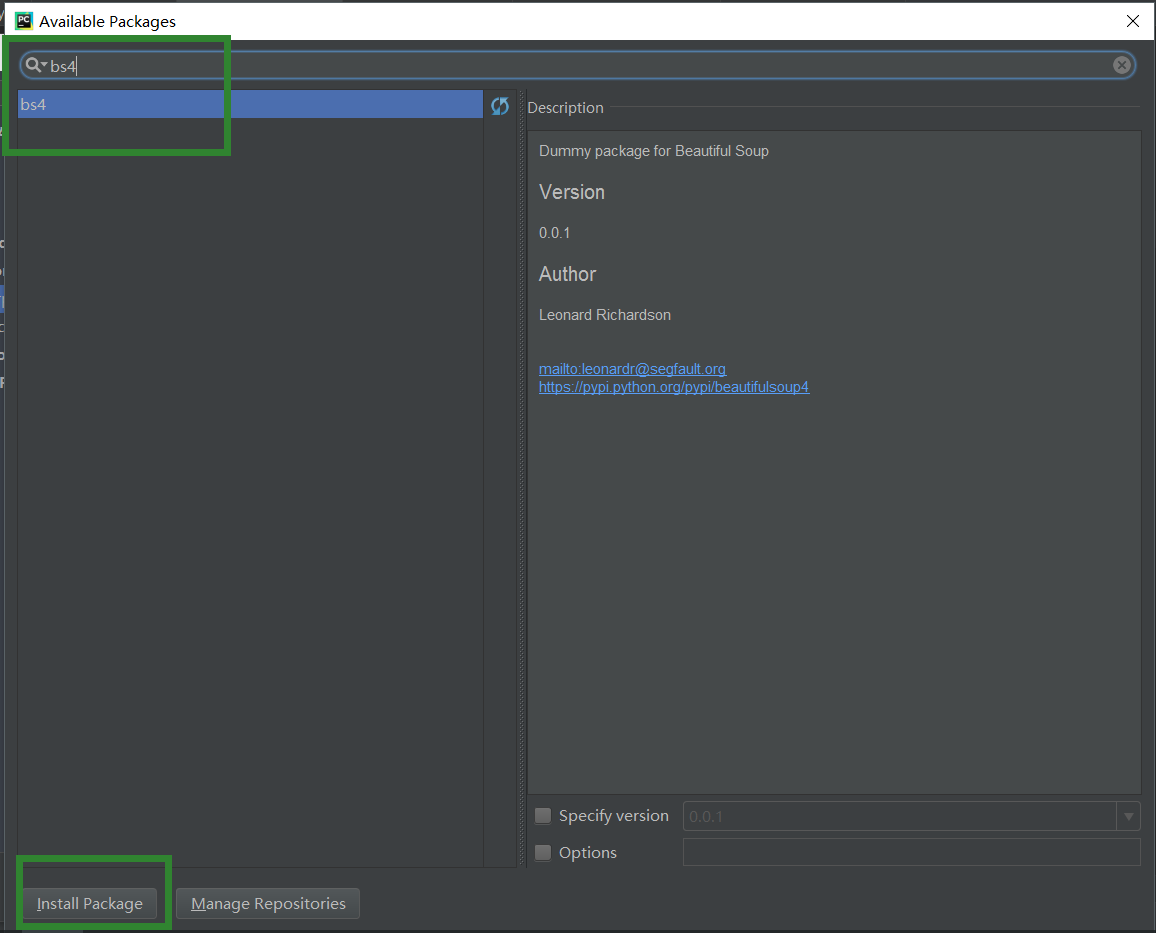
输入bs4选择bs4点击Install Packge进行下载
(2)编写爬虫调度程序
这里的bike_spider是项目名称引入的四个类分别对应下面的四段代码url管理器,url下载器,url解析器,url输出器。
# 爬虫调度程序
from bike_spider import url_manager, html_downloader, html_parser, html_outputer


# 爬虫初始化
class SpiderMain(object):
    def __init__(self):
        self.urls = url_manager.UrlManager()
        self.downloader = html_downloader.HtmlDownloader()
        self.parser = html_parser.HtmlParser()
        self.outputer = html_outputer.HtmlOutputer()

    def craw(self, my_root_url):
        count = 1
        self.urls.add_new_url(my_root_url)
        while self.urls.has_new_url():
            try:
                new_url = self.urls.get_new_url()
                print("craw %d : %s" % (count, new_url))
                # 下载网页
                html_cont = self.downloader.download(new_url)
                # 解析网页
                new_urls, new_data = self.parser.parse(new_url, html_cont)
                self.urls.add_new_urls(new_urls)
                # 网页输出器收集数据
                self.outputer.collect_data(new_data)
                if count == 10:
                    break
                count += 1
            except:
                print("craw failed")

        self.outputer.output_html()


if __name__ == "__main__":
    root_url = "http://baike.baidu.com/item/Python/407313"
    obj_spider = SpiderMain()
    obj_spider.craw(root_url)
(3)编写url管理器
我们把已经爬取过的url和未爬取的url分开存放以便我们不会重复爬取某些已经爬取过的网页。
# url管理器
class UrlManager(object):
    def __init__(self):
        self.new_urls = set()
        self.old_urls = set()

    def add_new_url(self, url):
        if url is None:
            return
        if url not in self.new_urls and url not in self.old_urls:
            self.new_urls.add(url)

    def add_new_urls(self, urls):
        if urls is None or len(urls) == 0:
            return
        for url in urls:
            self.new_urls.add(url)

    def get_new_url(self):
        # pop方法会帮我们获取一个url并且移除它
        new_url = self.new_urls.pop()
        self.old_urls.add(new_url)
        return new_url

    def has_new_url(self):
        return len(self.new_urls) != 0
(4)编写网页下载器
通过网络请求来下载页面
# 网页下载器
import urllib.request


class HtmlDownloader(object):

    def download(self, url):
        if url is None:
            return None
        response = urllib.request.urlopen(url)
        # code不为200则请求失败
        if response.getcode() != 200:
            return None
        return response.read()
(5)编写网页解析器
对网页进行解析时我们需要知道我们要查询的内容都有哪些特征,我们可以打开一个网页点击右键审查元素来了解我们所查内容的共同之处。
# 网页解析器
import re
from bs4 import BeautifulSoup
from urllib.parse import urljoin


class HtmlParser(object):

    def parse(self, page_url, html_cont):
        if page_url is None or html_cont is None:
            return
        soup = BeautifulSoup(html_cont, "html.parser", from_encoding="utf-8")
        new_urls = self._get_new_urls(page_url, soup)
        new_data = self._get_new_data(page_url, soup)
        return new_urls, new_data

    def _get_new_data(self, page_url, soup):
        res_data = {"url": page_url}
        # 获取标题
        title_node = soup.find("dd", class_="lemmaWgt-lemmaTitle-title").find("h1")
        res_data["title"] = title_node.get_text()
        summary_node = soup.find("div", class_="lemma-summary")
        res_data["summary"] = summary_node.get_text()
        return res_data

    def _get_new_urls(self, page_url, soup):
        new_urls = set()
        # 查找出所有符合下列条件的url
        links = soup.find_all("a", href=re.compile(r"/item/"))
        for link in links:
            new_url = link['href']
            # 获取到的url不完整,学要拼接
            new_full_url = urljoin(page_url, new_url)
            new_urls.add(new_full_url)
        return new_urls
(6)编写网页输出器
输出的格式有很多种,我们选择以html的形式输出,这样我们可以的到一个html页面。
# 网页输出器
class HtmlOutputer(object):

    def __init__(self):
        self.datas = []

    def collect_data(self, data):
        if data is None:
            return
        self.datas.append(data)

    # 我们以html表格形式进行输出
    def output_html(self):
        fout = open("output.html", "w", encoding='utf-8')
        fout.write("<html>")
        fout.write("<meta charset='utf-8'>")
        fout.write("<body>")
        # 以表格输出
        fout.write("<table>")
        for data in self.datas:
            # 一行
            fout.write("<tr>")
            # 每个单元行的内容
            fout.write("<td>%s</td>" % data["url"])
            fout.write("<td>%s</td>" % data["title"])
            fout.write("<td>%s</td>" % data["summary"])
            fout.write("</tr>")
        fout.write("</table>")
        fout.write("</body>")
        fout.write("</html>")
        # 输出完毕后一定要关闭输出器
        fout.close()
写在末尾
注意:网页经常发生变化,我们需要根据网页的变化动态修改我们的代码来获得我们所需要的内容。
这只是一个简单的网络爬虫,如果需要完善其功能我们需要考虑更多问题。
爬虫入门后可以看一下爬虫如何模拟登陆Python爬虫模拟登陆
发布者:全栈程序员-站长,转载请注明出处:https://javaforall.net/125456.html原文链接:https://javaforall.net


