
大家好,又见面了,我是你们的朋友全栈君。
最近面试经常遇到java集合类的问题,上网搜了一下,做个笔记
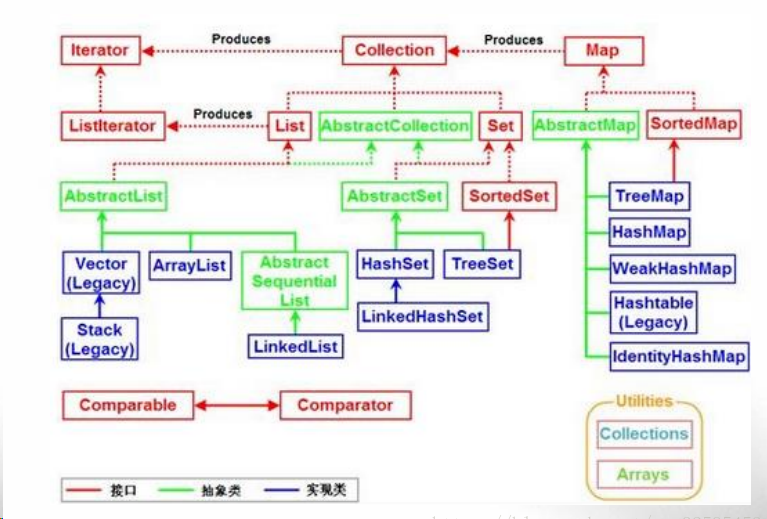

百度的图
集合类型主要有3种:set(集)、list(列表)和map(映射)。
集合接口分为:Collection和Map,list、set实现了Collection接口
List总结:
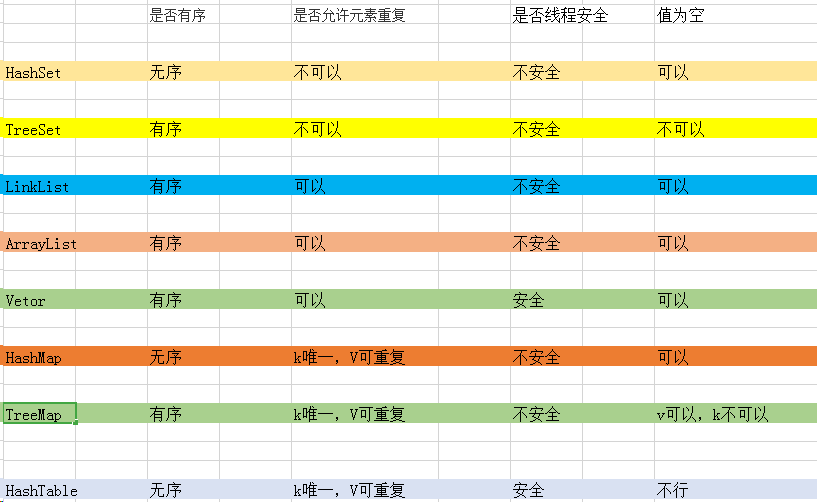
可以重复,通过索引取出加入数据,顺序与插入顺序一致,可以含有null元素
ArrayList:底层数据结构使数组结构array,查询速度快,增删改慢,因为是一种类似数组的形式进行存储,因此它的随机访问速度极快;
Vector:底层是数组结构array,与ArrayList相同,查询速度快,增删改慢;
LinkedList:底层使用链表结构,增删速度快,查询稍慢;
ArrayList与Vector的区别:
1.如果集合中的元素数量大于当前集合数组的长度时,Vector的增长率是目前数组长度的100%,而ArryaList增长率为目前数组长度的50%。所以,如果集合中使用数据量比较大的数据,用Vector有一定优势
2.线程同步ArrayList是线程不同步,所以Vector线程安全,但是因为每个方法都加上了synchronized,所以在效率上小于ArrayList
Set总结:
数据无序且唯一,实现类都不是线程安全的类,解决方案:Set set = Collections.sysnchronizedSet(Set对象);
HashSet:是Set接口(Set接口是继承了Collection接口的)最常用的实现类,顾名思义,底层是用了哈希表(散列/hash)算法。其底层其实也是一个数组,存在的意义是提供查询速度,插入的速度也是比较快,但是适用于少量数据的插入操作,判断两个对象是否相等的规则:1、equals比较为true;2、hashCode值相同。要求:要求存在在哈希表中的对象元素都得覆盖equals和hashCode方法。
LinkedHashSet:继承了HashSet类,所以它的底层用的也是哈希表的数据结构,但因为保持数据的先后添加顺序,所以又加了链表结构,但因为多加了一种数据结构,所以效率较低,不建议使用,如果要求一个集合急要保证元素不重复,也需要记录元素的先后添加顺序,才选择使用LinkedHashSet
TreeSet:Set接口的实现类,也拥有set接口的一般特性,但是不同的是他也实现了SortSet接口,它底层采用的是红黑树算法(红黑树就是满足一下红黑性质的二叉搜索树:①每个节点是黑色或者红色②根节点是黑色的③每个叶子结点是黑色的④如果一个节点是红色的,那么他的两个子节点是黑色的⑤对每个节点,从该节点到其所有的后代叶子结点的简单路径上,仅包含相同数目的黑色结点,红黑树是许多“平衡”搜索树的一种,可以保证在最坏情况下的基本操作集合的时间复杂度为O(lgn)。普及:二叉搜索树的性质:它或者是一棵空树;或者是具有下列性质的二叉树:若左子树不空,则左子树上所有结点的值均小于它的根结点的值;若右子树不空,则右子树上所有结点的值均大于它的根结点的值;左、右子树也分别为二叉排序树。若子树为空,查找不成功。),要注意的是在TreeSet集合中只能存储相同类型对象的引用。
Tree最重要的就是它的两种排序方式:自然排序和客户端排序
自然排序;实现了Comparable接口,所以TreeSet可以调用对象的ComparableTo()方法来比较集合的大小,然后进行升序排序,这种排序方式叫做自然排序。其中实现了Comparable接口的还有BigDecimal、BigInteger、Byte、Double、Float、Integer、Long、Short(按照数字大小排序)、Character(按照Unicode值的数字大小进行排序)String(按照字符串中字符的Unicode值进行排序)类等。
客户化排序:其实就是实现java.util.Comparator<Type>接口提供的具体的排序方式,<Type> 是具体要比较对象的类型,他有个compare的方法,如compare(x,y)返回值大于0表示x大于y,以此类推,当我们希望按照自己的想法排序的时候可以重写compare方法。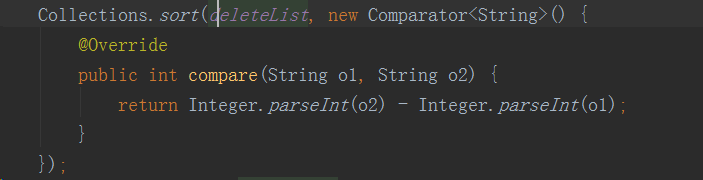
Map总结:
java的Map(映射)是一种把键对象和值对象进行映射的集合,其中每一个元素都包含了键对象和值对象,其中值对象也可以是Map类型的数据,因此,Map支持多级映射,Map中的键是唯一的,但值可以不唯一,Map集合有两种实现,一种是利用哈希表来完成的叫做HashMap,它和HashSet都是利用哈希表来完成的,区别其实就是在哈希表的每个桶中,HashSet只有key,而HashMap在每个key上挂了一个value;另一种就是TreeMap,它实现了SortMap接口,也就是使用了红黑树的数据结构,和TreeSet一样也能实现自然排序和客户化排序两种排序方式,而哈希表不提供排序。
HashMap:哈希表的实现原理中,先采用一个数组表示位桶,每个位桶的实现在1.8之前都是使用链表,但当每个位桶的数据较多的时候,链表查询的效率就会不高,因此在1.8之后,当位桶的数据超过阈值(8)的时候,就会采用红黑树来存储该位桶的数据(在阈值之前还是使用链表来进行存储),所以,哈希表的实现包括数组+链表+红黑树,在使用哈希表的集合中我们都认为他们的增删改查操作的时间复杂度都是O(1)的,不过常数项很大,因为哈希函数在进行计算的代价比较高,HashMap和Hashtable类似,不同之处在于HashMap是非同步的,并且允许null,即null value和null key。,但是将HashMap视为Collection时(values()方法可返回Collection),其迭代子操作时间开销和HashMap 的容量成比例。因此,如果迭代操作的性能相当重要的话,不要将HashMap的初始化容量设得过高,或者load factor过低。
TreeMap:TreeMap 是一个有序的key-value集合,它是通过红黑树实现的。TreeMap 继承于AbstractMap,所以它是一个Map,即一个key-value集合。TreeMap 实现了NavigableMap接口,意味着它支持一系列的导航方法。比如返回有序的key集合。TreeMap 实现了Cloneable接口,意味着它能被克隆。TreeMap 实现了java.io.Serializable接口,意味着它支持序列化。
TreeMap基于红黑树(Red-Black tree)实现。该映射根据其键的自然顺序进行排序,或者根据创建映射时提供的 Comparator 进行排序,具体取决于使用的构造方法。TreeMap的基本操作 containsKey、get、put 和 remove 的时间复杂度是 log(n) 。另外,TreeMap是非同步的。 它的iterator 方法返回的迭代器是fail-fastl的。
HashTable:Hashtable继承Map接口,实现一个key-value映射的哈希表。任何非空(non-null)的对象都可作为key或者value,线程安全。
发布者:全栈程序员-站长,转载请注明出处:https://javaforall.net/133411.html原文链接:https://javaforall.net



