
大家好,又见面了,我是你们的朋友全栈君。
1.安装准备
jdk-8u162-linux-x64.tar
zookeeper-3.4.12.tar.gz
kafka_2.11-2.0.0 .tgz
2.准备至少三台虚拟机
192.168.196.128
192.168.196.131
192.168.196.132
3.Java环境安装
(略…自行百度)
4.搭建zookeeper集群
在每台主机下执行以下步骤:
移动至/usr/local下:
mv zookeeper-3.4.12.tar.gz /usr/local
解压,重命名:
tar -zxvf zookeeper-3.4.12.tar.gz
mv zookeeper-3.4.12 zookeeper
配置环境变量:
vim /etc/profile
追加以下内容:
#set zookeeper environment
export ZK_HOME=/usr/local/zookeeper
export PATH=$ZK_HOME/bin:$PATH
保存文件后,使修改生效:
source /etc/profile
打开zookeeper配置文件:
cp /usr/local/zookeeper/conf/zoo_sample.cfg /usr/local/zookeeper/conf/zoo.cfg
vim /usr/local/zookeeper/zoo.cfg
修改zookeeper配置文件:
#修改数据文件夹路径
dataDir=/usr/local/zookeeper/data
#在文件末尾添加
server.1=192.168.196.128:2888:3888
server.2=192.168.196.131:2888:3888
server.3=192.168.196.132:2888:3888
创建数据文件夹和myid文件:
mkdir /usr/local/zookeeper/data
touch /usr/local/zookeeper/data/myid
分别在各个机器添加myid信息:
echo "1" > /usr/local/zookeeper/data/myid #kafka-1 192.168.196.128
echo "2" > /usr/local/zookeeper/data/myid #kafka-1 192.168.196.131
echo "3" > /usr/local/zookeeper/data/myid #kafka-1 192.168.196.132
分别在各个机器启动zookeeper:
/usr/local/zookeeper/bin/zkServer.sh start
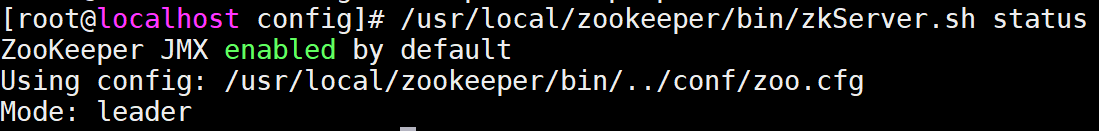
全部启动后查看状态:
/usr/local/zookeeper/bin/zkServer.sh status
显示如下则zookeeper集群搭建成功:

5.搭建kafka集群
在每台主机下执行以下步骤:
移动至/usr/local下:
mv kafka_2.11-2.0.0 .tgz /usr/local
解压,重命名:
tar -zxvf kafka_2.11-2.0.0 .tgz
mv kafka_2.11-2.0.0 kafka
配置环境变量:
vim /etc/profile
追加以下内容:
#set kafka environment
export KAFKA_HOME=/usr/local/kafka
export PATH=${KAFKA_HOME}/bin:$PATH
保存文件后,使修改生效:
source /etc/profile
修改server.properties配置文件:
vim /usr/local/kafka/config/server.properties
在kafka-1主机中:
#修改
broker.id=1
listeners=PLAINTEXT://192.168.196.128:9092
zookeeper.connect=192.168.196.128:2181,192.168.196.131:2181,192.168.196.132:2181
offsets.topic.replication.factor=3
在kafka-2主机中:
#修改
broker.id=2
listeners=PLAINTEXT://192.168.196.131:9092
zookeeper.connect=192.168.196.128:2181,192.168.196.131:2181,192.168.196.132:2181
offsets.topic.replication.factor=3
在kafka-3主机中:
#修改
broker.id=3
listeners=PLAINTEXT://192.168.196.132:9092
zookeeper.connect=192.168.196.128:2181,192.168.196.131:2181,192.168.196.132:2181
offsets.topic.replication.factor=3
在每台机器上分别启动kafka
/usr/local/kafka/bin/kafka-server-start.sh -daemon config/server.properties
(测试)在其中一台机器上创建topic:
/usr/local/kafka/bin/kafka-topics.sh --create --zookeeper 192.168.196.128:2181,192.168.196.131:2181,192.168.196.132:2181 --replication-factor 3 --partitions 3 --topic test-topic
(测试)查看创建的topic信息:
/usr/local/kafka/bin/kafka-topics.sh --describe --zookeeper 192.168.196.128:2181,192.168.196.131:2181,192.168.196.132:2181 --topic test-topic
(测试)选其中一台机器创建生产者:
bin/kafka-console-producer.sh --broker-list 192.168.196.128:9092 -topic test-topic
(测试)另外两台机器创建消费者:
bin/kafka-console-consumer.sh --bootstrap-server 192.168.196.128:9092,192.168.196.131:9092,192.168.196.132:9092 --topic test-topic2 --from-beginning
尝试发送消息,收到则部署成功!
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容, 请发送邮件至 举报,一经查实,本站将立刻删除。
发布者:全栈程序员-站长,转载请注明出处:https://javaforall.net/134087.html原文链接:https://javaforall.net



