
大家好,又见面了,我是你们的朋友全栈君。
使用爬虫时,大部分网站都有一定的反爬措施,有些网站会限制每个 IP 的访问速度或访问次数,超出了它的限制你的 IP 就会被封掉。对于访问速度的处理比较简单,只要间隔一段时间爬取一次就行了,避免频繁访问;而对于访问次数,就需要使用代理 IP 来帮忙了,使用多个代理 IP 轮换着去访问目标网址可以有效地解决问题。
目前网上有很多的代理服务网站提供代理服务,也提供一些免费的代理,但可用性较差,如果需求较高可以购买付费代理,可用性较好。
因此我们可以自己构建代理池,从各种代理服务网站中获取代理 IP,并检测其可用性(使用一个稳定的网址来检测,最好是自己将要爬取的网站),再保存到数据库中,需要使用的时候再调用。
代码地址:https://github.com/Stevengz/Proxy_pool
另外三篇:
Python搭建代理IP池(二)- 存储 IP
Python搭建代理IP池(三)- 检测 IP
Python搭建代理IP池(四)- 接口设置与整体调度
本文介绍的则是构建代理 IP 池的第一步:获取 IP
使用的库:requests、pyquery
几个能提供免费代理的代理服务网站(排名不分先后):
| 厂商名称 | 地址 |
|---|---|
| 66代理 | http://www.66ip.cn/ |
| 西刺代理 | https://www.xicidaili.com |
| 全网代理 | http://www.goubanjia.com |
| 云代理 | http://www.ip3366.net |
| IP海 | http://www.iphai.com |
| 快代理 | https://www.kuaidaili.com |
| 免费代理IP库 | http://ip.jiangxianli.com |
代理服务网站 Crawler
代理获取的相关代码,把从每个网站提取 IP 的方法都放到一起,然后运行时只要调用相关方法即可
为了实现灵活,将获取代理的一个个方法统一定义一个规范,如统一定义以 crawl 开头,这样扩展的时候只需要添加 crawl 开头的方法即可
在这里实现了几个示例,如抓取代理 66、西刺代理、云代理、快代理 四个免费代理网站,这些方法都定义成生成器,通过 yield 返回。首先将网页获取,然后用 PyQuery 解析,解析出 IP 加端口形式的代理再返回
crawler.py
import json
import re
from utils import get_page
from pyquery import PyQuery as pq

# 元类
class ProxyMetaclass(type):
    def __new__(cls, name, bases, attrs):
        count = 0
        attrs['__CrawlFunc__'] = []
        for k, v in attrs.items():
            if 'crawl_' in k:
                attrs['__CrawlFunc__'].append(k)
                count += 1
        attrs['__CrawlFuncCount__'] = count
        return type.__new__(cls, name, bases, attrs)

class Crawler(object, metaclass=ProxyMetaclass):
    def get_proxies(self, callback):
        proxies = []
        for proxy in eval("self.{}()".format(callback)):
            print('成功获取到代理', proxy)
            proxies.append(proxy)
        return proxies

    def crawl_daili66(self, page_count=4):
        start_url = 'http://www.66ip.cn/{}.html'
        urls = [start_url.format(page) for page in range(1, page_count + 1)]
        for url in urls:
            print('Crawling', url)
            html = get_page(url)
            if html:
                doc = pq(html)
                trs = doc('.containerbox table tr:gt(0)').items()
                for tr in trs:
                    ip = tr.find('td:nth-child(1)').text()
                    port = tr.find('td:nth-child(2)').text()
                    yield ':'.join([ip, port])

    def crawl_xicidaili(self):
        for i in range(1, 3):
            start_url = 'http://www.xicidaili.com/nn/{}'.format(i)
            headers = {

                'Accept':'text/html,application/xhtml+xml,application/xml;q=0.9,image/webp,image/apng,*/*;q=0.8',
                'Host':'www.xicidaili.com',
                'Referer':'http://www.xicidaili.com/nn/3',
                'Upgrade-Insecure-Requests':'1',
            }
            html = get_page(start_url, options=headers)
            if html:
                find_trs = re.compile('<tr class.*?>(.*?)</tr>', re.S)
                trs = find_trs.findall(html)
                for tr in trs:
                    find_ip = re.compile('<td>(\d+\.\d+\.\d+\.\d+)</td>')
                    re_ip_address = find_ip.findall(tr)
                    find_port = re.compile('<td>(\d+)</td>')
                    re_port = find_port.findall(tr)
                    for address,port in zip(re_ip_address, re_port):
                        address_port = address+':'+port
                        yield address_port.replace(' ','')

    def crawl_ip3366(self):
        for i in range(1, 4):
            start_url = 'http://www.ip3366.net/?stype=1&page={}'.format(i)
            html = get_page(start_url)
            if html:
                find_tr = re.compile('<tr>(.*?)</tr>', re.S)
                trs = find_tr.findall(html)
                for s in range(1, len(trs)):
                    find_ip = re.compile('<td>(\d+\.\d+\.\d+\.\d+)</td>')
                    re_ip_address = find_ip.findall(trs[s])
                    find_port = re.compile('<td>(\d+)</td>')
                    re_port = find_port.findall(trs[s])
                    for address,port in zip(re_ip_address, re_port):
                        address_port = address+':'+port
                        yield address_port.replace(' ','')

    def crawl_kuaidaili(self):
        for i in range(1, 4):
            start_url = 'http://www.kuaidaili.com/free/inha/{}/'.format(i)
            html = get_page(start_url)
            if html:
                ip_address = re.compile('<td data-title="IP">(.*?)</td>')
                re_ip_address = ip_address.findall(html)
                port = re.compile('<td data-title="PORT">(.*?)</td>')
                re_port = port.findall(html)
                for address,port in zip(re_ip_address, re_port):
                    address_port = address+':'+port
                    yield address_port.replace(' ','')
定义了一个 ProxyMetaclass,Crawl 类将它设置为元类,元类中实现了 new() 方法,遍历 attrs 变量即可获取类的所有方法信息,判断方法名前面是否是 crawl,是则将其加入到 CrawlFunc 属性中
代理网站的添加非常灵活,不仅可以添加免费代理,也可以添加付费代理,一些付费代理的提取方式类似,也通过 Web 的形式获取再进行解析,解析方式可能更加简单,如解析纯文本或 Json,解析之后以同样的方式返回,可以自行扩展
utils.py
import requests
from requests.exceptions import ConnectionError

base_headers = {

    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/77.0.3865.120 Safari/537.36',
    'Accept-Encoding': 'gzip, deflate, sdch',
    'Accept-Language': 'en-US,en;q=0.9,zh-CN;q=0.8,zh;q=0.7'
}

def get_page(url, options={
   }):

    headers = dict(base_headers, **options)
    print('正在抓取', url)
    try:
        response = requests.get(url, headers=headers)
        print('抓取成功', url, response.status_code)
        if response.status_code == 200:
            return response.text
    except ConnectionError:
        print('抓取失败', url)
        return None
抓取网页内容的方法,访问链接成功后返回整个网页 HTML 内容,便于后续对网页具体内容的提取。封装成一个方法,让上面的 crawler 在抓取各个网站时调用
进行抓取
getter.py
from crawler import Crawler
from setting import *
import sys

class Getter():
    def __init__(self):
        self.crawler = Crawler()

    def run(self):
        print('获取器开始执行')
        for callback_label in range(self.crawler.__CrawlFuncCount__):
            callback = self.crawler.__CrawlFunc__[callback_label]
            # 获取代理
            all_ip = self.crawler.get_proxies(callback)

if __name__ == '__main__':
    get = Getter()
    get.run()
运行结果:
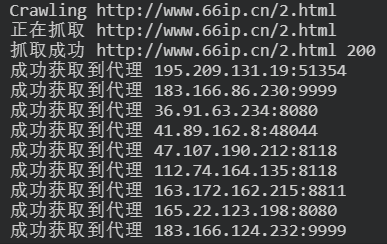

网站上的免费 IP 就被成功抓取下来了,至于能不能用,就有待验证了
整个过程其实就是一个普通的爬虫,而且没什么反爬措施,能到用代理 IP 的地步,代码里面的访问、抓取部分的细节应该都看得懂
发布者:全栈程序员-站长,转载请注明出处:https://javaforall.net/135292.html原文链接:https://javaforall.net



