神经网络的反向传播算法推导

神经网络的反向传播算法推导有了上一篇神经网络的反向传播算法推导—前期知识准备做铺垫,下一步来看看反向传播算法具体的推导过程。一、定义机器学习中常说的两个函数:损失函数(lossfunction):是定义在单个样本上的,算的是一个样本的值和预测值的误差,记为C(Θ);代价函数(costfunction):是定义在整个训练集上的,是所有样本误差的平均,也就是损失函数的平均,记为J(Θ);假设函数:二、神经网络结构图以三层神经网络为例:…

大家好,又见面了,我是你们的朋友全栈君。

目录

一、定义

二、神经网络结构图

三、反向传播算法的四个公式推导


        有了上一篇  神经网络的反向传播算法推导 — 前期知识准备  做铺垫,下一步来看看反向传播算法具体的推导过程。

一、定义

机器学习中常说的两个函数:

损失函数 (loss function):是定义在单个样本上的,算的是一个样本的值和预测值的误差,记为C(Θ);

代价函数 (cost function):是定义在整个训练集上的,是所有样本误差的平均,也就是损失函数的平均,记为J(Θ);

假设函数:h_{\theta }(x) = g(z^{l}) = g(\Theta^{l} x)

[变量定义]

s_{l} : 表示神经网络第 l 层神经元的个数

s_{L}:表示神经网络最终输出的类别数(L表示最后一层)

i:\theta 的尺寸/维度的列,第 i 列

j:\theta 的尺寸/维度的行,第 j 行

二、神经网络结构图

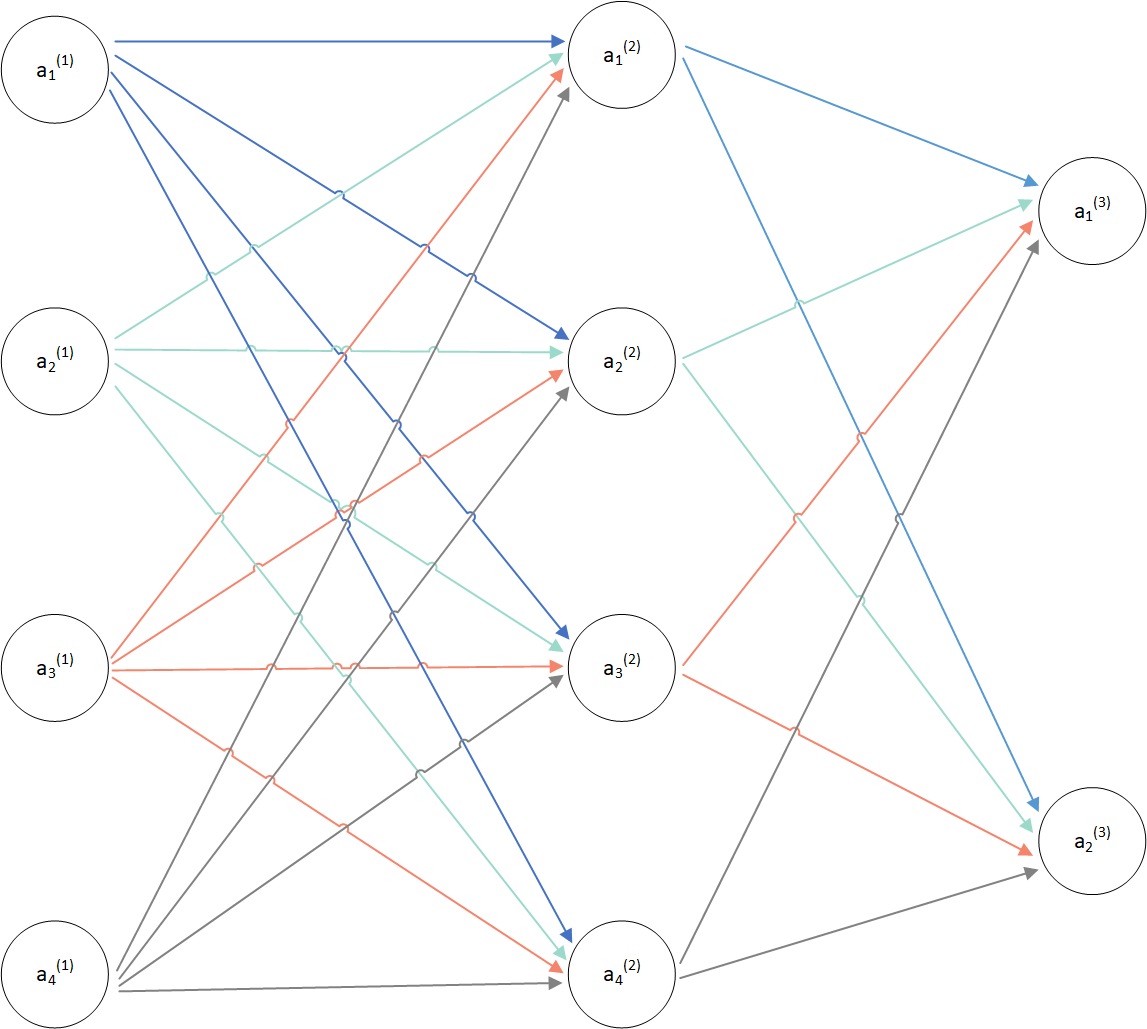
以三层神经网络为例:

神经网络的反向传播算法推导

                                                                (图1)

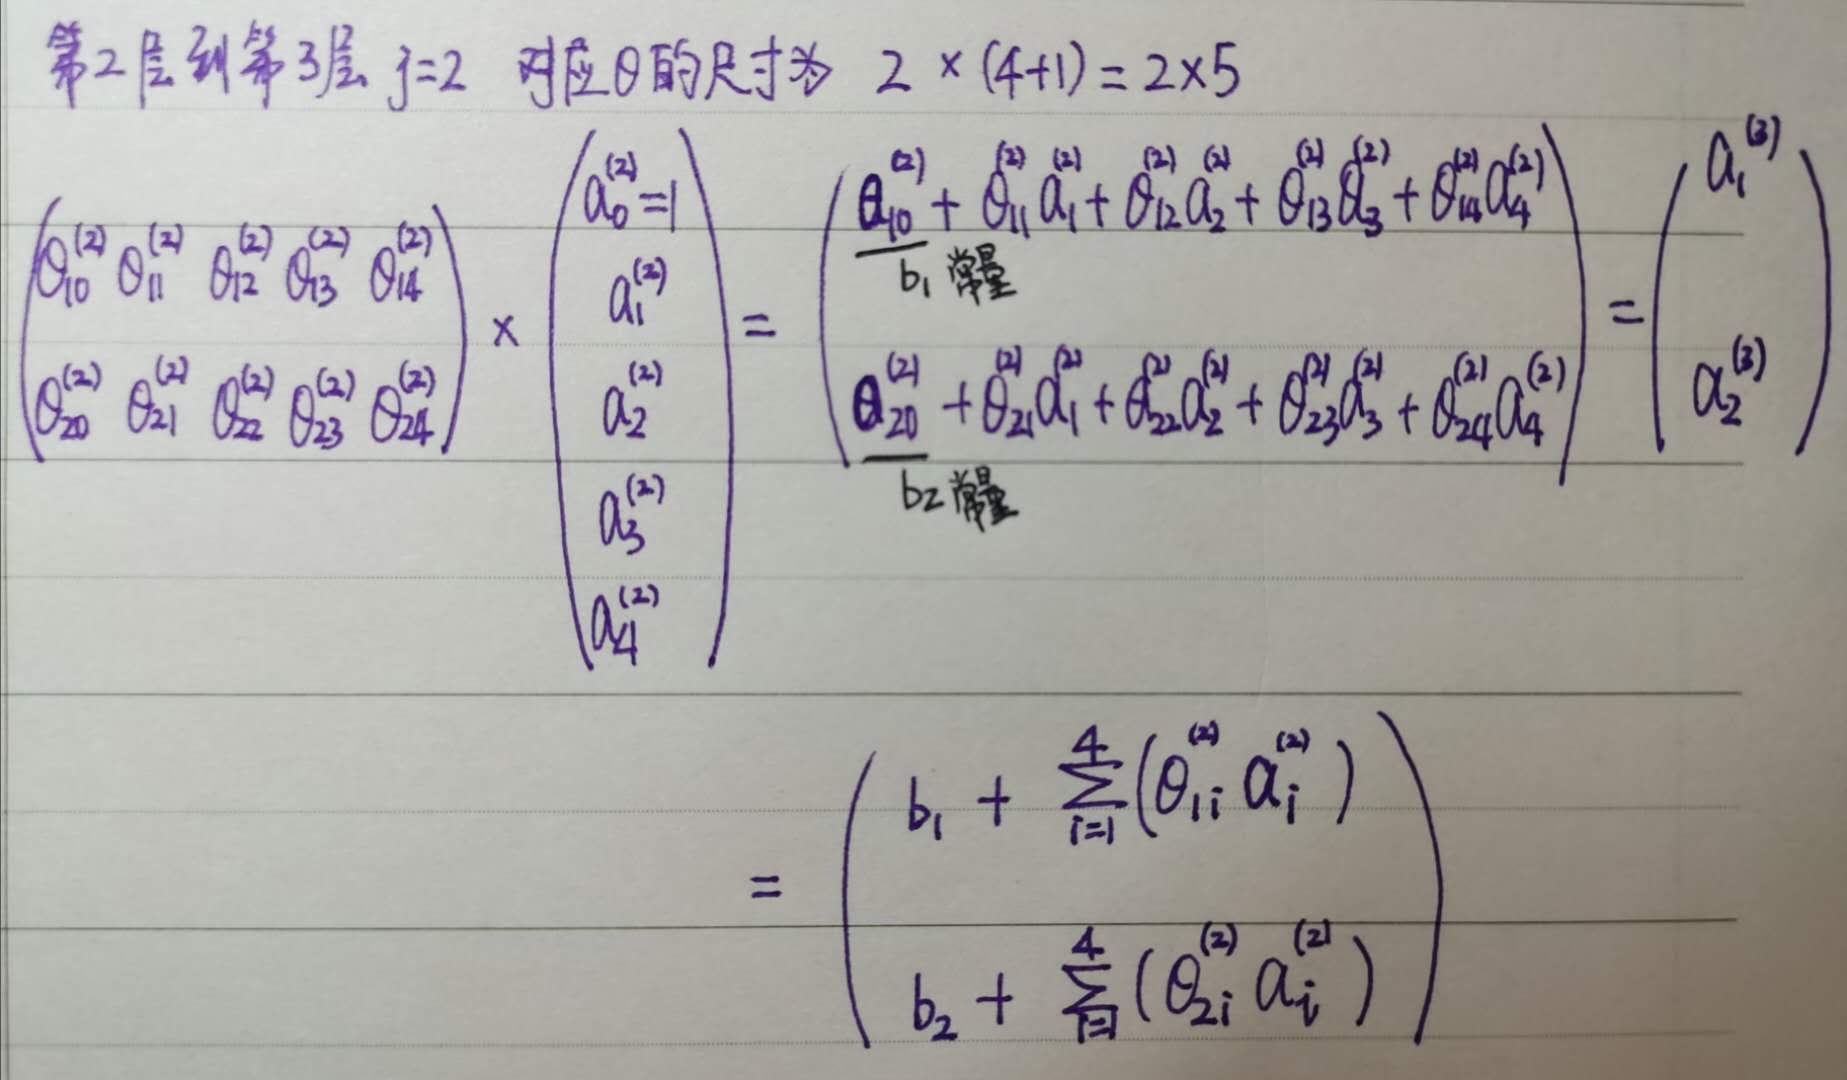
上图按照神经网络的计算方法(如不清楚的请参考文章 从逻辑回归到神经网络):
神经网络的反向传播算法推导

                                                                (图2)

说明:图2中将 \theta _{10}^{(2)} 、\theta _{20}^{(2)} 标为”常量“,有些欠妥,总之意思就是与 a_{j}^{(2)} 无关。

在计算图中可表示如下( 损失函数计算方式有多种,假设我们使用最小化误差函数   \frac{1}{2} \sum_{i=1}^{n} (f(x_{i}) - y_{i})^{2}    ):

这里为什么不是平方误差损失函数  \frac{1}{2m} \sum_{i=1}^{m} (f(x_{i}) - y_{i})^{2}  ,我的理解是在神经网络在计算损失函数时 i 从1到 n对应的是一个样本的多个特征属性,而不是多个样本,因此无需求和后除以m.

三、反向传播算法的四个公式推导

先抛出反向传播算法的四个公式:

\delta ^{L} = \bigtriangledown _{a} C \odot g^{'}(z^{L})         ——————– BP1

\delta ^{l} = ( (\theta ^{l})^{T} \delta ^{l+1} ) \odot g^{'}(z^{l}) ——————- BP2 

\frac{\partial C}{ \partial b_{j}^{l}} = \delta _{j}^{l+1}  ————————————– BP3

\frac{ \partial C }{ \partial \theta_{ji}^{l} } = a_{i}^{l} \delta _{j}^{l+1}  ———————————- BP4

(说明:其中,

BP2有的定义为:\delta ^{l} = ( (w ^{l+1})^{T} \delta ^{l+1} ) \odot g^{'}(z^{l}) 

BP3有的定义为:\frac{\partial C}{ \partial b_{j}^{l}} = \delta _{j}^{l}

BP4有的定义为:\frac{ \partial C }{ \partial \Theta_{jk}^{l} } = a_{k}^{l-1} \delta _{j}^{l}

主要是层数 l 的定义不同,和变量命名不同,本质一样的。

)

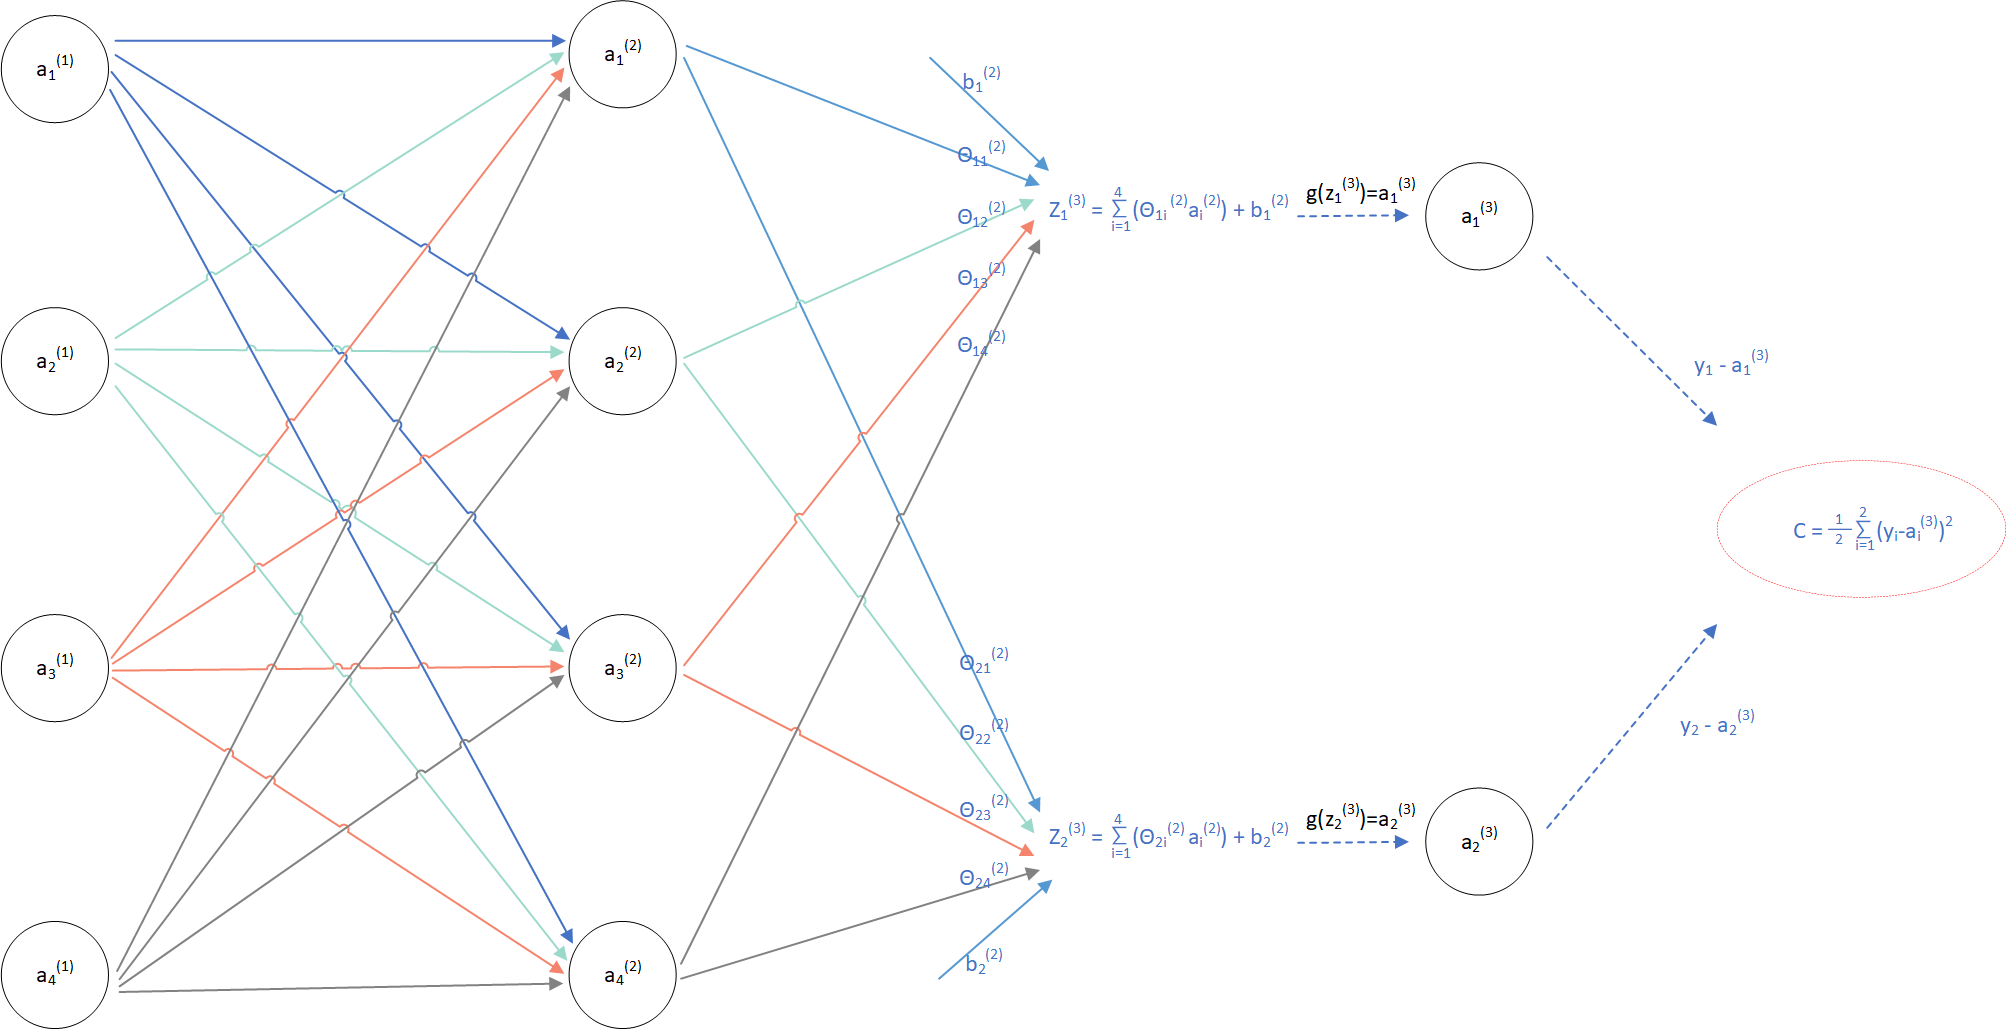
下面用计算图的方式逐一推导(依然以三层神经网络开头):
神经网络的反向传播算法推导


                                                              (图3)

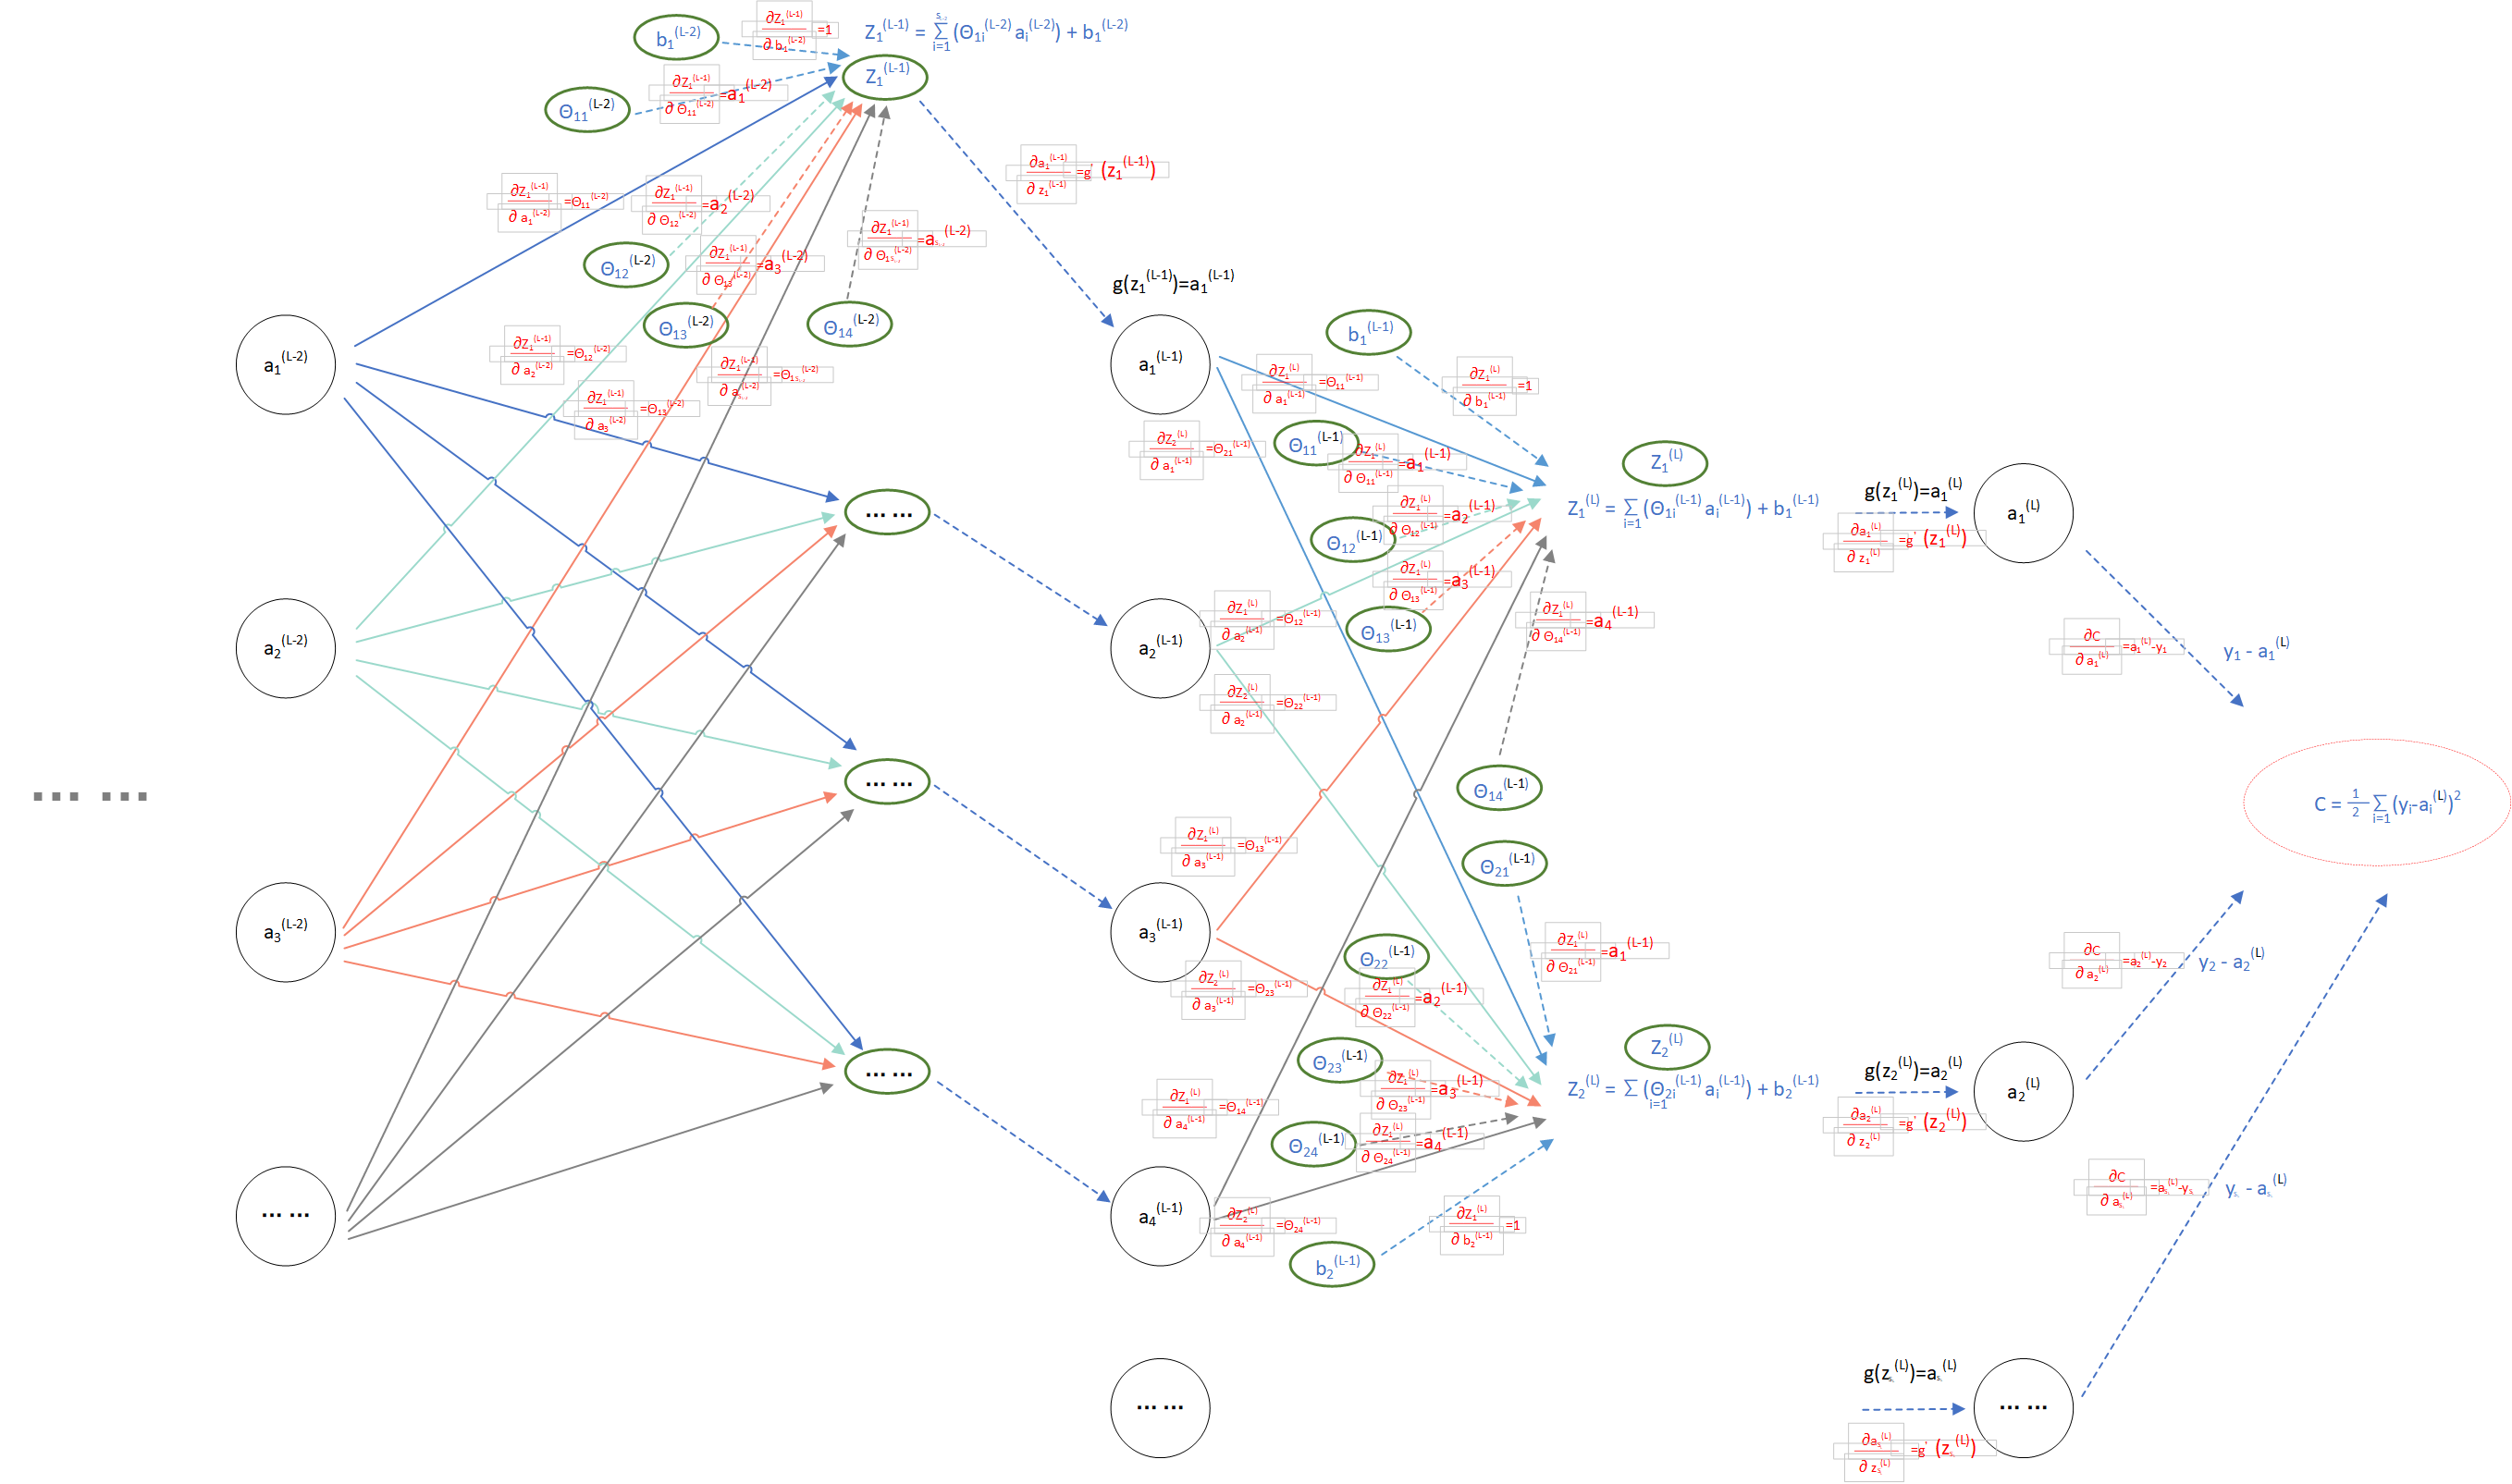
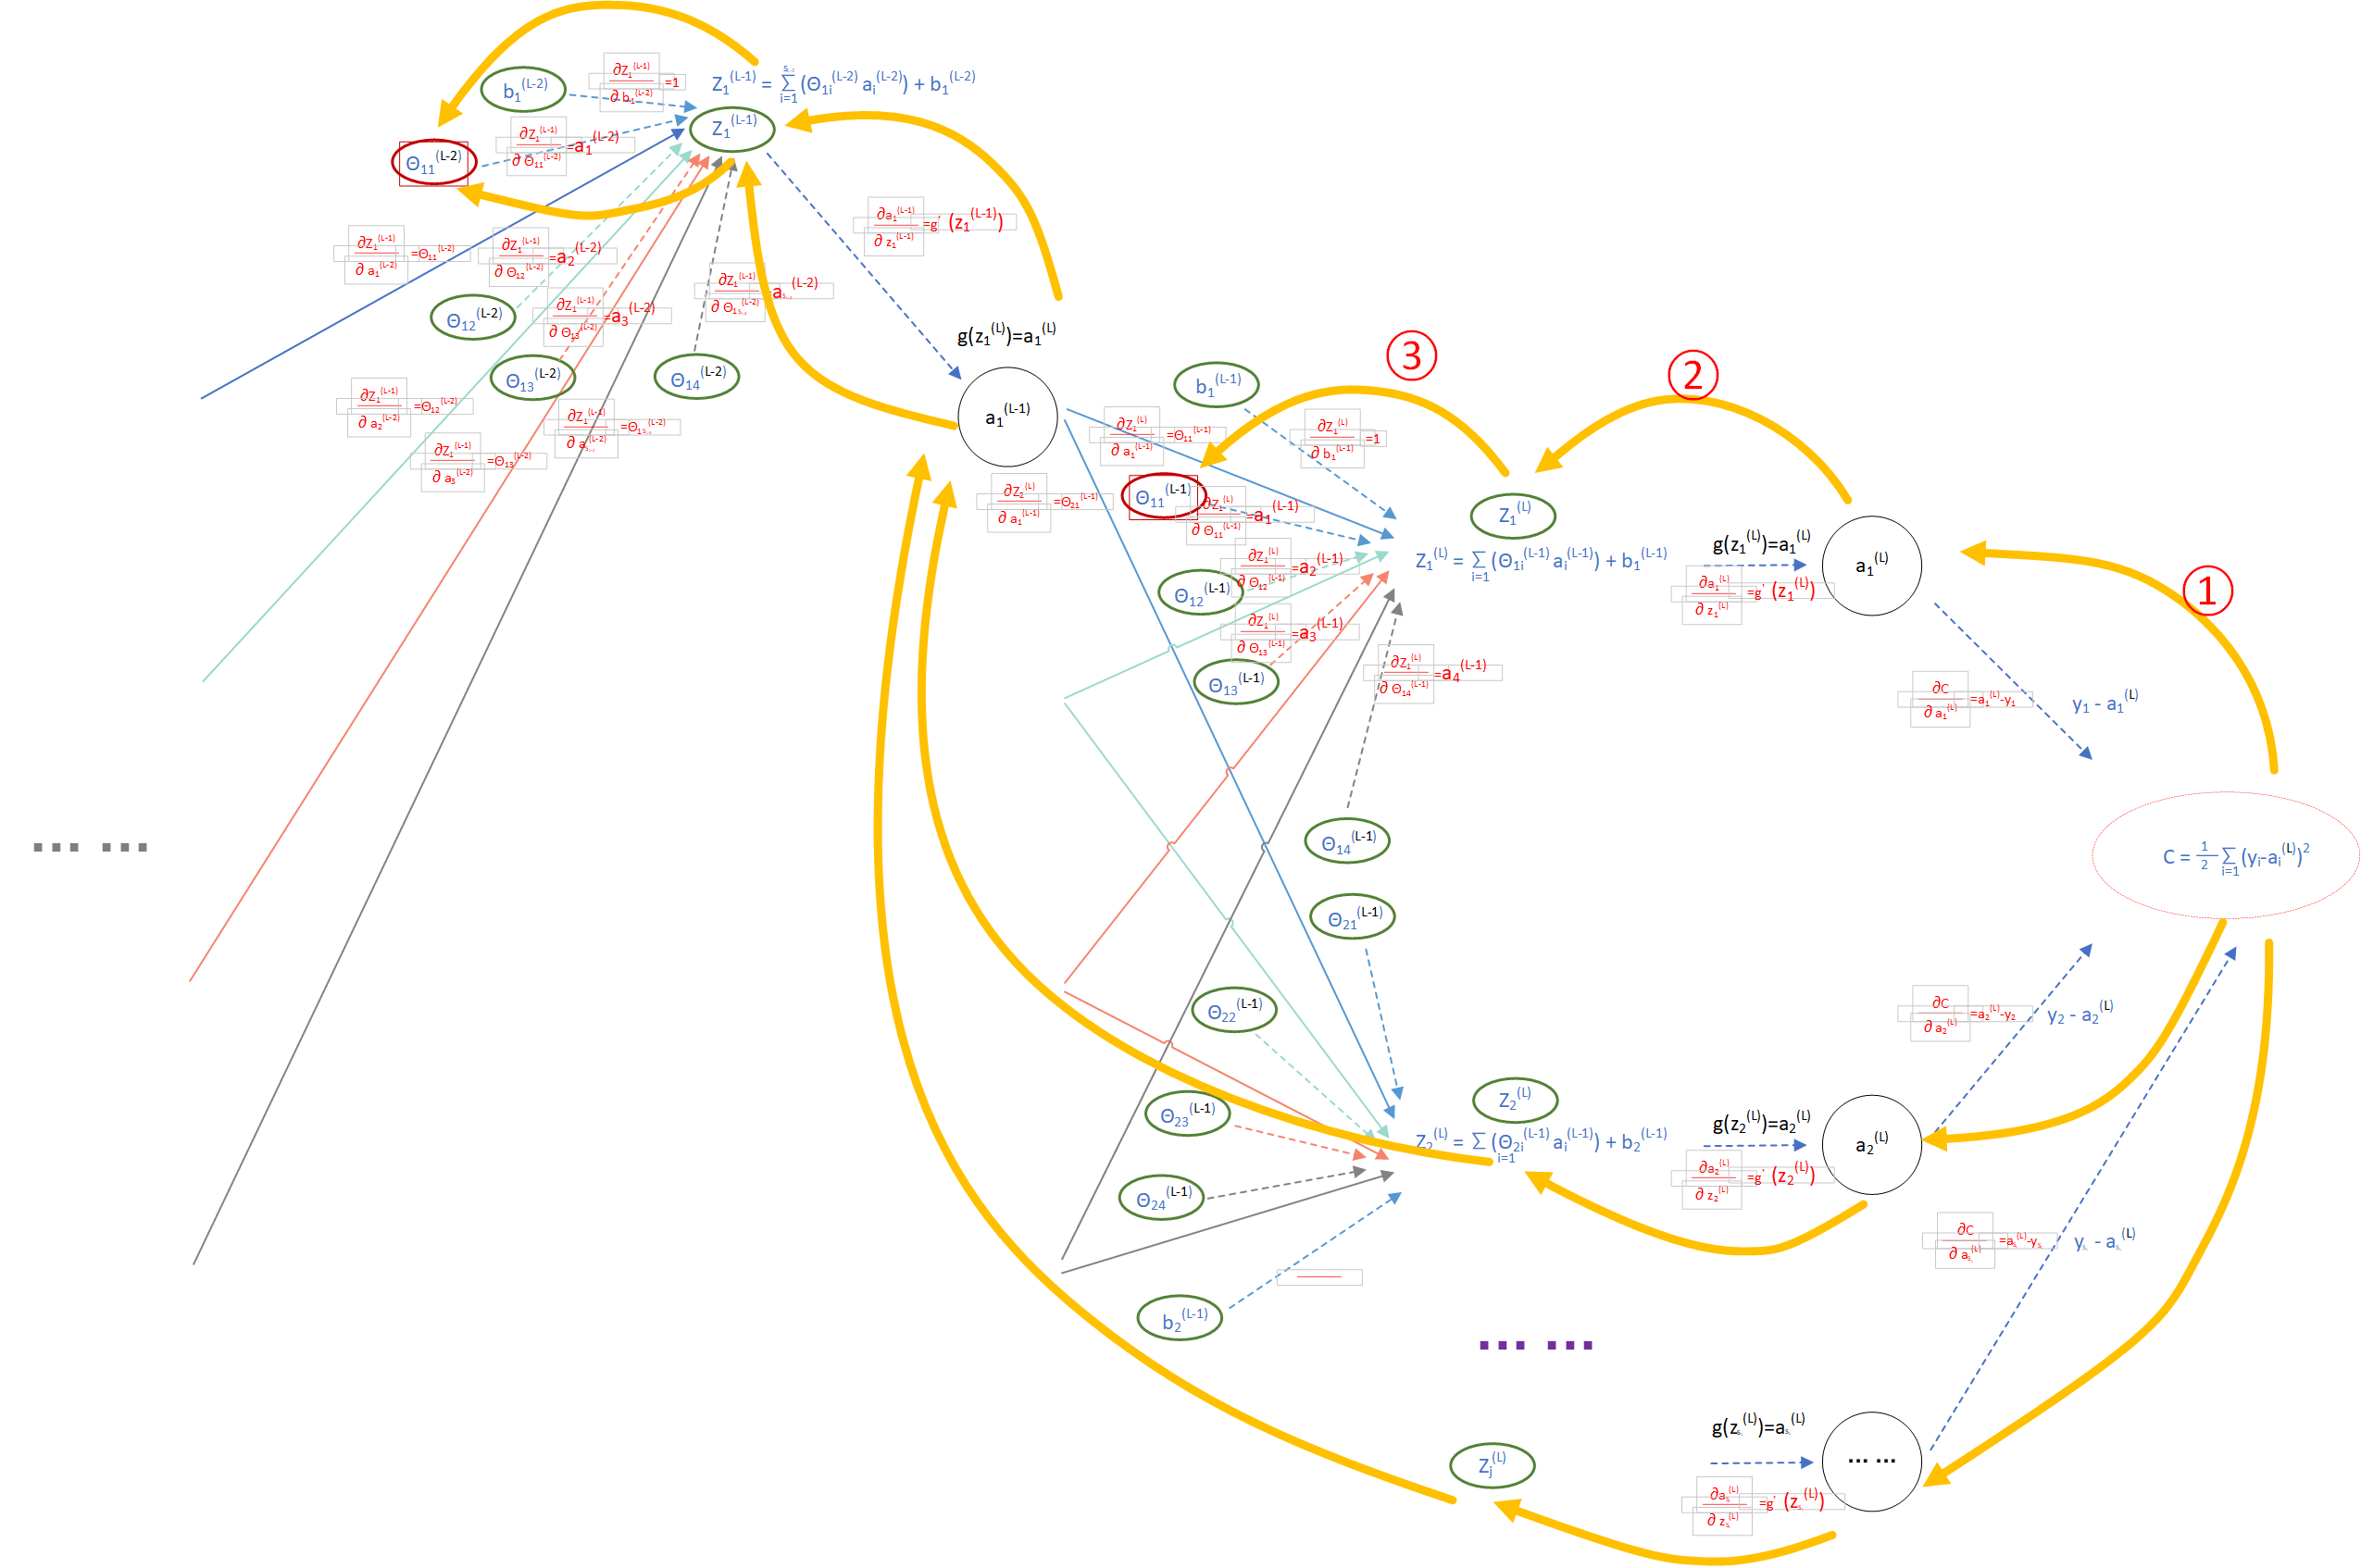
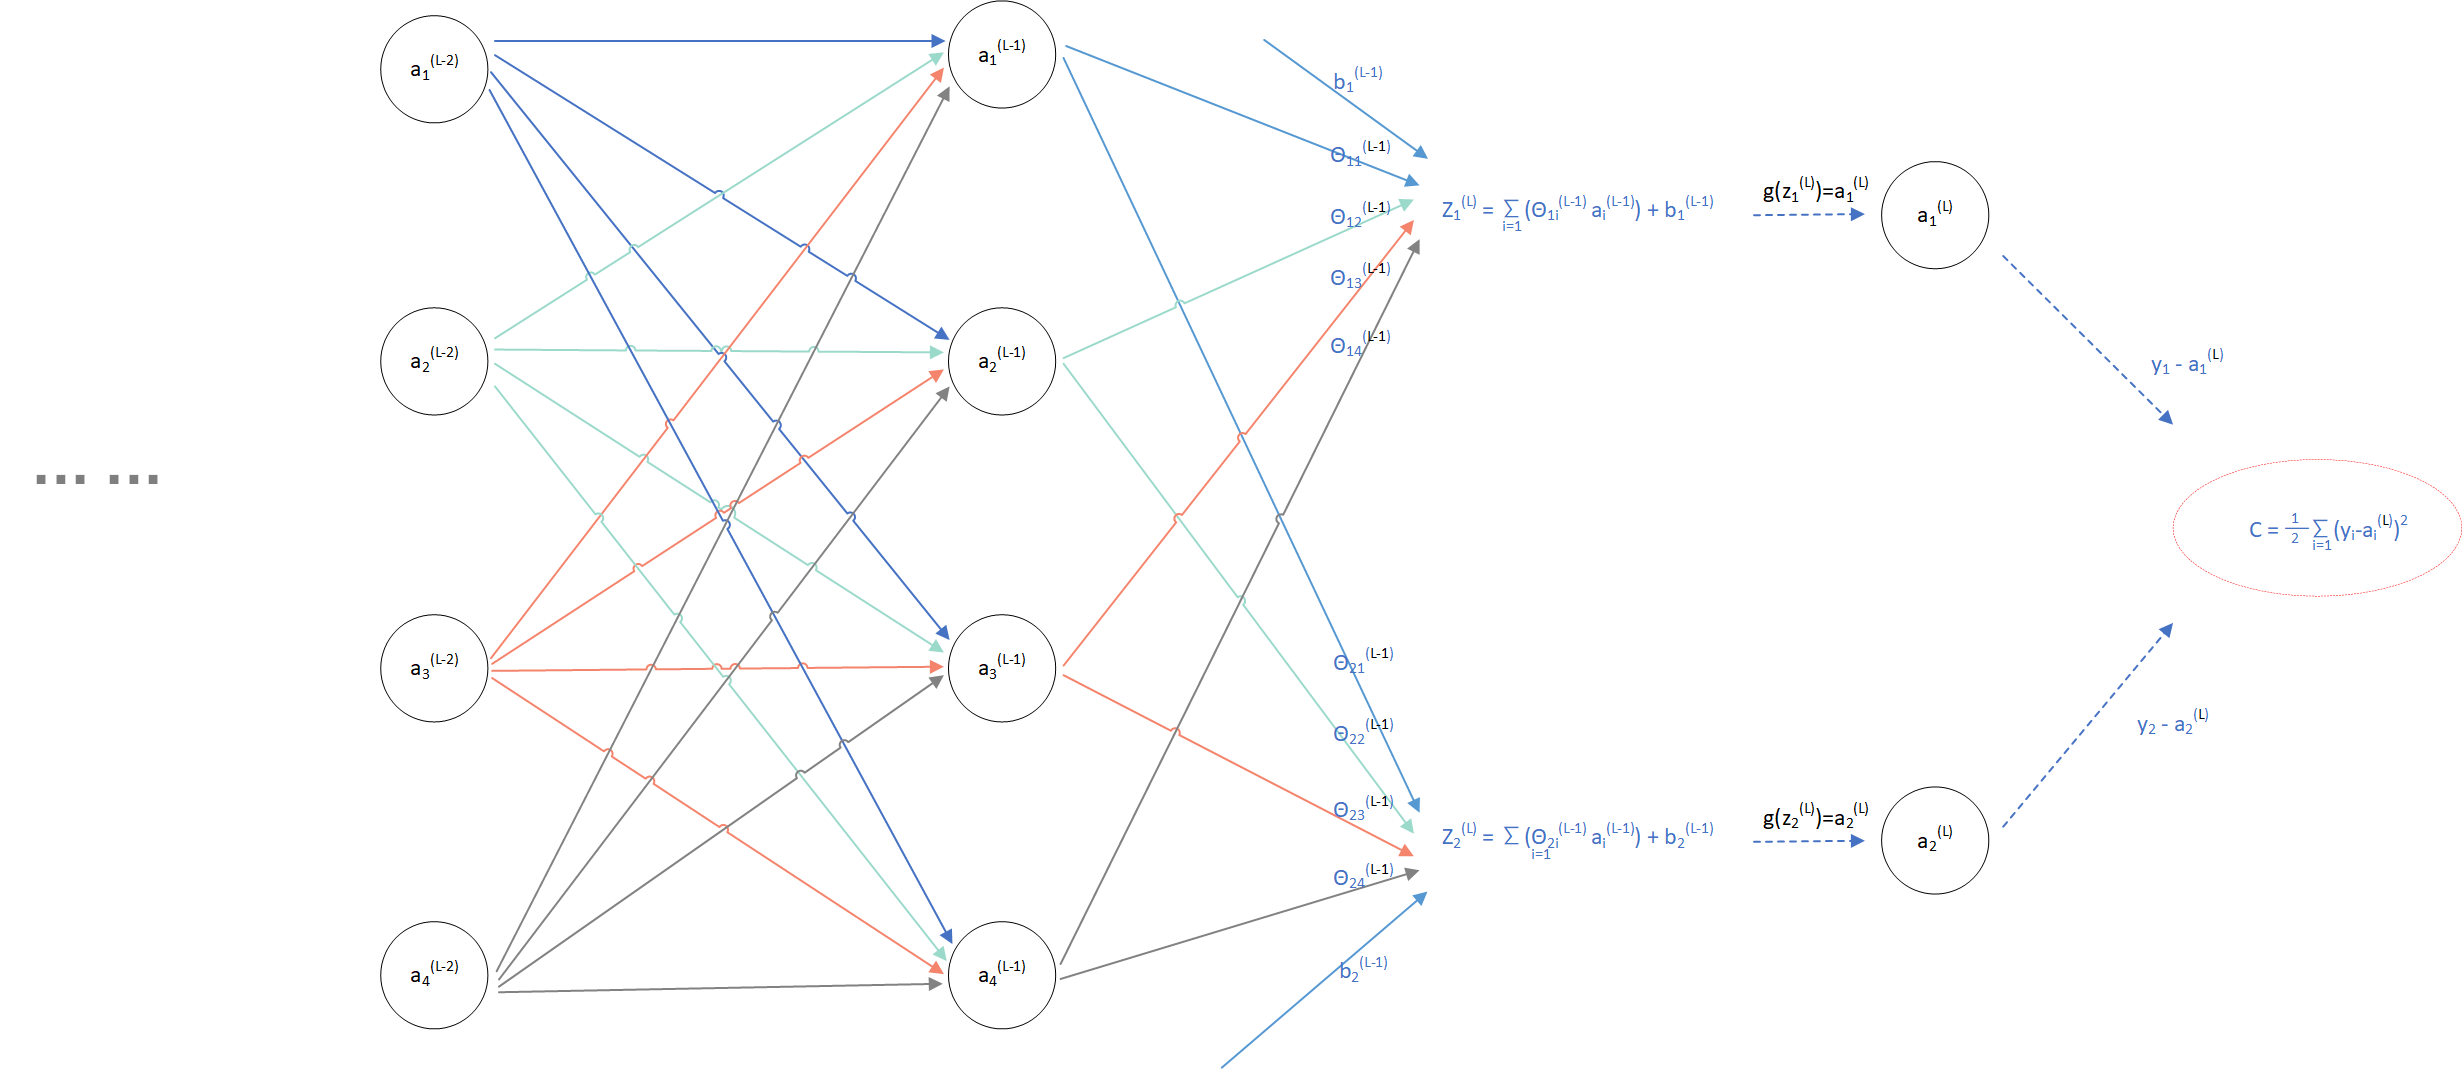
由三层神经网络推广到L层,我们从L-1层开始计算,则计算图如下:
神经网络的反向传播算法推导

                                                                (图4)

为了方便对图中路径进行求导(计算权重),所以补充了节点虚线,类似如下:
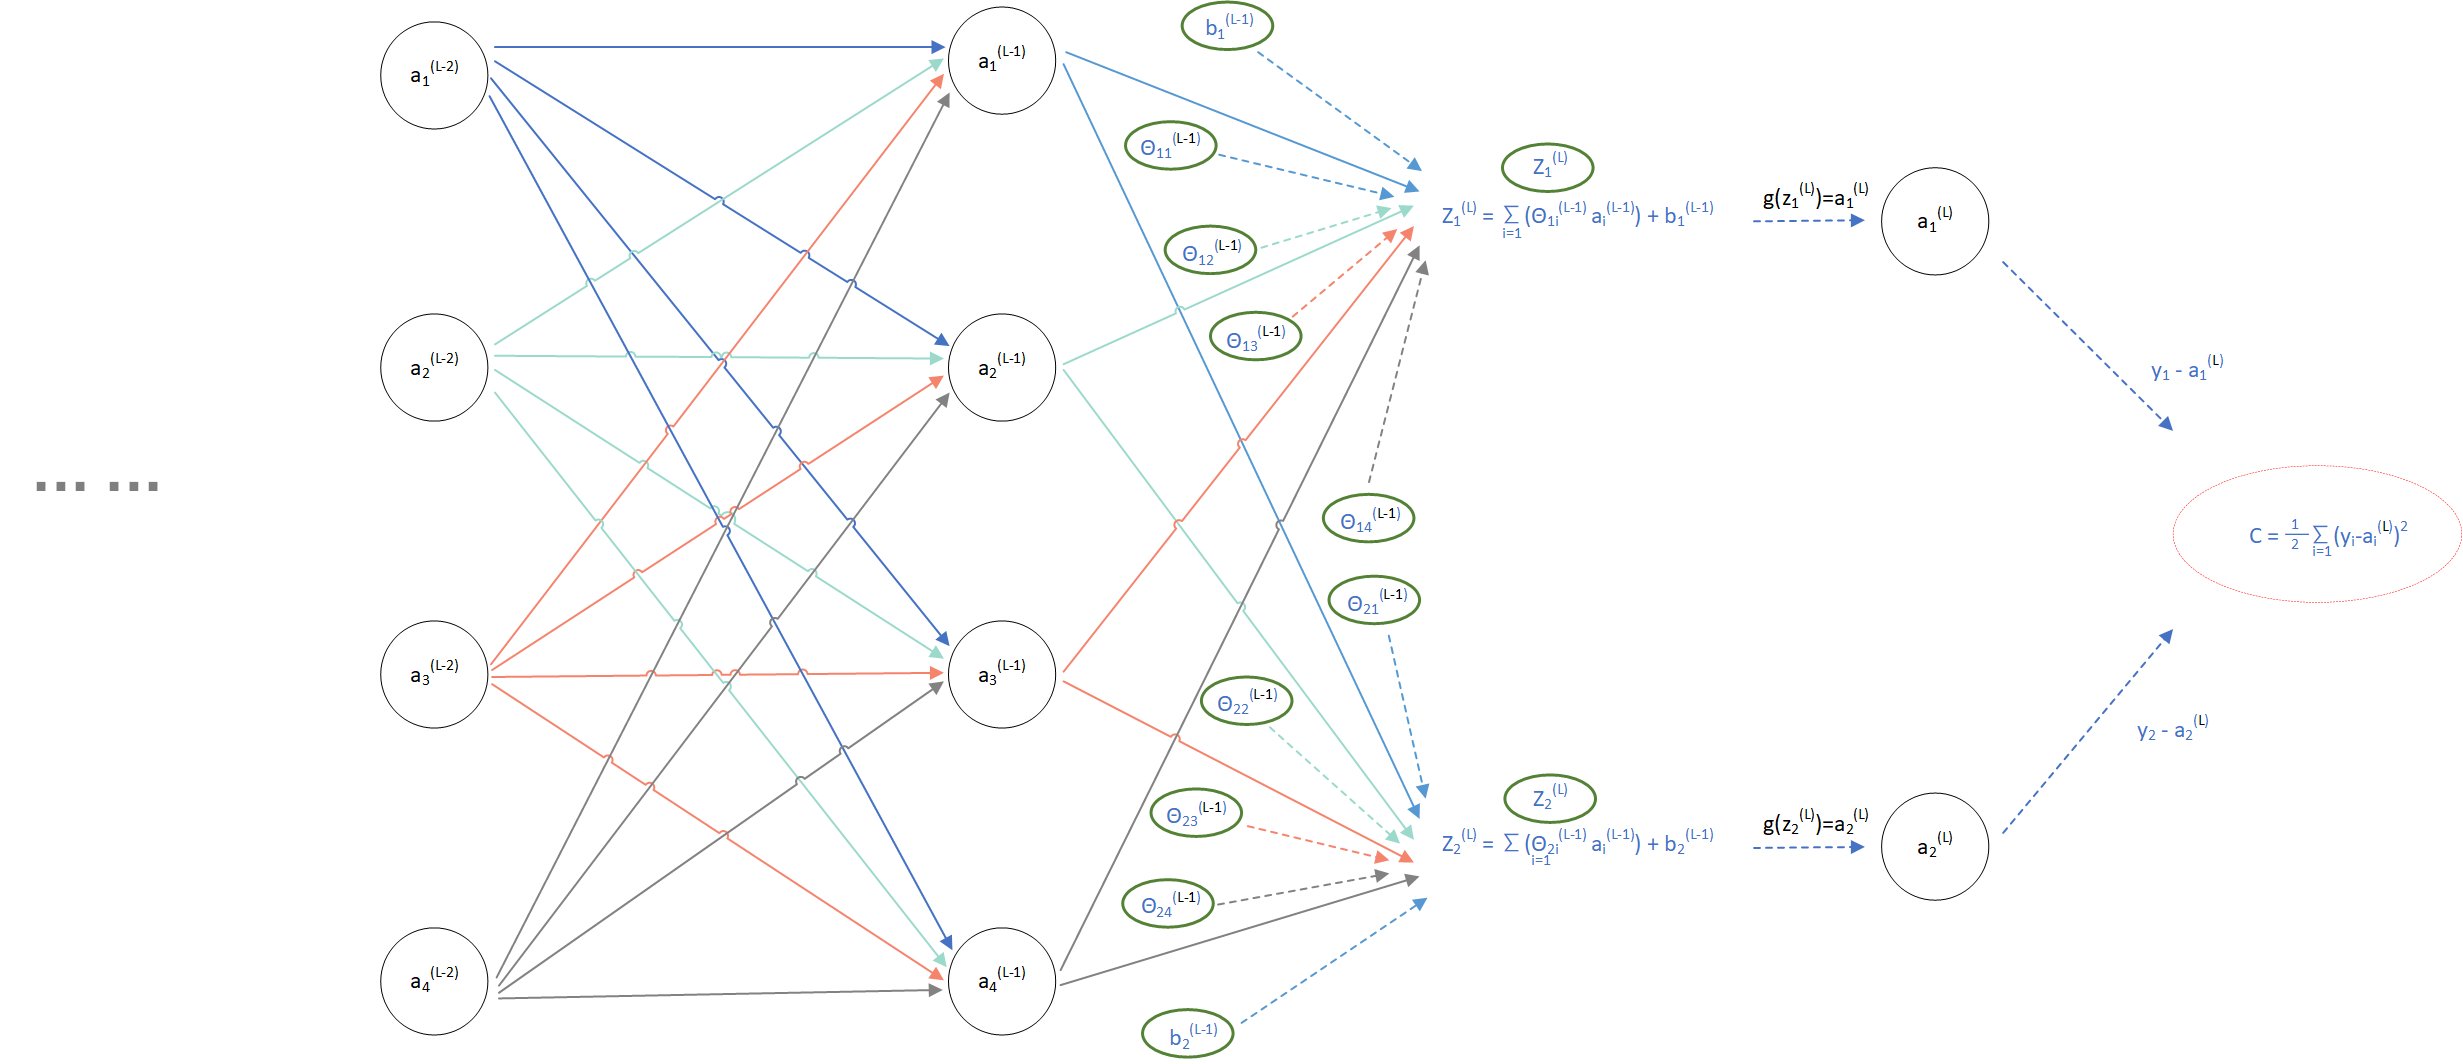
神经网络的反向传播算法推导

                                                                (图5)

下一步开始对每条路径求偏导:

神经网络的反向传播算法推导

                                                                (图6)

        根据上一篇  神经网络的反向传播算法推导 — 前期知识准备  求导的反向模式求导:求损失函数C关于某一节点的偏导数,只需要把该节点每条反向路径上的偏导数做乘积,再求和即可。到此,我们已经在计算图上求得损失函数C关于模型参数的偏导数  \frac{\partial C}{\partial \Theta _{ji}^{(l)}}  、\frac{\partial C}{\partial b _{j}^{(l)}}  ,而反向传播算法就是在此基础上通过定义一个损失/误差: \delta _{j}^{(l)}  ,先逐层向后传播得到每一层节点的损失  \delta _{j}^{(l)}  ,再通过每一个节点的损失  \delta _{j}^{(l)}  来求解该节点的  \frac{\partial C}{\partial \Theta _{ji}^{(l)}}  、\frac{\partial C}{\partial b _{j}^{(l)}}  ,计算步骤:

第一步:令损失函数C关于第 l 层的第 j 个元素的偏导为:\delta _{j}^{(l)} = \frac{\partial C}{\partial z _{j}^{(l)}}

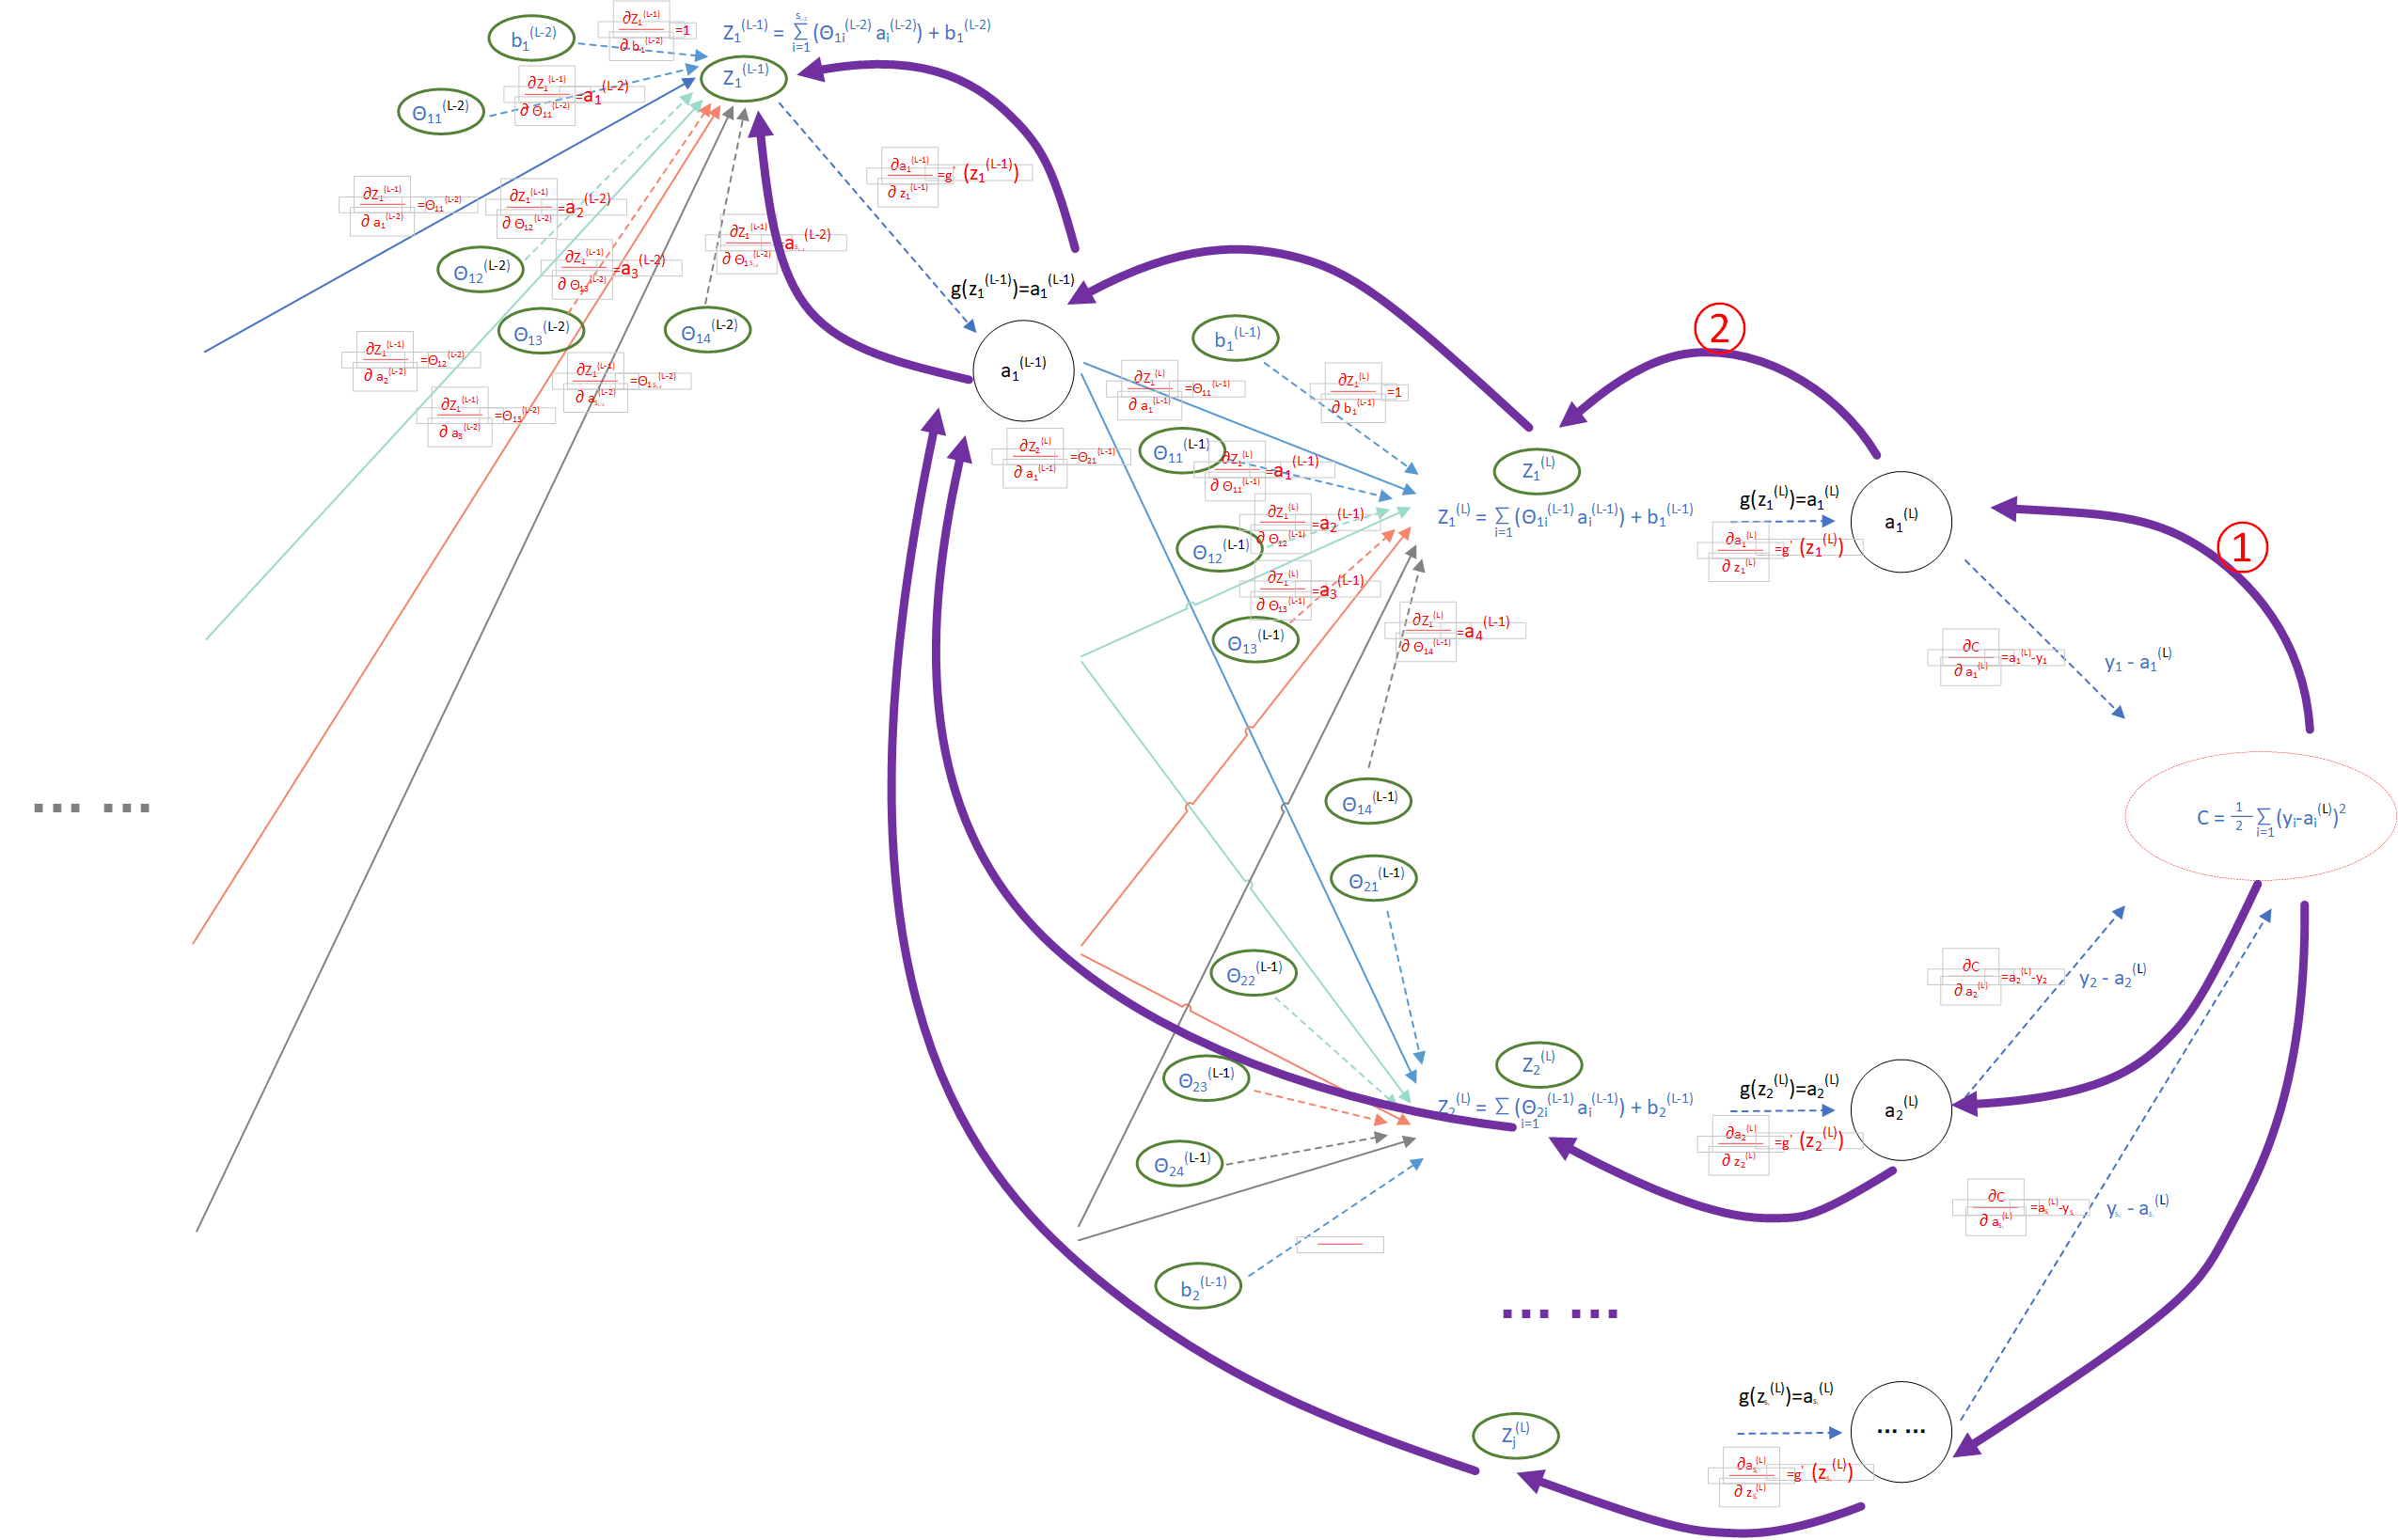
第二步:计算最后一层  \delta _{j}^{(L)}  

神经网络的反向传播算法推导

                                                                (图7)

        按照反向模式求导,节点 C 到 z _{j}^{(L)} 的反向路径只有一条,例如:上图中 C 到 z _{1}^{(L)} 的路径为① -> ② ,按照”同一可达路径相乘,不同可达路径相加“的原则:

\delta _{1}^{(L)} = \frac{\partial C}{\partial z _{1}^{(L)}} = \frac{\partial C}{\partial a _{1}^{(L)}} * g^{'}(z _{1}^{(L)}) = (a _{1}^{(L)} - y_{1}) * g^{'}(z _{1}^{(L)})

\delta _{j}^{(L)} = \frac{\partial C}{\partial z _{j}^{(L)}} = \frac{\partial C}{\partial a _{j}^{(L)}} * g^{'}(z _{j}^{(L)}) = (a _{j}^{(L)} - y_{j}) * g^{'}(z _{j}^{(L)})

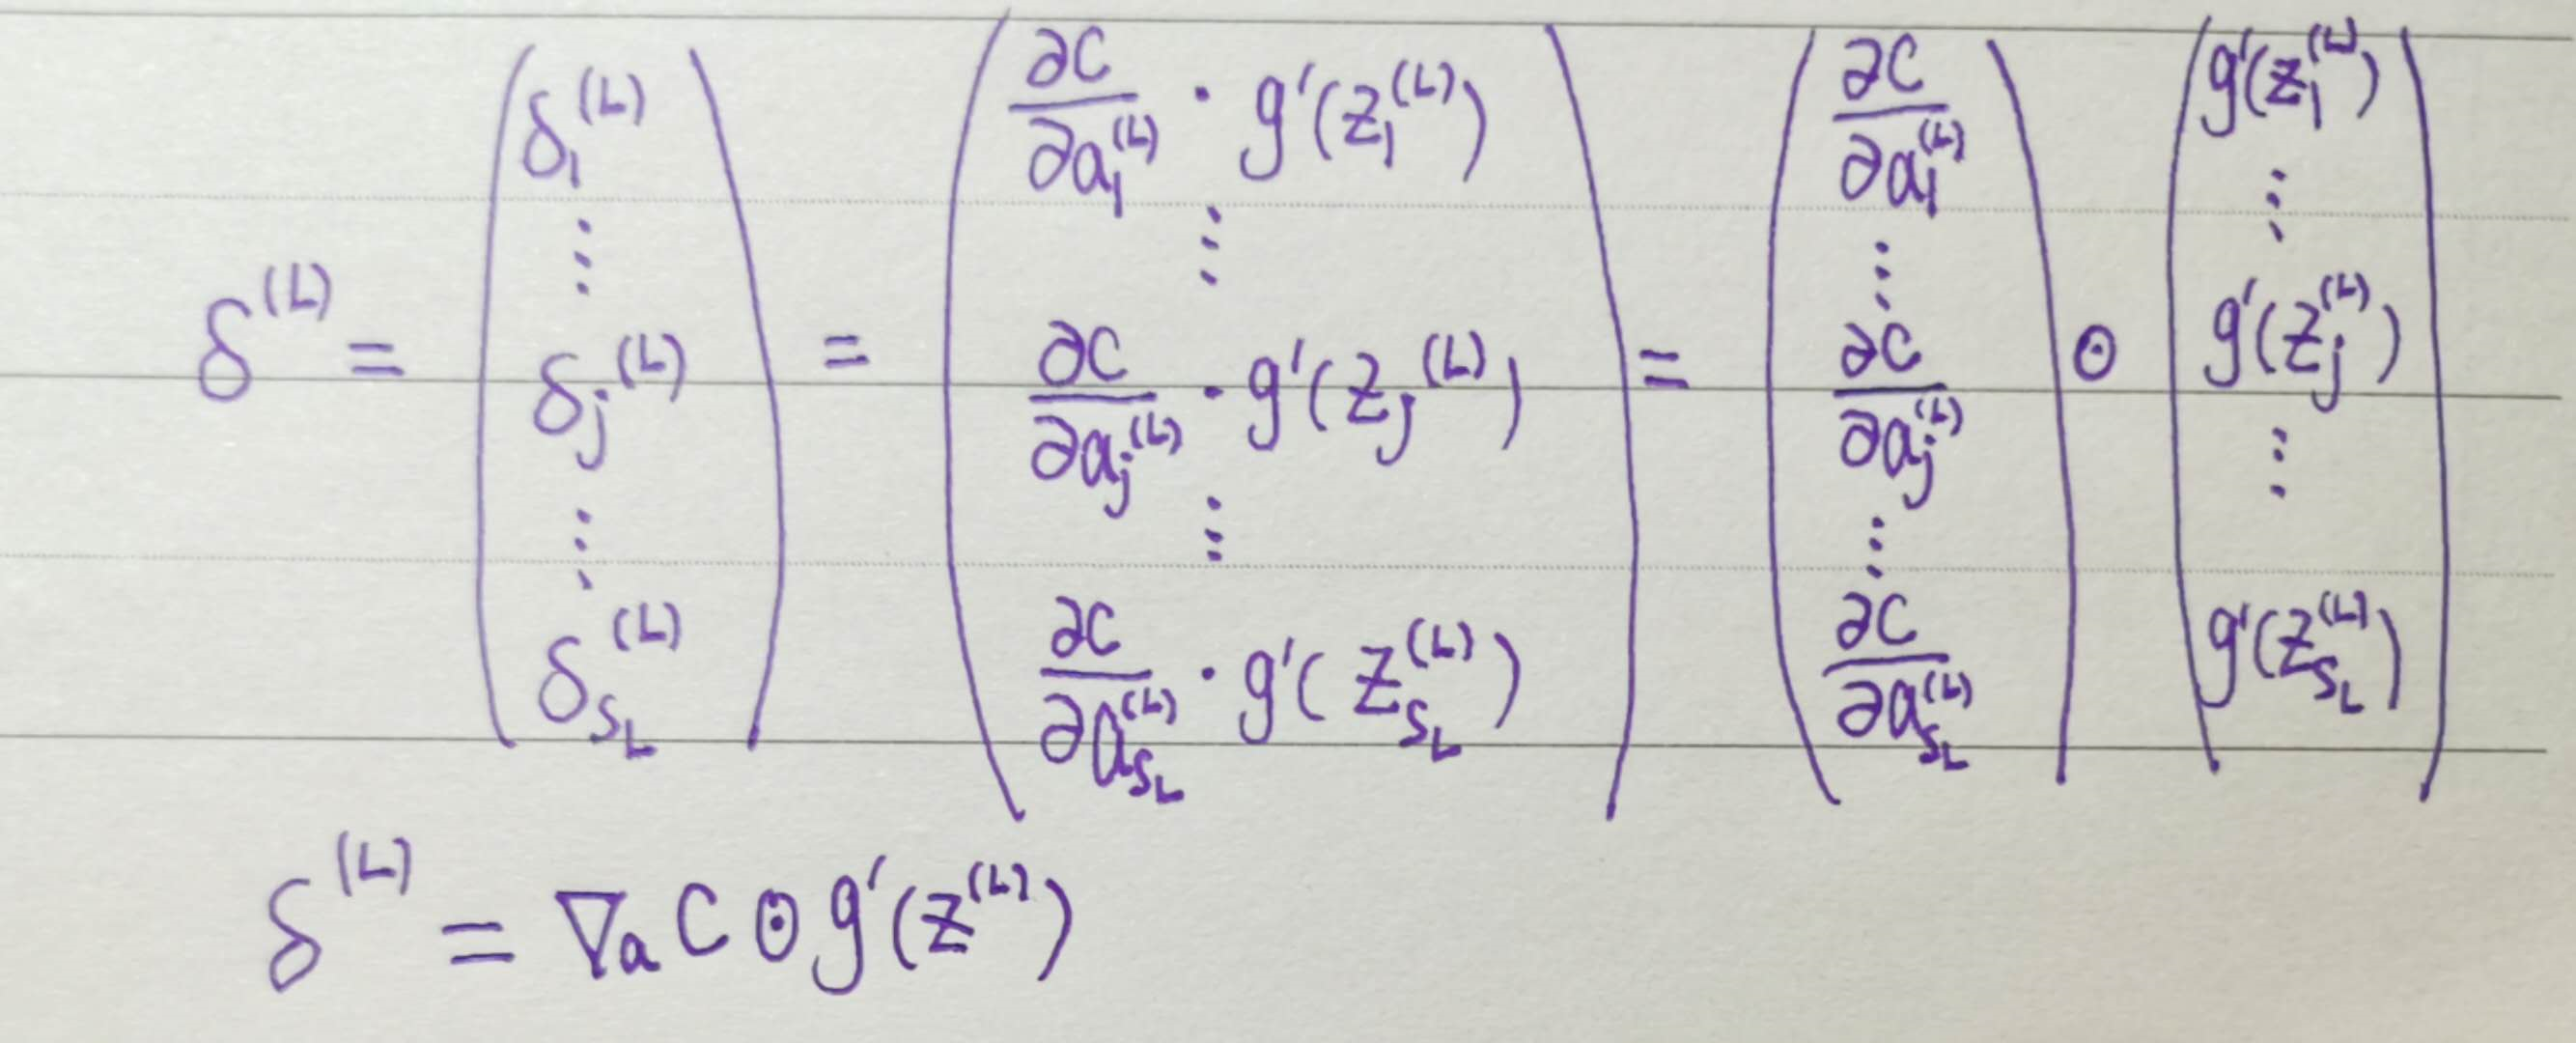
神经网络的反向传播算法推导

                                                                (图8)

【说明】▽的物理意义:▽为对矢量做偏导,它是一个矢量,▽U表示为矢量U的梯度;

其中 \odot 的操作是把两个向量对应元素相乘组成新的元素。

图8即为反向传播算法公式 BP1:   \delta ^{L} = \bigtriangledown _{a} C \odot g^{'}(z^{L})

图7中(紫色路径) C 节点到 z _{j}^{(L-1)} 的反向路径有s_{L}条,按照“同一可达路径相乘,不同可达路径相加”的原则:

\delta _{1}^{(L-1)} = \frac{\partial C}{\partial z _{1}^{(L-1)}}

= (a _{1}^{(L)} - y_{1}) * g^{'}(z _{1}^{(L)}) * \Theta _{11}^{L-1} * g^{'}(z _{1}^{(L-1)})

+ (a _{2}^{(L)} - y_{2}) * g^{'}(z _{2}^{(L)}) * \Theta _{21}^{L-1} * g^{'}(z _{1}^{(L-1)})

…

+ (a _{ j }^{(L)} - y_{ j }) * g^{'}(z _{ j }^{(L)}) * \Theta _{j1}^{L-1} * g^{'}(z _{1}^{(L-1)})

…

+ (a _{ s_{L} }^{(L)} - y_{ s_{L} }) * g^{'}(z _{ s_{L} }^{(L)}) * \Theta _{s_{L} 1}^{L-1} * g^{'}(z _{1}^{(L-1)})

其中 (a _{ s_{L} }^{(L)} - y_{ s_{L} }) = \frac{\partial C}{\partial a _{s_{L}}^{(L)}}    ——>  (a _{ s_{L} }^{(L)} - y_{ s_{L} }) * g^{'}(z _{ s_{L} }^{(L)}) = \frac{\partial C}{\partial a _{s_{L}}^{(L)}} * g^{'}(z _{ s_{L} }^{(L)}) = \delta _{s_{L} }^{(L)},所以,提取公共部分g^{'}(z _{1}^{(L-1)}),并且向量化、得到:

\delta ^{L-1} = ( (\Theta ^{L-1})^{T} \delta ^{L} ) \odot g^{'}(z^{L-1})

推广到 l 层:\delta ^{l} = ( (\Theta ^{l})^{T} \delta ^{l+1} ) \odot g^{'}(z^{l}) 即反向传播算法公式 BP2

说明:有的定义 BP2 为 \delta ^{l} = ( (w ^{l+1})^{T} \delta ^{l+1} ) \odot g^{'}(z^{l}),这应该是层数 l 的定义不同,w ^{l+1} 相当于 \theta ^{l},本文延续斯坦福大学机器学习教程中的定义 z^{(l)} = \theta ^{(l-1)} a^{(l-1)}、h_{\theta } (x) = a^{l} = g(z^{(l)})

接下来计算  \frac{\partial C}{ \partial b_{j}^{l}} 

神经网络的反向传播算法推导

                                                                (图9)

图9中 节点C到节点 b_{1}^{L-1} 的反路径为 ① -> ② -> ③ 

\frac{\partial C}{ \partial b_{1}^{L-1}} = \frac{\partial C}{\partial z _{1}^{L}} *\frac{\partial z _{1}^{L}}{\partial b_{1}^{L-1}} = \frac{\partial C}{\partial z _{1}^{L}} * 1 = \delta _{1}^{L} *1 = \delta _{1}^{L}

\frac{\partial C}{ \partial b_{1}^{L-2}} = \frac{\partial C}{\partial z _{1}^{L-1}} *1 =\delta _{1}^{L-1}

…

\frac{\partial C}{ \partial b_{j}^{l}} = \frac{\partial C}{\partial z _{j}^{l+1}} *1 =\delta _{j}^{l+1}

…

\frac{\partial C}{ \partial b_{s_{l}}^{l}} = \frac{\partial C}{\partial z _{s_{l}}^{l+1}} *1 =\delta _{s_{l}}^{l+1}

由此,得到反向传播算法公式 BP3  \frac{\partial C}{ \partial b_{j}^{l}} = \delta _{j}^{l+1} 

最后计算  \frac{ \partial C }{ \partial \Theta_{jk}^{l} }

神经网络的反向传播算法推导

                                                                (图9)

图9中 节点C到节点 \theta _{11}^{L-1} 的反路径为 ① -> ② -> ③ 

\frac{\partial C}{ \partial \theta _{11}^{L-1}} = \frac{\partial C}{\partial z _{1}^{L}} * a_{1}^{L-1} = \delta _{1}^{L}*a_{1}^{L-1} = a_{1}^{L-1} \delta _{1}^{L}

\frac{\partial C}{ \partial \theta _{11}^{L-2}} = \frac{\partial C}{\partial z _{1}^{L-1}} * a_{1}^{L-2} = \delta _{1}^{L-1}*a_{1}^{L-2} = a_{1}^{L-2} \delta _{1}^{L-1}

…

\frac{\partial C}{ \partial \theta _{ji}^{l}} = \frac{\partial C}{\partial z _{j}^{l+1}} * a_{i}^{l} = \delta _{j}^{l+1}*a_{i}^{l} = a_{i}^{l} \delta _{j}^{l+1}

由此,得到反向传播算法公式 BP4  \frac{ \partial C }{ \partial \theta_{ji}^{l} } = a_{i}^{l} \delta _{j}^{l+1} 

到此,神经网络的反向传播算法的四个公式推导结束。

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容, 请发送邮件至 举报,一经查实,本站将立刻删除。

发布者:全栈程序员-站长,转载请注明出处:https://javaforall.net/140822.html原文链接:https://javaforall.net

赞 (0)
全栈程序员-站长的头像全栈程序员-站长


相关推荐

  • 全国计算机等级考试二级Python真题及解析(5)_计算机二级有必要考吗

    全国计算机等级考试二级Python真题及解析(5)_计算机二级有必要考吗【纯干货】2021全国计算机等级考试Python二级编程题真题详解(上)相较于大多数经验分享类文章,本篇重点在于总结Python二级考试中的编程题(占60分)题型范围及解题技巧,让Python小白能在一周内掌握绝大多数编程题的解题方法,顺利考取证书,为未来应聘岗位添砖加瓦!本文的最终的目的是得到一份能够涵盖编程题部分所有考点的知识点总结脑图!!!

    2022年8月30日
  • 史蒂芬周博客地址[通俗易懂]

    史蒂芬周博客地址[通俗易懂]http://www.sdifen.com/

    2022年8月5日
  • 在数组内删除指定元素_数组对象删除某一个指定对象

    在数组内删除指定元素_数组对象删除某一个指定对象一般来说,我们用数组这种数据结构最多的情况,是用来做查询,时间复杂度为O(1),那么在这里我们来看一下如何用在数组中插入元素和删除元素。数组的适用场景:一般在查询中,适用数组的情况是比较多,因为可以根据下标直接访问元素,时间复杂度是O(1),所以适用于读多写少的场景。数组的插入和删除元素,一般时间复杂度都是O(N),比较麻烦,所以对于插入和删除操作中,不建议选用数组这种数据结构,可以考虑链表…

    2022年8月10日
  • 接口测试抓包工具_接口测试请求头里面有哪些内容

    接口测试抓包工具_接口测试请求头里面有哪些内容1、Poster    Poster为Firefox浏览器的一个插件,主要用来模拟发并HTTP请求。随着Chrome浏览器的流行,它也出了chrome版本:ChromePoster  在Fiefox浏览器中的安装非常简单。首先,打开Fiefox浏览器,菜单栏“工具”–> “添加组件”,搜索“poster”,在搜索例表中点击“安装”,然后重启浏览器即可。  打开方法:菜

    2022年9月5日
  • javaEE与java的区别

    javaEE与java的区别好程序员Java培训分享JavaEE与Java的区别,有不少想要转行做程序员的朋友都会有一个疑问,JavaEE和Java是不是一种语言,这两者之间又有什么区别呢?  Java一共分为三个版本:JavaSE(标准版)、JavaEE(企业版)以及JavaME(微型版)。  其中JavaSE就是大家所熟知的Java根底,JavaEE在企业最常用的地方就是网站PC端的开发,而JavaME常用于移动端开发,现在熟悉的安卓系统便是用JavaME开发的。  Java既可以被编译,也可以被解说。经过

    2022年7月7日

发表回复

您的邮箱地址不会被公开。 必填项已用 * 标注

关注全栈程序员社区公众号