
大家好,又见面了,我是你们的朋友全栈君。
最近两天学习了一下python,并自己写了一个网络爬虫的例子。
python版本: 3.5
IDE : pycharm 5.0.4
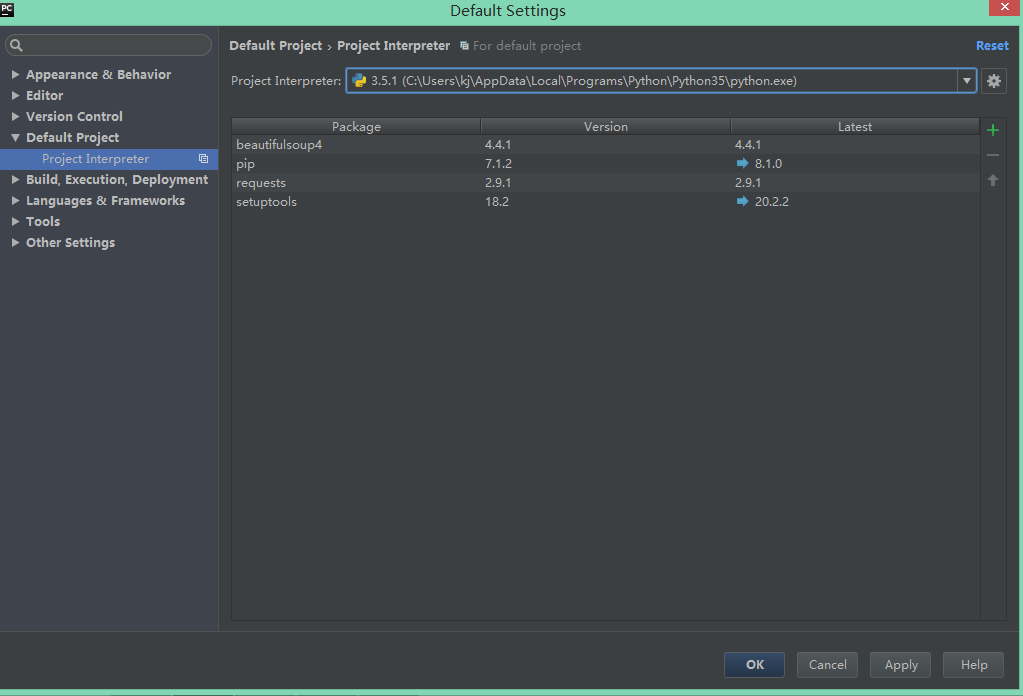
要用到的包可以用pycharm下载:
File->Default Settings->Default Project->Project Interpreter
选择python版本并点右边的加号安装想要的包

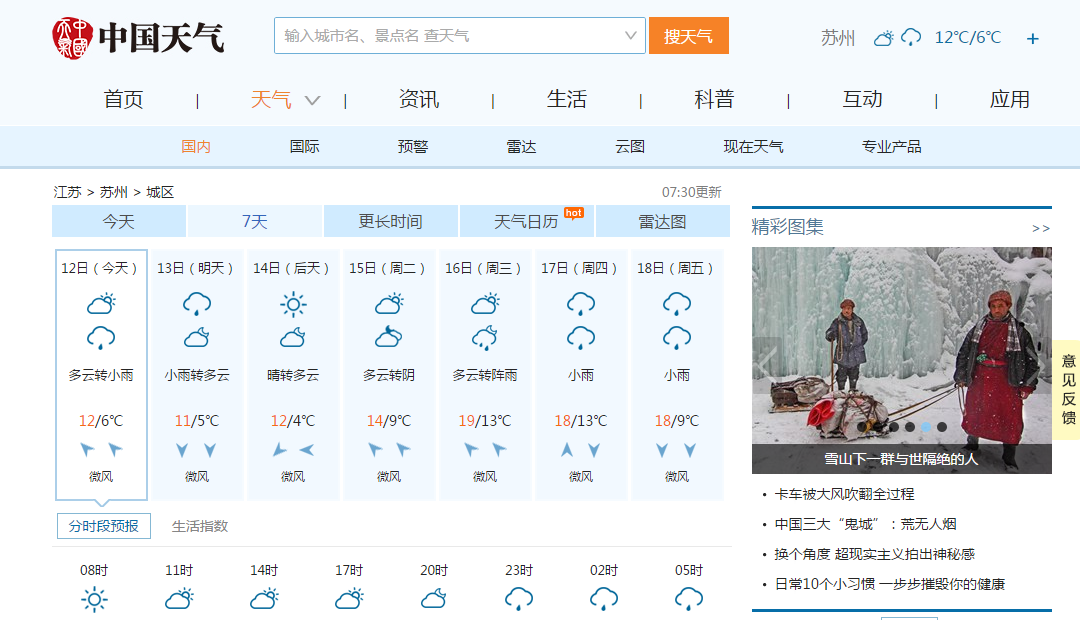
我选择的网站是中国天气网中的苏州天气,准备抓取最近7天的天气以及最高/最低气温
http://www.weather.com.cn/weather/101190401.shtml
程序开头我们添加:
# coding : UTF-8
这样就能告诉解释器该py程序是utf-8编码的,源程序中可以有中文。
要引用的包:
import requests
import csv
import random
import time
import socket
import http.client
# import urllib.request
from bs4 import BeautifulSoup
requests:用来抓取网页的html源代码
csv:将数据写入到csv文件中
random:取随机数
time:时间相关操作
socket和http.client 在这里只用于异常处理
BeautifulSoup:用来代替正则式取源码中相应标签中的内容
urllib.request:另一种抓取网页的html源代码的方法,但是没requests方便(我一开始用的是这一种)
获取网页中的html代码:
def get_content(url , data = None):
    header={
        'Accept': 'text/html,application/xhtml+xml,application/xml;q=0.9,image/webp,*/*;q=0.8',
        'Accept-Encoding': 'gzip, deflate, sdch',
        'Accept-Language': 'zh-CN,zh;q=0.8',
        'Connection': 'keep-alive',
        'User-Agent': 'Mozilla/5.0 (Windows NT 6.3; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/43.0.235'
    }
    timeout = random.choice(range(80, 180))
    while True:
        try:
            rep = requests.get(url,headers = header,timeout = timeout)
            rep.encoding = 'utf-8'
            # req = urllib.request.Request(url, data, header)
            # response = urllib.request.urlopen(req, timeout=timeout)
            # html1 = response.read().decode('UTF-8', errors='ignore')
            # response.close()
            break
        # except urllib.request.HTTPError as e:
        # print( '1:', e)
        # time.sleep(random.choice(range(5, 10)))
        #
        # except urllib.request.URLError as e:
        # print( '2:', e)
        # time.sleep(random.choice(range(5, 10)))
        except socket.timeout as e:
            print( '3:', e)
            time.sleep(random.choice(range(8,15)))

        except socket.error as e:
            print( '4:', e)
            time.sleep(random.choice(range(20, 60)))

        except http.client.BadStatusLine as e:
            print( '5:', e)
            time.sleep(random.choice(range(30, 80)))

        except http.client.IncompleteRead as e:
            print( '6:', e)
            time.sleep(random.choice(range(5, 15)))

    return rep.text
    # return html_text
header是requests.get的一个参数,目的是模拟浏览器访问
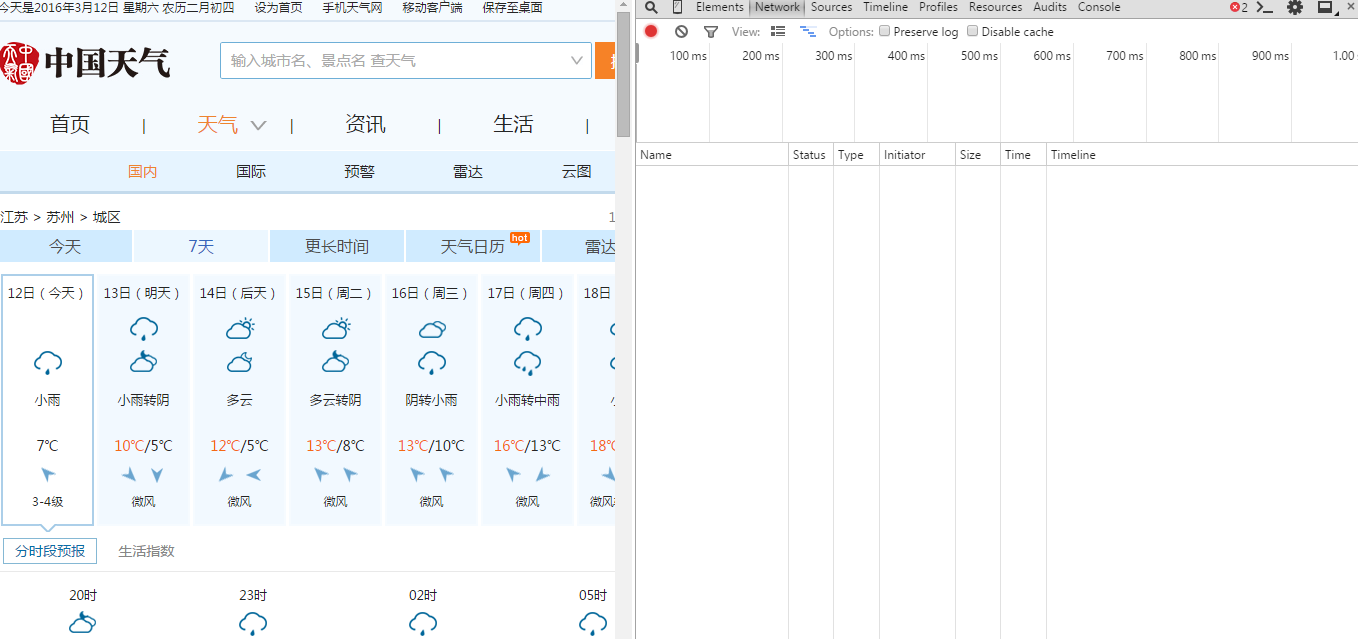
header 可以使用chrome的开发者工具获得,具体方法如下:
打开chrome,按F12,选择network
重新访问该网站,找到第一个网络请求,查看它的header
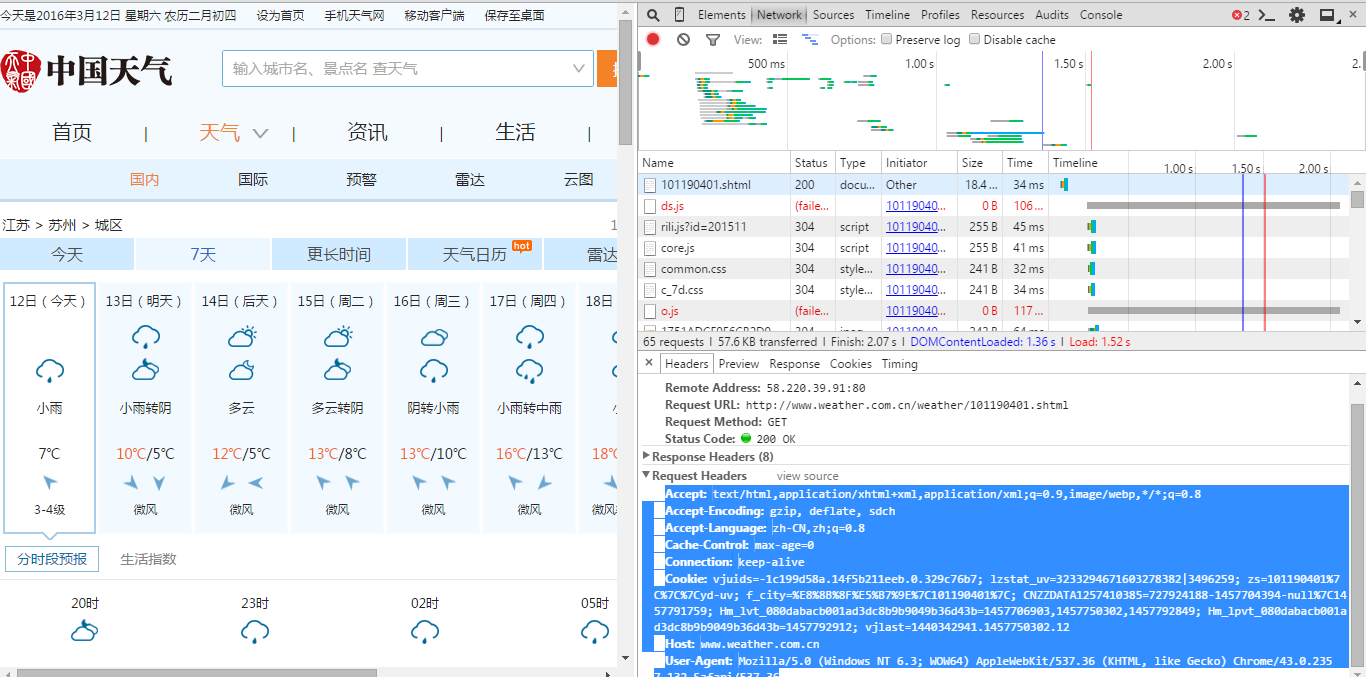
timeout是设定的一个超时时间,取随机数是因为防止被网站认定为网络爬虫。
然后通过requests.get方法获取网页的源代码、
rep.encoding = ‘utf-8’是将源代码的编码格式改为utf-8(不该源代码中中文部分会为乱码)
下面是一些异常处理
返回 rep.text
获取html中我们所需要的字段:
这里我们主要要用到BeautifulSoup
BeautifulSoup 文档http://www.crummy.com/software/BeautifulSoup/bs4/doc/
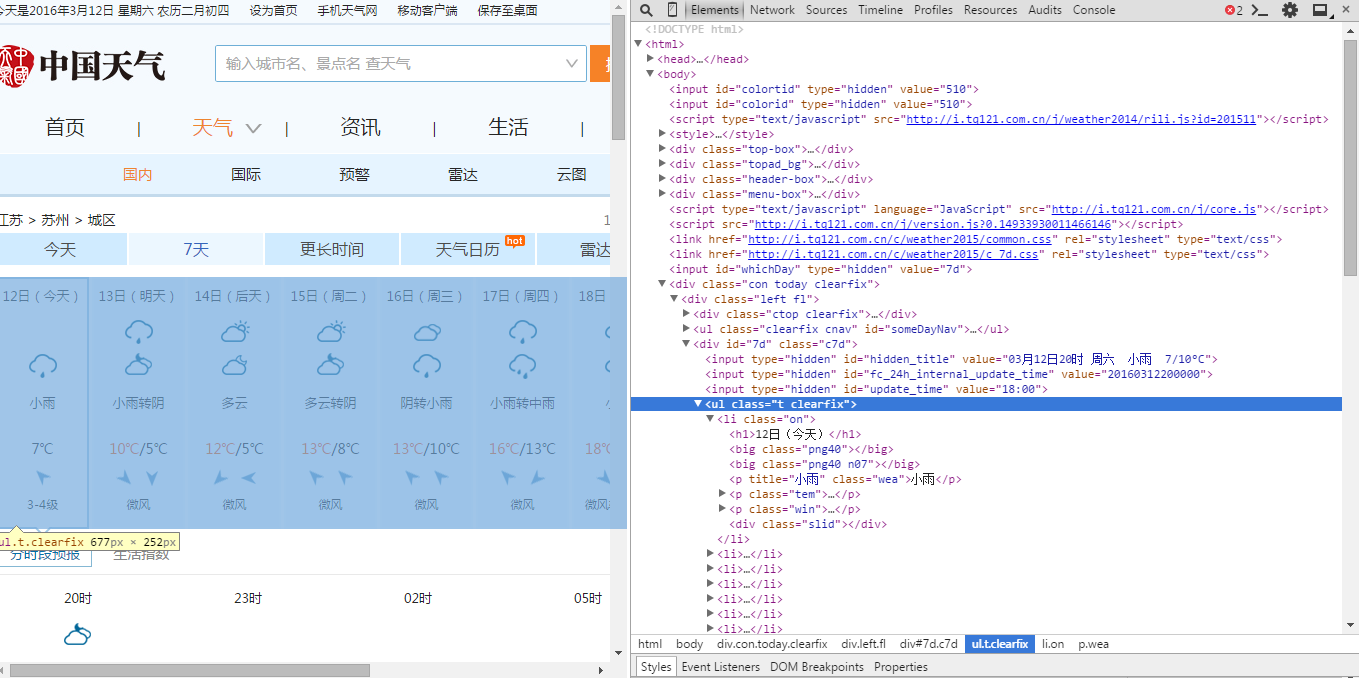
首先还是用开发者工具查看网页源码,并找到所需字段的相应位置
找到我们需要字段都在 id = “7d”的“div”的ul中。日期在每个li中h1 中,天气状况在每个li的第一个p标签内,最高温度和最低温度在每个li的span和i标签中。
感谢Joey_Ko指出的错误:到了傍晚,当天气温会没有最高温度,所以要多加一个判断。
代码如下:
def get_data(html_text):
    final = []
    bs = BeautifulSoup(html_text, "html.parser")  # 创建BeautifulSoup对象
    body = bs.body # 获取body部分
    data = body.find('div', {

  'id': '7d'})  # 找到id为7d的div
    ul = data.find('ul')  # 获取ul部分
    li = ul.find_all('li')  # 获取所有的li

    for day in li: # 对每个li标签中的内容进行遍历
        temp = []
        date = day.find('h1').string  # 找到日期
        temp.append(date)  # 添加到temp中
        inf = day.find_all('p')  # 找到li中的所有p标签
        temp.append(inf[0].string,)  # 第一个p标签中的内容(天气状况)加到temp中
        if inf[1].find('span') is None:
            temperature_highest = None # 天气预报可能没有当天的最高气温(到了傍晚,就是这样),需要加个判断语句,来输出最低气温
        else:
            temperature_highest = inf[1].find('span').string  # 找到最高温
            temperature_highest = temperature_highest.replace('℃', '')  # 到了晚上网站会变,最高温度后面也有个℃
        temperature_lowest = inf[1].find('i').string  # 找到最低温
        temperature_lowest = temperature_lowest.replace('℃', '')  # 最低温度后面有个℃,去掉这个符号
        temp.append(temperature_highest)   # 将最高温添加到temp中
        temp.append(temperature_lowest)   #将最低温添加到temp中
        final.append(temp)   #将temp加到final中

    return final
写入文件csv:
将数据抓取出来后我们要将他们写入文件,具体代码如下:
def write_data(data, name):
    file_name = name
    with open(file_name, 'a', errors='ignore', newline='') as f:
            f_csv = csv.writer(f)
            f_csv.writerows(data)
主函数:
if __name__ == '__main__':
    url ='http://www.weather.com.cn/weather/101190401.shtml'
    html = get_content(url)
    result = get_data(html)
    write_data(result, 'weather.csv')
然后运行一下:
生成的weather.csv文件如下:
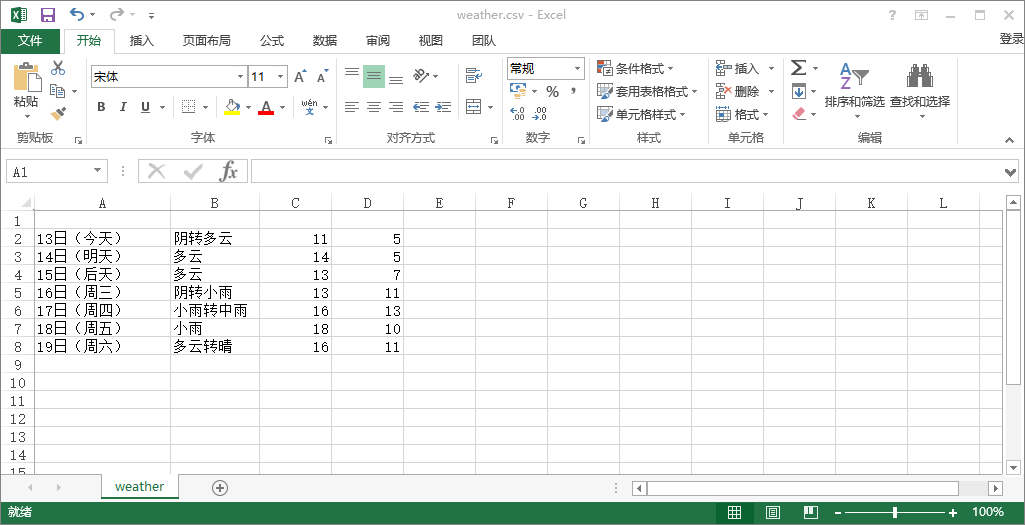
总结一下,从网页上抓取内容大致分3步:
1、模拟浏览器访问,获取html源代码
2、通过正则匹配,获取指定标签中的内容
3、将获取到的内容写到文件中
刚学python爬虫,可能有些理解有错误的地方,请大家批评指正,谢谢!
发布者:全栈程序员-站长,转载请注明出处:https://javaforall.net/143030.html原文链接:https://javaforall.net



