hashmap的数据结构以及put和get

hashmap的数据结构以及put和get一,hashmap数据结构。数据结构中有数组和链表来实现对数据的存储,但是这两种方式的优点和缺点都很明显:1,数组存储,它的存储区间是连续的,比较占内存,故空间复杂度高。但是利用二分法进行查找的话,效率高,时间复杂度为O(1)。其特点就是:存储区间连续,查找速度快,但是占内存严重,插入和删除就慢。2,链表查询,它的存储区间离散,占内存比较宽松,故空间复杂度低,但时间复杂度高,为O(n)。其特

大家好,又见面了,我是你们的朋友全栈君。

一,hashmap数据结构。

数据结构中有数组和链表来实现对数据的存储,但是这两种方式的优点和缺点都很明显:
1,数组存储,它的存储区间是连续的,比较占内存,故空间复杂度高。但是利用二分法进行查找的话,效率高,时间复杂度为O(1)。其特点就是:存储区间连续,查找速度快,但是占内存严重,插入和删除就慢。
2,链表查询,它的存储区间离散,占内存比较宽松,故空间复杂度低,但时间复杂度高,为O(n)。其特点就是存储空间离散,空间复杂度低,插入和删除方便,但是时间复杂度高,导致查询比较慢。

综合以上两者的特点,就产生了一个时间复杂度低,占内存比较宽松,增删改查都比较方便的数据结构,也就是经常提到的哈希表。

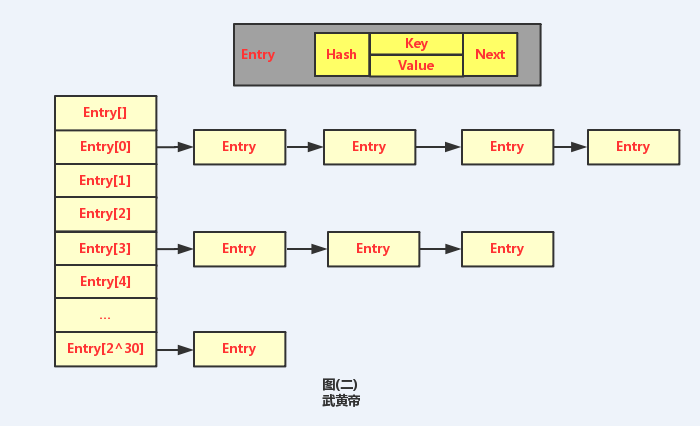
哈希表最常用的实现方法就是拉链法,也可以理解为“链表的数组”。其模型大概如下图所示:

这里写图片描述

从上图中,比较容易看出,HashMap是Y轴方向是数组,X轴方向就是链表的存储方式。而每个数组的元素存储的都是链表的头结点。

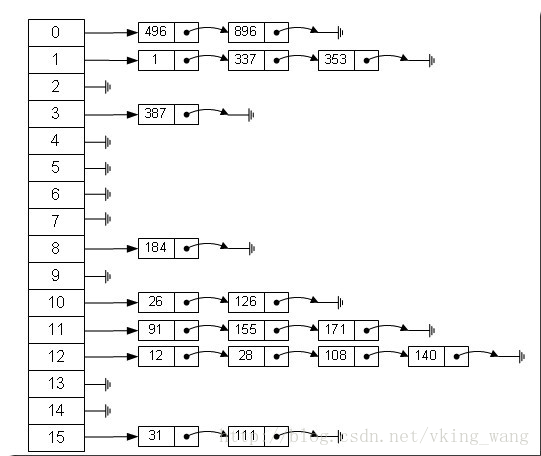
那么这些元素是按照什么样的规则存储到数组中呢。一般情况是通过hash=index把链表和数组关联起来的,而hash=hash(key)%len获得,index就为数组的元素序列号,也就是元素的key的哈希值对数组长度取模得到。
这里写图片描述

比如上述长度为16的哈希表中,链表元素中其key的hash值为的12有:12%16=12,28%16=12,108%16=12,140%16=12。所以12、28、108以及140都存储在index(数组下标)为12的位置。

二,Hashmap的存取实现

为什么说hashmap能随机进行存取呢?那是因为hashmap里有一个小小的算法,如下:

// 存储时:
int hash = key.hashCode(); // 这个hashCode方法这里不详述,只要理解每个key的hash是一个固定的int值
int index = hash % Entry[].length;
Entry[index] = value;

// 取值时:
int hash = key.hashCode();
int index = hash % Entry[].length;
return Entry[index];

1)put
在存储的时候,万一多个个元素的hash值(也就是hash(key)%Entry[].length)都等于同一个index,这样会不会导致后面一个元素覆盖掉前一个元素呢?答案是不会的。从上面的例子中就可以看出,hash=12的有四个元素在index=12的那一行。其实数组中存储的就是最后插入的元素,该元素的next值的就是之前的那个元素,并不是覆盖掉。

2)get
通过传入的key,先找到Y轴index为hash(key)%Entry[].length 的数组元素,然后再遍厉该元素所处的链表。

3)null key的存取
null key总是存放在Entry[]数组的第一个元素。

4)确定数组index:hashcode % table.length取模
HashMap存取时,都需要计算当前key应该对应Entry[]数组哪个元素,即计算数组下标;算法如下:

/**
* Returns index for hash code h.
*/
static int indexFor(int h, int length) {
return h & (length-1);
}

按位取并,作用上相当于取模mod或者取余%。
这意味着数组下标相同,并不表示hashCode相同。

5)再散列rehash过程
当哈希表的容量超过默认容量时,必须调整table的大小。当容量已经达到最大可能值时,那么该方法就将容量调整到Integer.MAX_VALUE返回,这时,需要创建一张新表,将原表的映射到新表中。

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容, 请发送邮件至 举报,一经查实,本站将立刻删除。

发布者:全栈程序员-站长,转载请注明出处:https://javaforall.net/144623.html原文链接:https://javaforall.net

赞 (0)
全栈程序员-站长的头像全栈程序员-站长


相关推荐

  • databus 支持oracle么,Databus[通俗易懂]

    databus 支持oracle么,Databus[通俗易懂]系统如果要应付大规模的请求,一条必经之路就是数据库的分割,单服务器的性能早晚都会成为负载的短板。而数据库分割,通常有Master/Salve或者集群Cluster的方式,这些方式通常都是基于同种类型的数据。对于一个庞大的多类型数据库的系统,在不同的数据库之间(甚至是不同地理位置的机房间)保持数据的同步,需要更复杂的解决方案。LinkedIn良心开源了内部的一个项目Databus,正是解决这个问题的…

    2022年10月17日
  • Java如何判断整数溢出,溢出后怎么得到提示?

    点击上方“全栈程序员社区”,星标公众号 重磅干货,第一时间送达 作者:Aaron_涛 blog.csdn.net/qq_33330687/article/details/81626…

    2021年6月24日
  • Android opencv人脸识别

    Android opencv人脸识别opencv人脸识别Androidopencv人脸识别图片:![在这里插入图片描述](https://img-blog.csdnimg.cn/2019012214185895.png//开始人脸检测publicvoidstart(){n_Start();}//停止人脸检测publicvoidstop(){n_Stop();}//设…

    2022年6月7日
  • mysql卸载教程5.5_centos卸载mysql

    mysql卸载教程5.5_centos卸载mysql完整卸载MySQL数据库1、关掉mysql服务直接搜索服务或者右键“我的电脑”,选择“管理”,打开计算机管理,选择“服务”右键MySQL服务,选择“停止”2、卸载mysql程序开始菜单->控制面板->程序和功能3、删除计算机上的残留文件(1)删除C盘-》programData->mysql文件夹,programData文件夹为隐藏文件夹//这一步很重要(2)删除mysql的安装目录4、删除注册表信息往往我们进行完上面的两个步骤,我们计算机上的mysql就已

    2022年9月30日
  • 智能化让商业地产迎来新一轮黄金期

    智能化让商业地产迎来新一轮黄金期

    2021年6月5日
  • PID控制器开发笔记之十二:模糊PID控制器的实现[通俗易懂]

    PID控制器开发笔记之十二:模糊PID控制器的实现[通俗易懂]在现实控制中,被控系统并非是线性时不变的,往往需要动态调整PID的参数,而模糊控制正好能够满足这一需求,所以在接下来的这一节我们将讨论模糊PID控制器的相关问题。模糊PID控制器是将模糊算法与PID控制参数的自整定相结合的一种控制算法。可以说是模糊算法在PID参数整定上的应用。1、模糊算法的原理模糊算法是一种基于智能推理的算法,虽然称之为模糊算法其实并不模糊,实际上是一种逐步求精的思想。一…

    2022年5月3日

发表回复

您的邮箱地址不会被公开。 必填项已用 * 标注

关注全栈程序员社区公众号