
大家好,又见面了,我是你们的朋友全栈君。
个人公众号,欢迎关注
YouChouNoBB
svm参数说明———————-
如果你要输出类的概率,一定要有-b参数
svm-train training_set_file model_file
svm-predict test_file model_fileoutput_file
自动脚本:python easy.py train_data test_data
自动选择最优参数,自动进行归一化。
对训练集合和测试结合,使用同一个归一化参数。
-c:参数
-g: 参数
-v:交叉验证数
-s svm_type : set type of SVM (default 0)
0 — C-SVC
1 — nu-SVC
2 — one-class SVM
3 — epsilon-SVR
4 — nu-SVR
-t kernel_type : set type of kernelfunction (default 2)
0 — linear: u’*v
1 — polynomial: (gamma*u’*v + coef0)^degree
2 — radial basis function: exp(-gamma*|u-v|^2)
3 — sigmoid: tanh(gamma*u’*v + coef0)
-d degree : set degree in kernel function(default 3)
-g gamma : set gamma in kernel function(default 1/num_features)
-r coef0 : set coef0 in kernel function(default 0)
-c cost : set the parameter C of C-SVC,epsilon-SVR, and nu-SVR (default 1)
-n nu : set the parameter nu of nu-SVC,one-class SVM, and nu-SVR (default 0.5)
-p epsilon : set the epsilon in lossfunction of epsilon-SVR (default 0.1)
-m cachesize : set cache memory size in MB(default 100)
-e epsilon : set tolerance of terminationcriterion (default 0.001)
-h shrinking: whether to use the shrinkingheuristics, 0 or 1 (default 1)
-b probability_estimates: whether to traina SVC or SVR model for probability estimates, 0 or 1 (default 0)(如果需要估计分到每个类的概率,则需要设置这个)
-wi weight: set the parameter C of class ito weight*C, for C-SVC (default 1)
Thek in the -g option means the number of attributes in the input data.
libsvm使用误区———————-
(1) 直接将训练集合和测试集合简单归一化到[0,1]区间,可能导致实验结果很差。
(2) 如果样本的特征数非常多,那么就不必使用RBF核将样本映射到高维空间。
a) 在特征数非常多的情况下,使用线性核,结果已经非常好,并且只需要选择参数C即可。
b) 虽然说RBF核的结果至少比线性核好,前提下搜索整个的空间。
(3) 样本数<<特征数的情况:
a) 推荐使用线性核,可以达到与RBF同样的性能。
(4) 样本数和特征数都非常多:推荐使用liblinear,更少的时间和内存,可比的准确率。
(5) 样本数>>特征数:如果想使用线性模型,可以使用liblinear,并且使用-s 2参数
libsvm在训练model的时候,有如下参数要设置,当然有默认的参数,但是在具体应用方面效果会大大折扣。
Options:可用的选项即表示的涵义如下
-s svm类型:SVM设置类型(默认0)
0 — C-SVC
1 –v-SVC
2 –一类SVM
3 — e -SVR
4 — v-SVR
-t 核函数类型:核函数设置类型(默认2)
0 –线性:u’v
1 –多项式:(r*u’v + coef0)^degree
2 – RBF函数:exp(-gamma|u-v|^2)
3 –sigmoid:tanh(r*u’v + coef0)
-d degree:核函数中的degree设置(针对多项式核函数)(默认3)
-g r(gama):核函数中的gamma函数设置(针对多项式/rbf/sigmoid核函数)(默认1/ k)
-r coef0:核函数中的coef0设置(针对多项式/sigmoid核函数)((默认0)
-c cost:设置C-SVC,e -SVR和v-SVR的参数(损失函数)(默认1)
-n nu:设置v-SVC,一类SVM和v- SVR的参数(默认0.5)
-p p:设置e -SVR 中损失函数p的值(默认0.1)
-m cachesize:设置cache内存大小,以MB为单位(默认40)
-e eps:设置允许的终止判据(默认0.001)
-h shrinking:是否使用启发式,0或1(默认1)
-wi weight:设置第几类的参数C为weight*C(C-SVC中的C)(默认1)
-v n: n-fold交互检验模式,n为fold的个数,必须大于等于2
其中-g选项中的k是指输入数据中的属性数。option -v 随机地将数据剖分为n部
当构建完成model后,还要为上述参数选择合适的值,方法主要有Gridsearch,其他的感觉不常用,Gridsearch说白了就是穷举。
网格参数寻优函数(分类问题):SVMcgForClass
[bestCVaccuracy,bestc,bestg]=
SVMcgForClass(train_label,train,
cmin,cmax,gmin,gmax,v,cstep,gstep,accstep)
输入:
train_label:训练集的标签,格式要求与svmtrain相同。
train:训练集,格式要求与svmtrain相同。
cmin,cmax:惩罚参数c的变化范围,即在[2^cmin,2^cmax]范围内寻找最佳的参数c,默认值为cmin=-8,cmax=8,即默认惩罚参数c的范围是[2^(-8),2^8]。
gmin,gmax:RBF核参数g的变化范围,即在[2^gmin,2^gmax]范围内寻找最佳的RBF核参数g,默认值为gmin=-8,gmax=8,即默认RBF核参数g的范围是[2^(-8),2^8]。
v:进行Cross Validation过程中的参数,即对训练集进行v-fold Cross Validation,默认为3,即默认进行3折CV过程。
cstep,gstep:进行参数寻优是c和g的步进大小,即c的取值为2^cmin,2^(cmin+cstep),…,2^cmax,,g的取值为2^gmin,2^(gmin+gstep),…,2^gmax,默认取值为cstep=1,gstep=1。
accstep:最后参数选择结果图中准确率离散化显示的步进间隔大小([0,100]之间的一个数),默认为4.5。
输出:
bestCVaccuracy:最终CV意义下的最佳分类准确率。
bestc:最佳的参数c。
bestg:最佳的参数g。
网格参数寻优函数(回归问题):SVMcgForRegress
[bestCVmse,bestc,bestg]=
SVMcgForRegress(train_label,train,
cmin,cmax,gmin,gmax,v,cstep,gstep,msestep)
其输入输出与SVMcgForClass类似,这里不再赘述。
而当你训练完了model,在用它做classification或regression之前,应该知道model中的内容,以及其含义。
用来训练的是libsvm自带的heart数据
model =
Parameters: [5×1 double]
nr_class: 2
totalSV: 259 % 支持向量的数目
rho: 0.0514 % b
Label: [2×1 double] % classification中标签的个数
ProbA: []
ProbB: []
nSV: [2×1 double] % 每类支持向量的个数
sv_coef: [259×1 double] % 支持向量对应的Wi
SVs: [259×13 double] % 装的是259个支持向量
model.Parameters参数意义从上到下依次为:
-s svm类型:SVM设置类型(默认0)
-t 核函数类型:核函数设置类型(默认2)
-d degree:核函数中的degree设置(针对多项式核函数)(默认3)
-g r(gama):核函数中的gamma函数设置(针对多项式/rbf/sigmoid核函数) (默认类别数目的倒数)
-r coef0:核函数中的coef0设置(针对多项式/sigmoid核函数)((默认0)
SVM 怎样能得到好的结果
1. 对数据做归一化(simple scaling)
2. 应用 RBF kernel
3. 用cross-validation和grid-search 得到最优的c和g
4. 用得到的最优c和g训练训练数据
5. 测试
关于svm的C以及核函数参数设置———————-
参考自:对支持向量机几种常用核函数和参数选择的比较研究
C一般可以选择为:10^t , t=- 4..4就是0.0001 到10000
选择的越大,表示对错误例惩罚程度越大,可能会导致模型过拟合
在LIBSVM中-t用来指定核函数类型(默认值是2)。
0)线性核函数
(无其他参数)
1)多项式核函数
(重点是阶数的选择,即d,一般选择1-11:1 3 5 7 9 11,也可以选择2,4,6…)
2)RBF核函数
(径向基RBF内核,exp{-|xi-xj|^2/均方差},其中均方差反映了数据波动的大小。
参数通常可选择下面几个数的倒数:0.1 0.2 0.4 0.6 0.8 1.6 3.2 6.4 12.8,默认的是类别数的倒数,即1/k,2分类的话就是0.5)
3)sigmoid核函数 又叫做S形内核
两个参数g以及r:g一般可选1 2 3 4,r选0.2 0.4 0.60.8 1
4)自定义核函数
常用的四种核函数对应的公式如下:
与核函数相对应的libsvm参数:
1)对于线性核函数,没有专门需要设置的参数
2)对于多项式核函数,有三个参数。-d用来设置多项式核函数的最高此项次数,也就是公式中的d,默认值是3。-g用来设置核函数中的gamma参数设置,也就是公式中的第一个r(gamma),默认值是1/k(k是类别数)。-r用来设置核函数中的coef0,也就是公式中的第二个r,默认值是0。
3)对于RBF核函数,有一个参数。-g用来设置核函数中的gamma参数设置,也就是公式中的第一个r(gamma),默认值是1/k(k是类别数)。
4)对于sigmoid核函数,有两个参数。-g用来设置核函数中的gamma参数设置,也就是公式中的第一个r(gamma),默认值是1/k(k是类别数)。-r用来设置核函数中的coef0,也就是公式中的第二个r,默认值是0。
关于cost和gamma
SVM模型有两个非常重要的参数C与gamma。其中 C是惩罚系数,即对误差的宽容度。c越高,说明越不能容忍出现误差,容易过拟合。C越小,容易欠拟合。C过大或过小,泛化能力变差
gamma是选择RBF函数作为kernel后,该函数自带的一个参数。隐含地决定了数据映射到新的特征空间后的分布,gamma越大,支持向量越少,gamma值越小,支持向量越多。支持向量的个数影响训练与预测的速度。
此外大家注意RBF公式里面的sigma和gamma的关系如下:

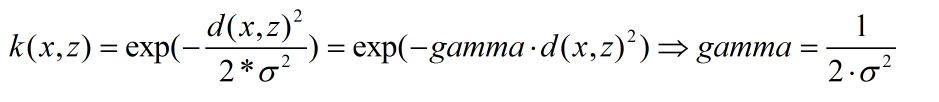
这里面大家需要注意的就是gamma的物理意义,大家提到很多的RBF的幅宽,它会影响每个支持向量对应的高斯的作用范围,从而影响泛化性能。我的理解:如果gamma设的太大,会很小,很小的高斯分布长得又高又瘦, 会造成只会作用于支持向量样本附近,对于未知样本分类效果很差,存在训练准确率可以很高,(如果让无穷小,则理论上,高斯核的SVM可以拟合任何非线性数据,但容易过拟合)而测试准确率不高的可能,就是通常说的过训练;而如果设的过小,则会造成平滑效应太大,无法在训练集上得到特别高的准确率,也会影响测试集的准确率。

样本数目少于特征维度并不一定会导致过拟合,这可以参考余凯老师的这句评论:
RBF核应该可以得到与线性核相近的效果(按照理论,RBF核可以模拟线性核),可能好于线性核,也可能差于,但是,不应该相差太多。
以上摘录了:http://blog.sina.com.cn/s/blog_6ae183910101cxbv.html
Grid Search
Grid Search是用在Libsvm中的参数搜索方法。很容易理解:就是在C,gamma组成的二维参数矩阵中,依次实验每一对参数的效果。
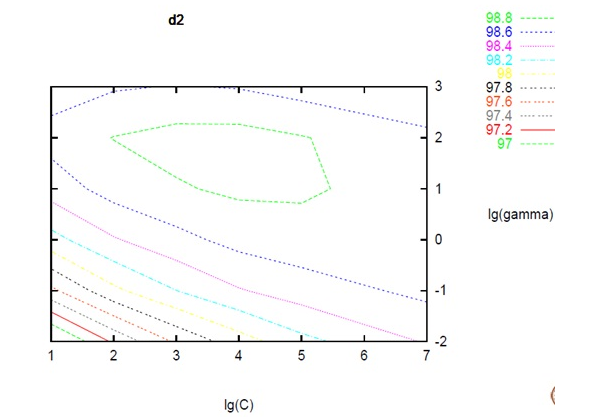
使用grid Search虽然比较简单,而且看起来很naïve。但是他确实有两个优点:
- 可以得到全局最优
- (C,gamma)相互独立,便于并行化进行
# SVM Classifier using cross validation
def svm_cross_validation(train_x, train_y):
    from sklearn.grid_search import GridSearchCV
    from sklearn.svm import SVC
    model = SVC(kernel='rbf', probability=True)
    param_grid = {'C': [1e-3, 1e-2, 1e-1, 1, 10, 100, 1000], 'gamma': [0.001, 0.0001]}
    grid_search = GridSearchCV(model, param_grid, n_jobs = 8, verbose=1)
    grid_search.fit(train_x, train_y)
    best_parameters = grid_search.best_estimator_.get_params()
    for para, val in list(best_parameters.items()):
        print(para, val)
    model = SVC(kernel='rbf', C=best_parameters['C'], gamma=best_parameters['gamma'], probability=True)
    model.fit(train_x, train_y)
    return model
SVM有如下主要几个特点:(1)非线性映射是SVM方法的理论基础,SVM利用内积核函数代替向高维空间的非线性映射;(2)对特征空间划分的最优超平面是SVM的目标,最大化分类边际的思想是SVM方法的核心;(3)支持向量是SVM的训练结果,在SVM分类决策中起决定作用的是支持向量;(4)SVM 是一种有坚实理论基础的新颖的小样本学习方法。它基本上不涉及概率测度及大数定律等,因此不同于现有的统计方法。从本质上看,它避开了从归纳到演绎的传统过程,实现了高效的从训练样本到预报样本的“转导推理”,大大简化了通常的分类和回归等问题;(5)SVM 的最终决策函数只由少数的支持向量所确定,计算的复杂性取决于支持向量的数目,而不是样本空间的维数,这在某种意义上避免了“维数灾难”。(6)少数支持向量决定了最终结果,这不但可以帮助我们抓住关键样本、“剔除”大量冗余样本,而且注定了该方法不但算法简单,而且具有较好的“鲁棒”性。这种“鲁棒”性主要体现在:①增、删非支持向量样本对模型没有影响;②支持向量样本集具有一定的鲁棒性;③有些成功的应用中,SVM 方法对核的选取不敏感两个不足:(1) SVM算法对大规模训练样本难以实施由于SVM是借助二次规划来求解支持向量,而求解二次规划将涉及m阶矩阵的计算(m为样本的个数),当m数目很大时该矩阵的存储和计算将耗费大量的机器内存和运算时间。针对以上问题的主要改进有J.Platt的SMO算法、T.Joachims的SVM、C.J.C.Burges等的PCGC、张学工的CSVM以及O.L.Mangasarian等的SOR算法(2) 用SVM解决多分类问题存在困难经典的支持向量机算法只给出了二类分类的算法,而在数据挖掘的实际应用中,一般要解决多类的分类问题。可以通过多个二类支持向量机的组合来解决。主要有一对多组合模式、一对一组合模式和SVM决策树;再就是通过构造多个分类器的组合来解决。主要原理是克服SVM固有的缺点,结合其他算法的优势,解决多类问题的分类精度。如:与粗集理论结合,形成一种优势互补的多类问题的组合分类器。
个人公众号,欢迎关注
YouChouNoBB
发布者:全栈程序员-站长,转载请注明出处:https://javaforall.net/147758.html原文链接:https://javaforall.net


