
大家好,又见面了,我是你们的朋友全栈君。
RDN——Residual Dense Network—— 残差深度网络。RDN是基于深度学习的超分方法之一,发表于CVPR 2018。
网络结构
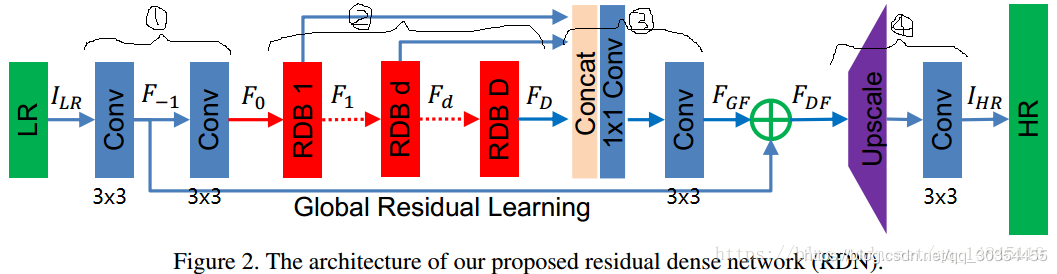

RDN网络结构分为4个部分:
- SFENet(Shallow Feature Extraction Net, 浅层特征提取网络);
- RDBs( Residual Dense Blocks, 残差稠密块);
- DFF(Dense Feature Fusion, 稠密特征块 );
- Up-Sampling Net(上采样网络)。
SFENet:
包含两个CONV层,用于提取浅层特征。
RDBs:
包含D个RDB,用于提取各层特征,一个RDB提取出一个局部特征。RDB结构如下图(c)所示:
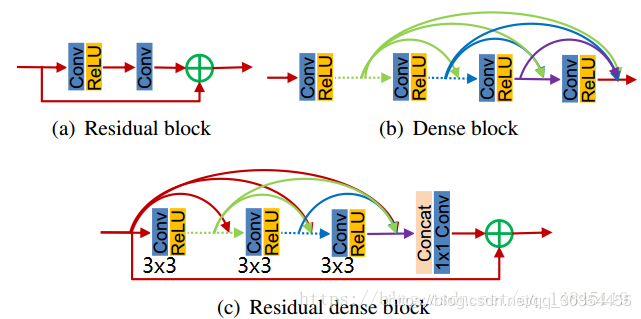
可以看出,RDB = Residual block(残缺块) + Dense block(稠密块)
由于网络深度的增加,每层CONV层的特征会逐渐分级(得到hierarchical features),因为有不同的感受野(receptive fileds)。而Hierarchical features对图像重建提供了重要信息, 我们要充分利用所有层的信息和特征。
一个RDB结构分为3个部分:
-
CM(Contiguous Memory 近邻记忆)
RDB含有C个[CONV+ReLU],CM机制会将上一个RDB的状态发送到当前RDB中的每一个CONV层,也就是图(c)的小桥们; -
LFF(Local Feature Fusion 局部特征融合)
LLF将前一个RDB的各个状态与当前RDB的所有CONV层融合在一起。
RDN中,前一个RDB输出的feature-map 是直接与当前RDB串联起来的,这时,减少feature的数量就很有必要了。我们使用一个11的CONV来减少feature的数量/控制输出信息:11CONV用于减少通道数,并保持nh,nw不变; -
LRL(Local Residual Learning 局部残差学习)
也就是将以下两者加起来,看c图下部的红箭头以及绿色加号:前一RDB的输出 + 上面LFF的1*1CONV的输出。引入LRL以进一步提高信息流、提高网络表示能力,以达到更好的性能。
DFF(Dense Feature Fusion, 稠密特征块 ):
DFF在全局上提取各层特征。包含两个部分:
- GFF(global feature fusion 全局特征融合)
GFF 用于将所有RDB提取到的特征融合在一起,得到全局特征。GFF分为两部分:1×1 CONV 融合一系列的特征(1*1CONV的作用就是减少通道数,并保持Nh, Nw)。3×3 CONV 为下一步的GRL进一步提取特征; - GRL(global residual learning 全局残差学习)
就是RDN结构图中的绿色加号。就是实现:浅层特征 + 所有RDB提取到的特征; - UPNet(Up-Sampling Net 上采样网络)
该模块表示网络最后的上采样+卷积操作。实现了输入图片的放大操作。
实现细节
- 除了用于融合局部或全局特征的CONV层的kernel size = 1×1 外,其他的CONV层都是 3×3的;
- kernel size = 3×3的CONV层,都用SAME padding 以保持inputsize不变
浅层特征提取层、局部全局特征融合层的CONV的filter数量都是G0 = 64; - 其他层(RDB中)的CONV的filter数量都是G,并使用ReLU作为其激活函数;
- 使用ESPCNN(Sub-Pixel)来提高粗分辨率特征,从而使得UPNet性能更好;
- RDN最后的CONV,若需要输出彩色高清图像,则可设置其输出的channel = 3;若需要输出灰度高清图像,可设置其输出的channel = 1。
讨论(与其他网络的区别)
Difference to DenseNet:
- 与DenseNet不同:移除了BN层,以提高运算速度降低计算复杂度和GPU内存的消耗;
- 与DenseNet不同:移除了Pooling层,防止其将像素级的信息给去除掉;
- 与DenseNet不同:使用GFF将各RDB提取的特征全部concat起来,充分利用。而DenseNet 整个网络中只使用每一个DenseBlock最后的输出。
Difference to SRDenseNet:
- 在RDB中,提取全局特征时不使用Dense Connection,取而代之的是
- DFF(Dense Feature Fusion, 稠密特征块,包含GFF和GRL)
损失函数:SRDenseNet使用L2 ;RDN使用L1(提高了性能,加快了收敛)。
Difference to MemNet:
- 损失函数:MemNet使用L2 ;RDN使用L1(提高了性能,加快了收敛);
- MemNet要用Bicubic插值方式对LR图片进行上采样,从而使LR图片达到所需的大小,这就导致特征提取和重建过程都在HR空间(高分辨率空间)中进行;而RDN从原始的LR图片(低分辨率图片)提取各层特征,很大程度上减少了计算的复杂度,并提高了性能;
- MemNet中包含了递归和门限单元,这使得当前层不能接收上一层的输入,而RDB的前后模块是有交互的
实验设置
数据集:
- 数据集: DIV2K(800 training imgs + 100 vali imgs + 100 testing imgs);
- 训练:DIV2K——800 training img + 5 vali img;
- 测试:五个standard benchmark datasets:Set5 [1], Set14 [33], B100 [18], Urban100 [8], and Manga109 [19]。
退化模型:
训练的输入图片(LR)使用DIV2K的高清图片通过下面3种退化模型得到:
- BI模型:Bicubic插值方式对高清图片进行下采样, 缩小比例为x2,x3,x4;
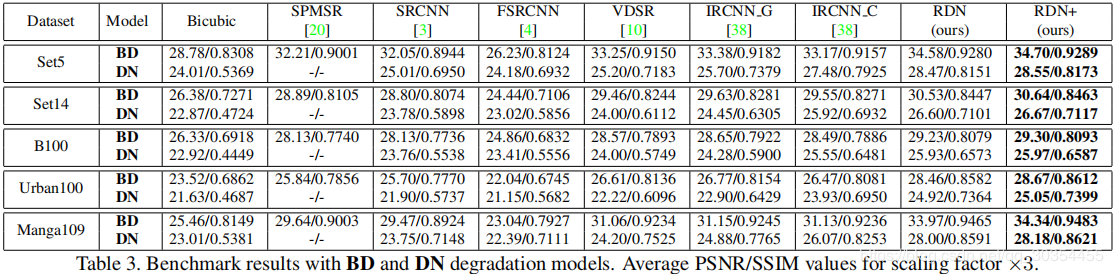
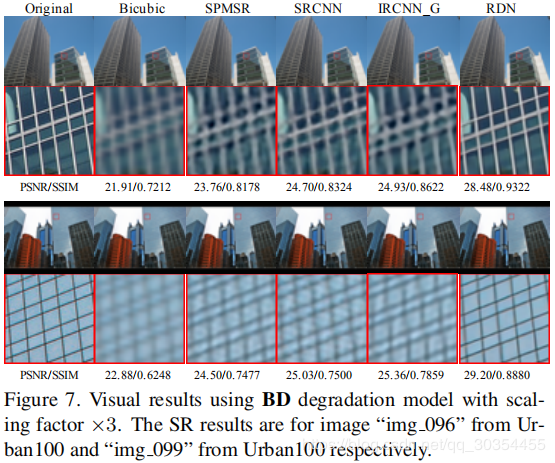
- BD模型:先对高清图片做(7*7卷积,1.6方差)高斯滤波,再对滤波后图片做下采样, 缩小比例为x3;
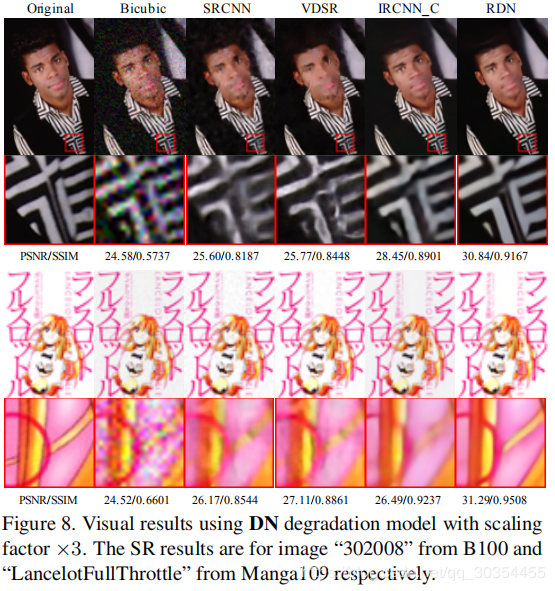
- DN模型:①Bicubic插值方式对高清图片进行下采样, 缩小比例为x3,②再加30%的高斯噪声。
实验结果
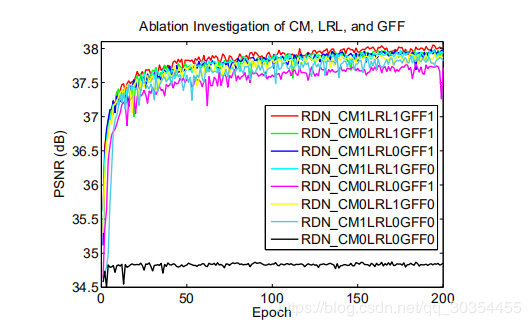
可看出, CM, LRL, and GFF 缺一不可,缺一个性能就下降。
- 在BI退化模型下:
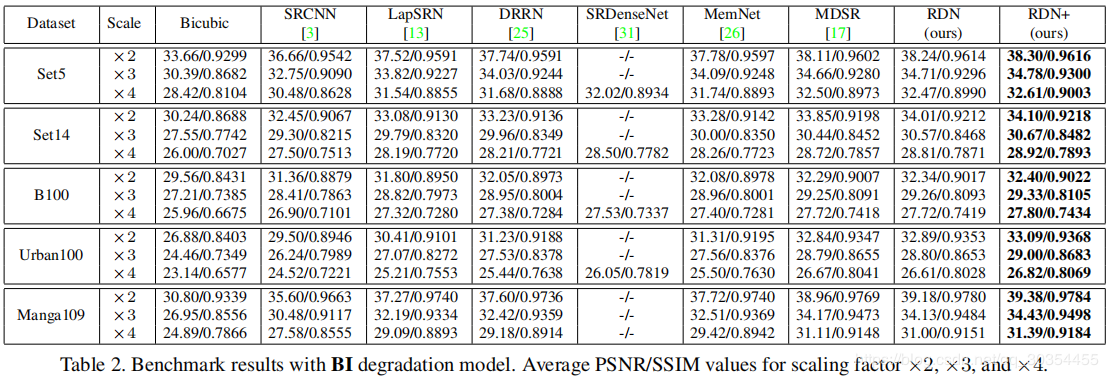
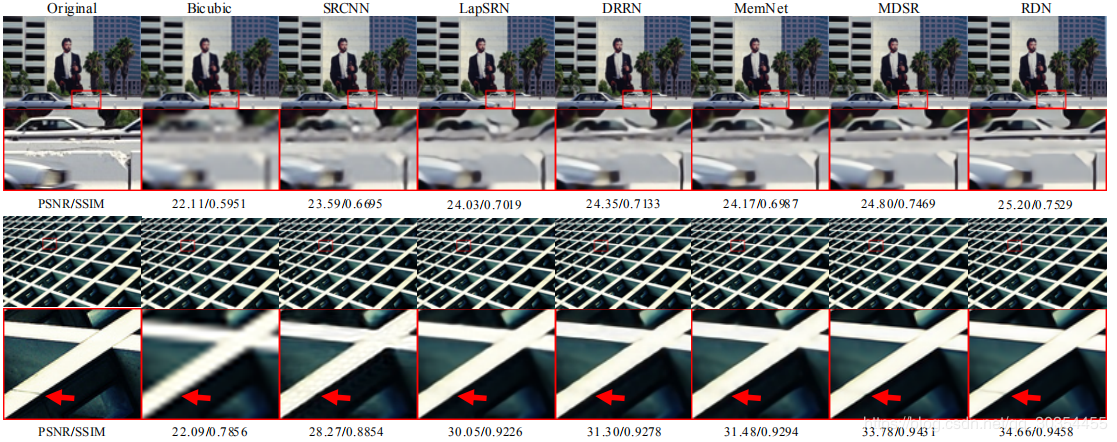
- 在BD和DN退化模型下:
参考博客
发布者:全栈程序员-站长,转载请注明出处:https://javaforall.net/150437.html原文链接:https://javaforall.net


