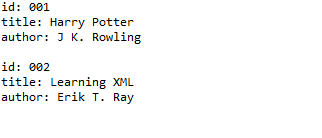java中采用dom4j解析xml文件「建议收藏」

java中采用dom4j解析xml文件「建议收藏」一.前言在最近的开发中用到了dom4j来解析xml文件,以前听说过来解析xml文件的几种标准方式;但是从来的没有应用过来,所以可以在google中搜索dmo4j解析xml文件的方式,学习一下dom4j解析xml的具体操作。二.代码详情dom4j是一个第三方开发组开发出的插件,所以在我们使用dom4jf的时候我们要去下载一下dom4j对应版本的jar导入在我们项目中。1…

大家好,又见面了,我是你们的朋友全栈君。

一.前言

   在最近的开发中用到了dom4j来解析xml文件,以前听说过来解析xml文件的几种标准方式;但是从来的没有应用过来,所以可以在google中搜索dmo4j解析xml文件的方式,学习一下dom4j解析xml的具体操作。

二.代码详情

   dom4j是一个第三方开发组开发出的插件,所以在我们使用dom4jf的时候我们要去下载一下dom4j对应版本的jar导入在我们项目中。

 1)xml文件:

1

2

3

4

5

6

7

8

9

10

11

<?xml version="1.0" encoding="UTF-8"?>

<books>

   <book id="001">

      <title>Harry Potter</title>

      <author>J K. Rowling</author>

   </book>

   <book id="002">

      <title>Learning XML</title>

      <author>Erik T. Ray</author>

   </book>

</books>

示例一:用List列表的方式来解析xml

SAXReader就是一个管道,用一个流的方式,把xml文件读出来

1

2

3

4

5

6

7

8

9

10

11

12

13

14

15

16

17

18

19

20

21

22

23

24

25

26

27

28

29

30

31

32

33

34

35

36

37

38

39

40

41

42

43

44

import java.io.File;

import java.util.List;


import org.dom4j.Attribute;

import org.dom4j.Document;

import org.dom4j.Element;

import org.dom4j.io.SAXReader;


public class Demo {


    public static void main(String[] args) throws Exception {

        SAXReader reader = new SAXReader();

        File file = new File("books.xml");

        Document document = reader.read(file);

        Element root = document.getRootElement();

        List<Element> childElements = root.elements();

        for (Element child : childElements) {

            //未知属性名情况下

            /*List<Attribute> attributeList = child.attributes();

            for (Attribute attr : attributeList) {

                System.out.println(attr.getName() + ": " + attr.getValue());

            }*/


            //已知属性名情况下

            System.out.println("id: " + child.attributeValue("id"));


            //未知子元素名情况下

            /*List<Element> elementList = child.elements();

            for (Element ele : elementList) {

                System.out.println(ele.getName() + ": " + ele.getText());

            }

            System.out.println();*/


            //已知子元素名的情况下

            System.out.println("title" + child.elementText("title"));

            System.out.println("author" + child.elementText("author"));

            //这行是为了格式化美观而存在

            System.out.println();

        }

    }


}

示例二:使用Iterator迭代器的方式来解析xml


1

2

3

4

5

6

7

8

9

10

11

12

13

14

15

16

17

18

19

20

21

22

23

24

25

26

27

28

29

30

31

32

33

34

35

36

37

38

39

40

41

42

43

44

45

import java.io.File;

import java.util.Iterator;


import org.dom4j.Attribute;

import org.dom4j.Document;

import org.dom4j.Element;

import org.dom4j.io.SAXReader;


public class Demo {

    public static void main(String[] args) throws Exception {

        SAXReader reader = new SAXReader();

        Document document = reader.read(new File("books.xml"));

        Element root = document.getRootElement();


        Iterator it = root.elementIterator();

        while (it.hasNext()) {

            Element element = (Element) it.next();


            //未知属性名称情况下

            /*Iterator attrIt = element.attributeIterator();

            while (attrIt.hasNext()) {

                Attribute a  = (Attribute) attrIt.next();

                System.out.println(a.getValue());

            }*/


            //已知属性名称情况下

            System.out.println("id: " + element.attributeValue("id"));


            //未知元素名情况下

            /*Iterator eleIt = element.elementIterator();

            while (eleIt.hasNext()) {

                Element e = (Element) eleIt.next();

                System.out.println(e.getName() + ": " + e.getText());

            }

            System.out.println();*/


            //已知元素名情况下

            System.out.println("title: " + element.elementText("title"));

            System.out.println("author: " + element.elementText("author"));

            System.out.println();

        }

    }

}

运行结果:

java中采用dom4j解析xml文件「建议收藏」

 示例三:创建xml文档并输出到文件

1

2

3

4

5

6

7

8

9

10

11

12

13

14

15

16

17

18

19

20

21

22

23

24

25

26

27

28

29

30

31

32

33

34

35

36

37

38

39

40

41

42

43

44

45

46

import java.io.File;

import java.io.FileOutputStream;


import org.dom4j.Document;

import org.dom4j.DocumentHelper;

import org.dom4j.Element;

import org.dom4j.io.OutputFormat;

import org.dom4j.io.XMLWriter;


public class Demo {

    public static void main(String[] args) throws Exception {

        Document doc = DocumentHelper.createDocument();

        //增加根节点

        Element books = doc.addElement("books");

        //增加子元素

        Element book1 = books.addElement("book");

        Element title1 = book1.addElement("title");

        Element author1 = book1.addElement("author");


        Element book2 = books.addElement("book");

        Element title2 = book2.addElement("title");

        Element author2 = book2.addElement("author");


        //为子节点添加属性

        book1.addAttribute("id", "001");

        //为元素添加内容

        title1.setText("Harry Potter");

        author1.setText("J K. Rowling");


        book2.addAttribute("id", "002");

        title2.setText("Learning XML");

        author2.setText("Erik T. Ray");


        //实例化输出格式对象

        OutputFormat format = OutputFormat.createPrettyPrint();

        //设置输出编码

        format.setEncoding("UTF-8");

        //创建需要写入的File对象

        File file = new File("D:" + File.separator + "books.xml");

        //生成XMLWriter对象,构造函数中的参数为需要输出的文件流和格式

        XMLWriter writer = new XMLWriter(new FileOutputStream(file), format);

        //开始写入,write方法中包含上面创建的Document对象

        writer.write(doc);

    }

}

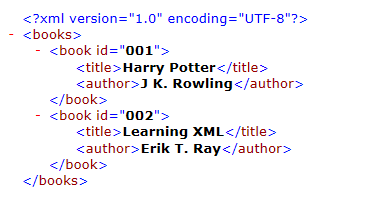
运行结果:

java中采用dom4j解析xml文件「建议收藏」 

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容, 请发送邮件至 举报,一经查实,本站将立刻删除。

发布者:全栈程序员-站长,转载请注明出处:https://javaforall.net/152021.html原文链接:https://javaforall.net

赞 (0)
全栈程序员-站长的头像全栈程序员-站长

相关推荐

  • anchorpoint什么意思_position relative

    anchorpoint什么意思_position relative转自 彻底理解position与anchorPoint如果已知layer的frame值,根据上面的结论,那么position的值便可以用下面的公式计算:position.x=frame.origin.x+anchorPoint.x*bounds.size.width;position.y=frame.origin.y+anchorPoint.y*

    2022年10月8日
  • C++临界锁CCriticalSection在线程中的使用

    C++临界锁CCriticalSection在线程中的使用#define_AFXDLL#include<afxmt.h>#include<iostream>usingnamespacestd;CCriticalSectioncritical;inttick=0;DWORDWINAPIFunc1(LPVOIDlpParam);DWORD__stdcallFunc1(LPVOIDlpParam){critical.Lock();tick+=10;cout&lt.

    2022年7月20日
  • Pytest(6)重复运行用例pytest-repeat[通俗易懂]

    Pytest(6)重复运行用例pytest-repeat[通俗易懂]前言平常在做功能测试的时候,经常会遇到某个模块不稳定,偶然会出现一些bug,对于这种问题我们会针对此用例反复执行多次,最终复现出问题来。自动化运行用例时候,也会出现偶然的bug,可以针对单个用例,

    2022年7月28日
  • hibernate与mybatis的区别优缺点对比

    hibernate与mybatis的区别优缺点对比现在对hibernate和mybatis做一下对比,便于大家更好的理解和学习,使自己在做项目中更加得心应手。第一方面:开发速度的对比就开发速度而言,Hibernate的真正掌握要比Mybatis来得难些。Mybatis框架相对简单很容易上手,但也相对简陋些。个人觉得要用好Mybatis还是首先要先理解好Hibernate。比起两者的开发速度,不仅仅要考虑到两者的特性及性能,更要根据项目需求去考虑究竟哪一个更适合项目开发,比如:一个项目中用到的复杂查询基本没有,就是简单的增删改查,这样选择hiberna

    2022年9月11日
  • yum 安装nginx_yum安装nginx

    yum 安装nginx_yum安装nginx前言:日常外出工作系统都是最小化安装,导致很多包都无法下载,需要自己手动安装包yum源以centos7.5为例在官网下载CentOS-7-x86_64-Everything-1804.iso上传到对应的服务器将镜像源挂载到对应的目录mount-oloop/opt/CentOS-7-x86_64-Everything-1804.iso/opt/yumrepo/tips:目录可以自定义修改路径/etc/yum.repos.dvirhel79.repo[rhel79]na

    2022年8月12日
  • 浅析currentHashmap的理解

    浅析currentHashmap的理解1,currentHashMap的介绍currentHashMap是线程安全并且高效的一种容器,我们就需要研究一下currentHashMap为什么既能够保证线程安全,又可以保证高效的操作currentHashMap使用的原因为什么使用currentHashMap,这时候我们就需要和HashMap以及HashTable进行比较HashMap线程不安全的原因?在多线程的情况下,HashMa…

    2022年6月18日

发表回复

您的邮箱地址不会被公开。 必填项已用 * 标注

关注全栈程序员社区公众号