softmax损失函数

softmax损失函数cnn进行前向传播阶段,依次调用每个Layer的Forward函数,得到逐层的输出,最后一层与目标函数比较得到损失函数,计算误差更新值,通过反向传播逐层到达第一层,所有权值在反向传播结束时一起更新。losslayer是CNN的终点,接受两个Blob作为输入,其中一个是CNN的预测值,另一个是真实标签。损失层则将这两个输入进行一系列运算,得到当前网络的损失函数(LossFunction),

大家好,又见面了,我是你们的朋友全栈君。

一:神经网络中的损失函数

cnn进行前向传播阶段,依次调用每个Layer的Forward函数,得到逐层的输出,最后一层与目标函数比较得到损失函数,计算误差更新值,通过反向传播逐层到达第一层,所有权值在反向传播结束时一起更新。

loss layer 是CNN的终点,接受两个Blob作为输入,其中一个是CNN的预测值,另一个是真实标签。损失层则将这两个输入进行一系列运算,得到当前网络的损失函数(Loss Function),一般记做L(θ)其中θ是当前网络权值构成的向量空间。机器学习的目的是在权值空间中找到让损失函数L(θ) 最小的权值θ(opt),可以采用一系列最优化方法(如SGD方法)逼近权值θ(opt)。

损失函数是在前向传播计算中得到的,同时也是反向传播的起点。


二:Softmax函数

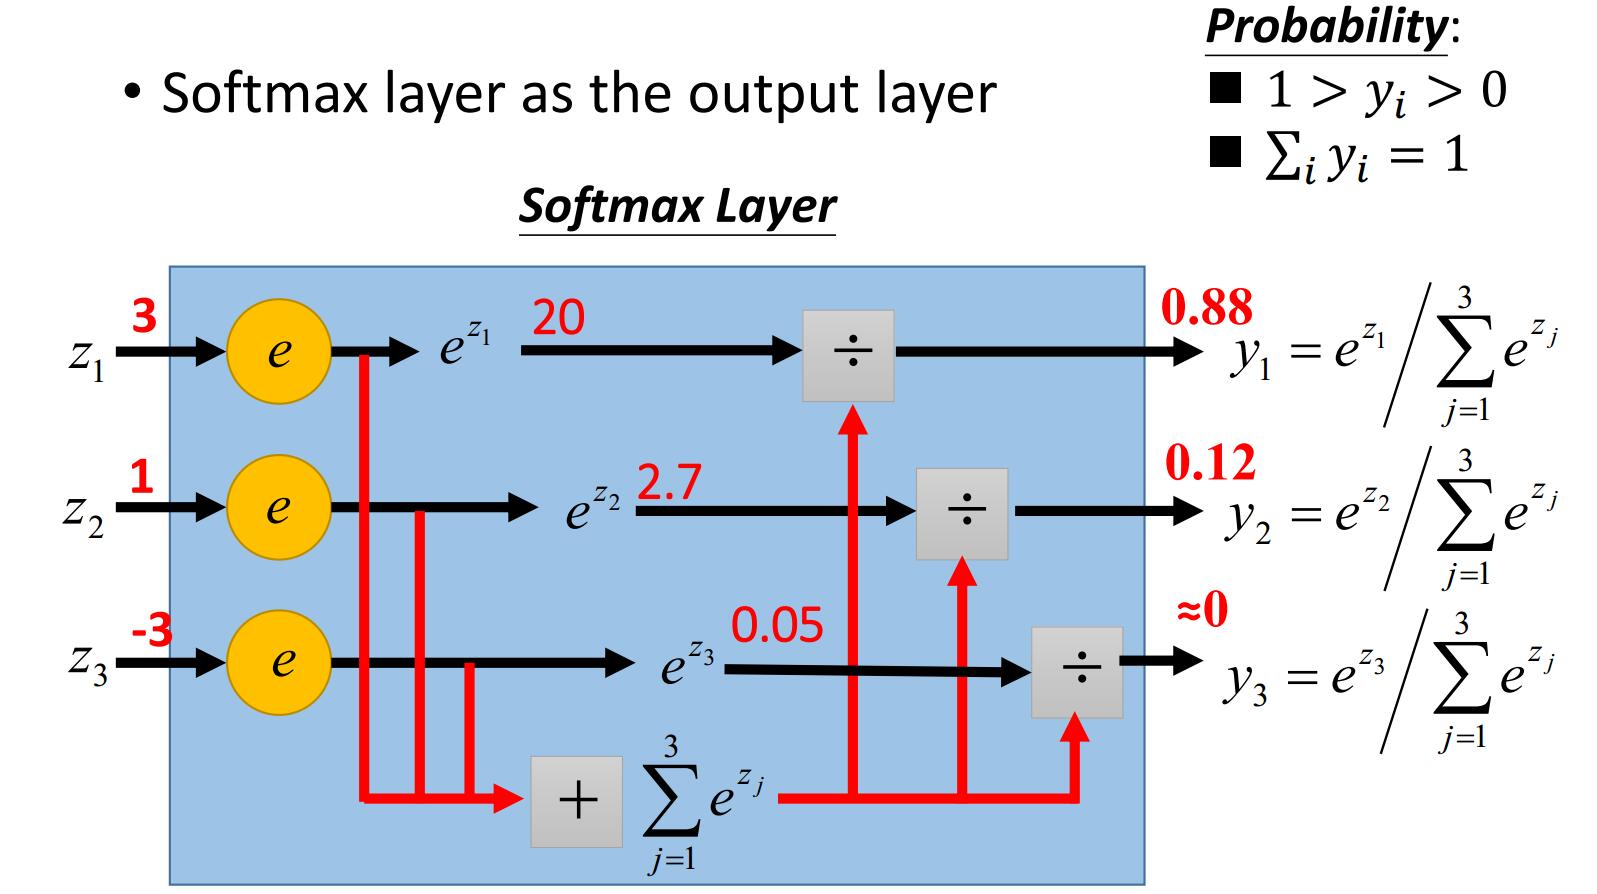
假设有K个类别,Softmax计算过程为:


softmax损失函数其中,j=0,1,2,3,4,5,…,K-1


下面图更直观:


softmax损失函数

softMax的结果相当于输入图像被分到每个标签的概率分布,该函数是单调增函数,即输入值越大,输出也就越大,输入图像属于该标签的概率就越大。

神评论:SVM只选自己喜欢的男神,Softmax把所有备胎全部拉出来评分,最后还归一化一下

对softmax的结果计算交叉熵分类损失函数为:
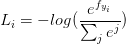
softmax损失函数

取log里面的值就是这组数据正确分类的Softmax值,它占的比重越大,这个样本的Loss也就越小,这种定义符合我们的要求.


三:wiki百科对softmax函数的定义:

In mathematics, the softmax function, or normalized exponential function,[1]:198 is a generalization of the logistic function that “squashes” a K-dimensional vector {\displaystyle \mathbf {z} }\mathbf {z}  of arbitrary real values to a K-dimensional vector {\displaystyle \sigma (\mathbf {z} )}\sigma (\mathbf {z} ) of real values in the range [0, 1] that add up to 1. The function is given by

{\displaystyle \sigma (\mathbf {z} )_{j}={\frac {e^{z_{j}}}{\sum _{k=1}^{K}e^{z_{k}}}}}\sigma (\mathbf {z} )_{j}={\frac {e^{z_{j}}}{\sum _{k=1}^{K}e^{z_{k}}}}    for j = 1, …, K.

The softmax function is used in various multiclass classification methods, such as multinomial logistic regression,[1]:206–209 multiclass linear discriminant analysis, naive Bayes classifiers, and artificial neural networks.[2] Specifically, in multinomial logistic regression and linear discriminant analysis, the input to the function is the result of K distinct linear functions, and the predicted probability for the j‘th class given a sample vector x and a weighting vector w[further explanation needed] is:

{\displaystyle P(y=j\mid \mathbf {x} )={\frac {e^{\mathbf {x} ^{\mathsf {T}}\mathbf {w} _{j}}}{\sum _{k=1}^{K}e^{\mathbf {x} ^{\mathsf {T}}\mathbf {w} _{k}}}}}{\displaystyle P(y=j\mid \mathbf {x} )={\frac {e^{\mathbf {x} ^{\mathsf {T}}\mathbf {w} _{j}}}{\sum _{k=1}^{K}e^{\mathbf {x} ^{\mathsf {T}}\mathbf {w} _{k}}}}}

This can be seen as the composition of K linear functions {\displaystyle \mathbf {x} \mapsto \mathbf {x} ^{\mathsf {T}}\mathbf {w} _{1},\ldots ,\mathbf {x} \mapsto \mathbf {x} ^{\mathsf {T}}\mathbf {w} _{K}}\mathbf {x} \mapsto \mathbf {x} ^{\mathsf {T}}\mathbf {w} _{1},\ldots ,\mathbf {x} \mapsto \mathbf {x} ^{\mathsf {T}}\mathbf {w} _{K} and the softmax function (where {\displaystyle \mathbf {x} ^{\mathsf {T}}\mathbf {w} }\mathbf {x} ^{\mathsf {T}}\mathbf {w}  denotes the inner product of {\displaystyle \mathbf {x} }\mathbf {x}  and {\displaystyle \mathbf {w} }\mathbf {w} ). The operation is equivalent to applying a linear operator defined by {\displaystyle \mathbf {w} }\mathbf {w}  to vectors {\displaystyle \mathbf {x} }\mathbf {x} , thus transforming the original, probably highly-dimensional, input to vectors in a K-dimensional space {\displaystyle R^{K}}{\displaystyle R^{K}}.

注:

softmax函数的本质就是将一个K 
维的任意实数向量压缩(映射)成另一个K维的实数向量,其中向量中的每个元素取值都介于(0,1)之间。

x,w 点积就是上图中Z1,Z2,Z3的计算。将高维的输入x转化一个K维的实数,即K类的各自的概率。


四:后记:

理想的分类器应当是除了真实标签的概率为1,其余标签概率均为0,这样计算得到其损失函数为-ln(1)=0.

损失函数越大,说明该分类器在真实标签上的分类概率越小,性能也就越差。

当损失函数接近正无穷时表明训练发散,需要调小学习速率。

在ImageNet-1000分类问题中,初始状态为均匀分布,每个类别的分类概率均为0.001,此时损失函数-ln(0.001)=ln(1000)=6.90775..,

当loss总在6.9左右时,说明没有训练收敛的迹象,尝试调大学习速率,或者修改权值初始化方式。


参考:

知乎

http://blog.csdn.net/u014422406/article/details/52805924

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容, 请发送邮件至 举报,一经查实,本站将立刻删除。

发布者:全栈程序员-站长,转载请注明出处:https://javaforall.net/153113.html原文链接:https://javaforall.net

赞 (0)
全栈程序员-站长的头像全栈程序员-站长


相关推荐

  • 【转载】一些VS2013的使用技巧

    【转载】一些VS2013的使用技巧

    2021年11月18日
  • redis过期key的删除策略[通俗易懂]

    前言在使用redis的过程中,不免会产生过期的key,而这些key过期后并不会实时地马上被删除,当这些key数量累积越来越多,就会占用很多内存,因此在redis底层同时使用了三种策略来删除这些key。第一种策略:被动删除当读/写一个key时,redis首先会检查这个key是否存在,如果存在且已过期,则直接删除这个key并返回nil给客户端。第二种策略:定期删除redis中有一系列的定期任务(serverCron),这些任务每隔一段时间就会运行一次,其中就包含清理过期key的任务,运行频率由配置文件

    2022年4月8日
  • 程序员有哪些强迫症?听知乎网友为你现身说法[通俗易懂]

    程序员有哪些强迫症?听知乎网友为你现身说法

    2022年3月4日
  • windows查看mysql版本(三种方法)

    windows查看mysql版本(三种方法)方法一:在mysql的命令窗口状态下:status;回车即可方法二:在cmd命令状态下:mysql–help回车即可方法三:在mysql命令状态下:selectversion();回车即可(如果,该贴完美解决你的问题,请点一个赞

    2022年10月6日
  • c实现set集合

    c实现set集合集合有点编程语言会带有,有的没有。但是我想redis的集合set你一定听说过或者用过。下面咱们用链表来实现set相信有了前面的基础我们可以很容易的实现set集合需要引入我的链表的list.c和list.h头文件////set.h//set////Createdbybikangon16/9/18.//Copyright(c)2016年bikang.Allri

    2022年5月9日
  • Makefile常用模板「建议收藏」

    Makefile常用模板「建议收藏」做开发的特别是C/C++开发者一般都会用到Makefile,然而多数时候在公司做项目都不需要自己去写Makefile,仅仅停留在能看懂的基础上。因为make命令编译实在是太方便了,所以自己写写小项目用一用还是挺好的。网上关于Makefile教程也很多,总结一下近几年用到的常用脚本,方便自己查阅,如果能帮到别人那便是极好的^_^。单文件项目其实一个文件的项目也没必要写Makefil…

    2022年5月31日

发表回复

您的邮箱地址不会被公开。 必填项已用 * 标注

关注全栈程序员社区公众号