
Jetbrains全系列IDE使用 1年只要46元 售后保障 童叟无欺
哈希 Hash 算法介绍
哈希算法也叫散列算法, 不过英文单词都是 Hash, 简单一句话概括, 就是可以把任意长度的输入信息通过算法变换成固定长度的输出信息, 输出信息也就是哈希值, 通常哈希值的格式是16进制或者是10进制, 比如下面的使用 md5 哈希算法的示例
md5("123456") => "e10adc3949ba59abbe56e057f20f883e"主要特点:
•不可逆 从哈希值不能推导出原始数据, 所以Hash算法广泛应用在现代密码体系中•无碰撞 不同的信息进行哈希后得到的值应该是不同的, 但是从理论上来说, 哈希算法其实是有可能发生碰撞的, 输入的信息是无穷的, 而输出的哈希值长度是固定的, 所以是有限的。好比要把10个苹果放到9个抽屉里面, 肯定会有一个抽屉装了多个苹果, 只不过哈希算法的碰撞的概率是非常小的, 比如128位的哈希值, 就有2的128次方的空间。•效率高 在处理比较大的原生值时, 也能能快速的计算出哈希值•无规律 原始输入信息修改一点信息, 得到的哈希值也是大不相同的
哈希算法的实现有很多, 常见的有 MD5, SHA-1, 还有像 C#, Java 一些语言都有直接的 GetHashCode(), hashCode() 函数可以直接来用。
分布式存储场景
在互联网场景中, 通常面对的都是海量的数据,海量的用户, 那为了要满足大量数据的写入和查询, 以及高可用, 一台单机的存储服务器肯定是不能满足需求的, 通常需要使用多台服务器形成分布式存储。
场景描述:
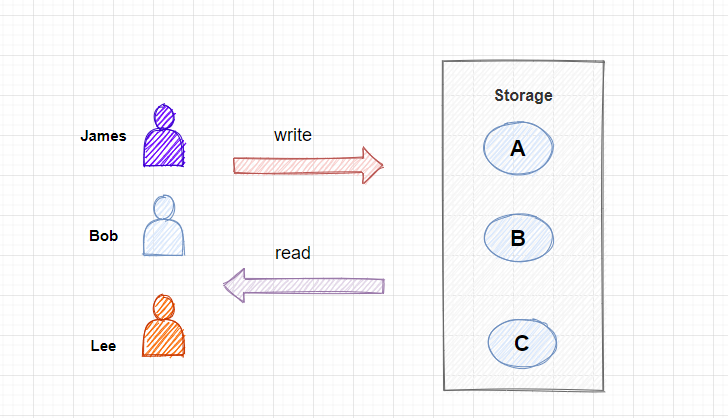
在本文中, 为了方便大家更好的理解, 这里列出了一个简单的例子, 有三位用户, 分别是 James、 Bob、 Lee, 我们需要把用户的图片写入到存储服务器节点, 这里有ABC三个节点, 而且当查询用户的图片时, 还需要快速定位到这个用户的图片是在哪个节点存储的, 然后直接从这个节点进行查询, 需要满足高效率的查询。

实现思路:
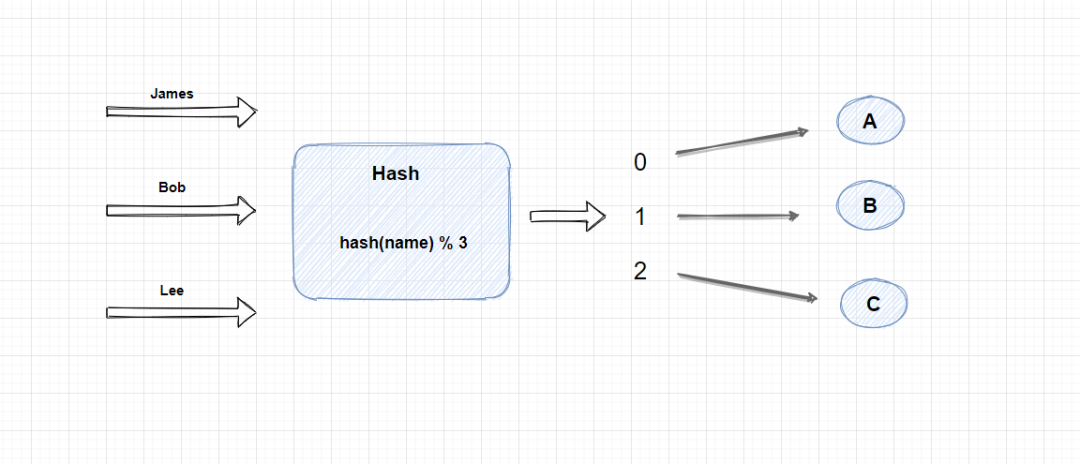
首先,我们可以对用户标识进行 Hash 计算, 这里我为了方便演示, 使用了用户名作为Hash对象, 当然你还可以对用户的IP或者是UserId 进行Hash计算, Hash计算后会生成一个int类型的数字, 然后再根据存储节点的数量进行取模, 这里的公式就是 hash(name) % 3, 计算得出的结果只有三种情况, 分别是 0,1,2, 然后我们再把这三种结果和三个存储节点做一个映射, 0 ==> A, 1 ==> B, 2 == C。因为Hash算法对一个值多次计算后都会得到同样的hash值, 所以上面的公式, 一个用户的图片每次都会固定的写入的其中一个节点, 这样做查询的话, 也可以通过hash算法快速找到这个用户的图片所在的节点。
缺点:
上面我们使用Hash算法实现了负载均衡, 可以根据用户名路由到图片所在的节点, 但是上面的方法也有一个很大的缺点, 那就是当服务器的数量增加或者减少时, 我们通过Hash算法生成的路由规则就再不准确了。
试想一下, 如果新增或者减少一个节点, 上面的公式就会变成 hash(name) % 4 或者 hash(name) % 2, 这里的关键点是, 我们之前用3取模, 现在变成用4或者2取模, 结果当然大概率是不一样了, 当然如果 Hash后是12的话,用3或者4取模得到的结果都是为0, 不过这种概率比较小。
这个问题带来的影响是, 路由规则不再准确, 大部分的查询请求都扑了空。那么如何解决这个问题呢?相信有的同学这时应该有了一些想法, 是的没错, 关键点就在于, 不管节点的数量怎么变化, 都应该使用一个固定的值来进行取模!只有这样才能保证每次进行Hash计算后, 得出的结果是不变的!
一致性Hash算法
同样的,一致性Hash算法也是利用取模的方式, 不过通常是用一个很大的数字进行求模, 你可以用整数的最大值 int.Max, 2的32次方, 当然这个并没有要求, 不过越大的数字, 平均分配的概率就越大(后面会具体介绍这个问题)。
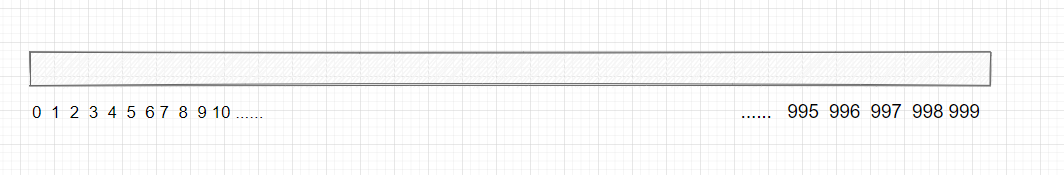
为了方便理解, 这里我用 1000 来取模, 我们可以用一个长度为1000的数组表示它,就像这样
接下来, 我们先不对用户的图片进行Hash处理, 而是先对每个节点进行 Hash 处理和映射, 现在的公式分别是 hash(A) % 1000, hash(B) % 1000,hash(C) % 1000, 这样得出的结果一定是在0-999 之间, 然后把这个值映射到数组中, 在代码中, 你可以用一个字典集合来保存这个映射关系。
对应的存储节点和数组的映射可能如下:
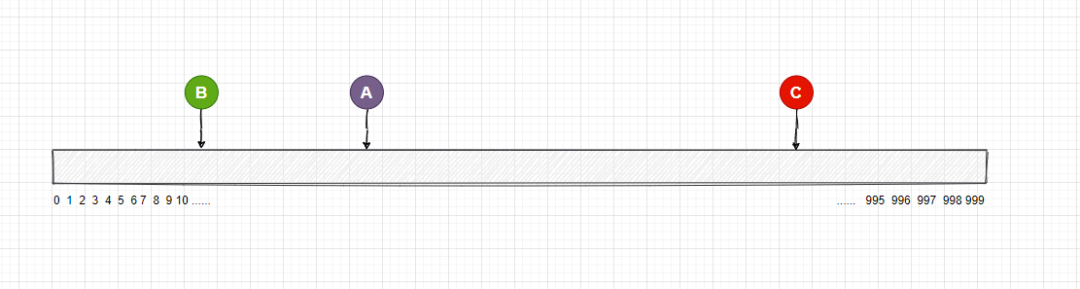
那现在用户的图片怎么和存储节点对应呢?因为存储节点已经映射到了数组上, 我们现在可以通过范围区间的方式, 来找到对应的节点, 映射在数组上的图片可以向右查找, 找到了一个节点, 那么这个图片就属于这个节点, 当往右查找到最大值时,再回到最左边从0开始。
我在图中用不同的颜色标记了每个存储服务器的范围区间, 你可以理解一下

接下来, 我们就需要对用户的图片进行Hash计算取模,同样的,计算结果一定还是在0-999的范围内, 然后再把这些值映射到数组上, 映射的结果可能如下图:
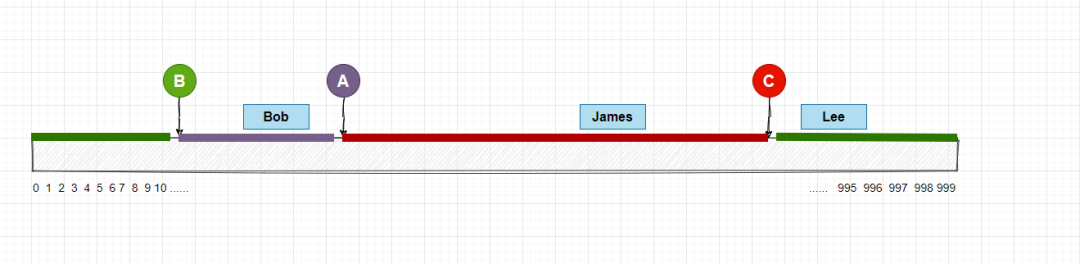
这样就可以通过往右查找的方式, 找到用户的图片相对应的存储节点! 总结下来上面做了几件事情, 首先我们取一个固定的并且比较大的整数进行求模, 然后在对每个节点进行Hash计算求模, 这样可以找出每个节点所对应的范围区间, 最后再把用户的图片进行Hash计算求模, 最后根据范围区间确定图片的所在的存储节点。
那我们看看使用了这种方式, 当存储节点的增加和减少时会有什么影响?
节点增加场景
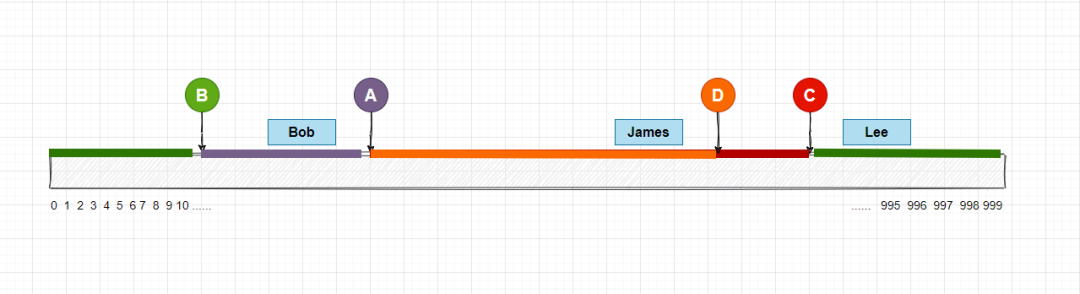
这里我新增了一个存储节点D, 经过Hash计算后映射在数组上, 这样的话, 用户 James 本来是路由到C节点的,现在被路由到了D节点, 不过我们添加了D节点后, 受到影响的也只有C节点, 其实不管D节点映射到数组哪一个位置, 都只会有一个节点会受到影响, 其他的节点可以正常使用。
那么这种情况下, 如何做数据迁移? 我的思路是, 我们需要把C节点全部数据重新进行Hash计算, 然后根据计算结果, 一部分会移动到D节点, 一部分继续保留在C节点。
节点减少场景
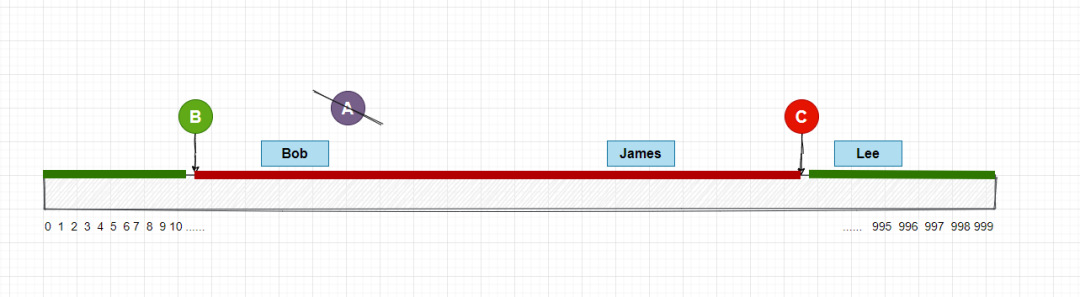
假如现在 A 节点在晚上20点宕机了, 那么本来应该路由到A节点的数据, 现在就被路由到了节点C, 也就是图中的 Bob的数据, 但是这种情况下, 其他的节点是不会受到节点变动的影响, 等到晚上21点时, A节点又恢复了正常。
这种情况的数据迁移的思路是, 当A节点宕机后, 数据需要全部复制到C节点, 当A节点恢复正常后, 再把C节点20:00至21:00的数据重新Hash计算, 然后根据计算的结果, 一部分会移动到A节点, 一部分继续保留在C节点。
节点分布不均匀
因为节点是随机的散列分布在数组上,所以有的节点的范围比较大, 而有的节点的范围比较小, 这样我们的数据分布就不均匀, 有的节点服务器会有比较大的请求压力。
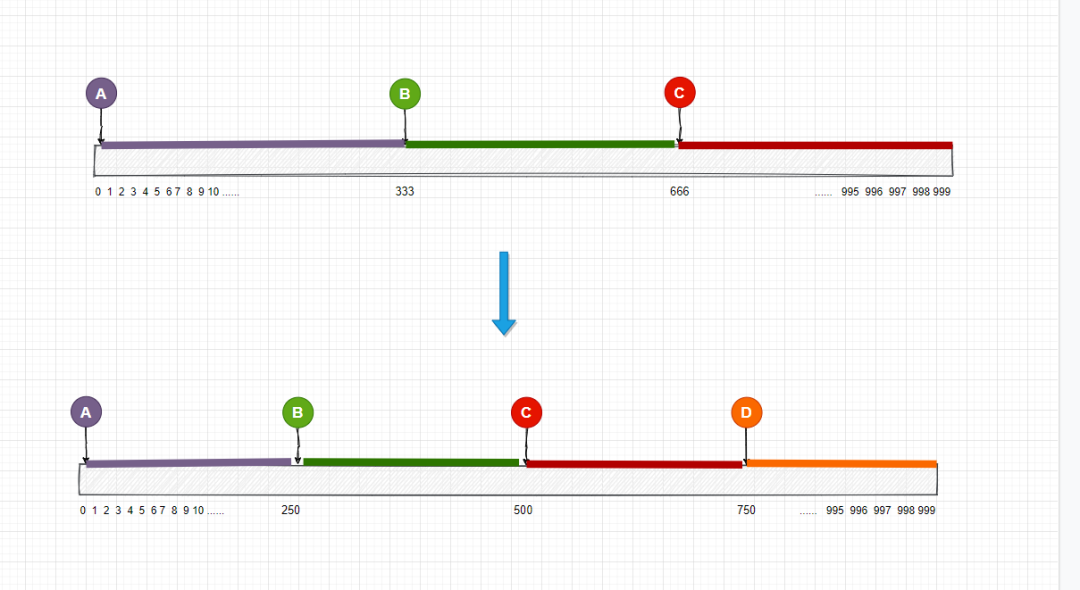
这种情况有的同学可能会说, 我可以根据数组的长度(1000)和节点(3)的个数, 求出平均值, 然后就可以平均的把节点散列到数组上, 这样每个节点的请求压力都是一样的, 这种方式看起来没什么问题, 但是当添加节点或者移除节点的时候, 每个节点的覆盖范围都需要重新计算, 然后也需要迁移数据, 影响的范围还是挺大的。
虚拟节点
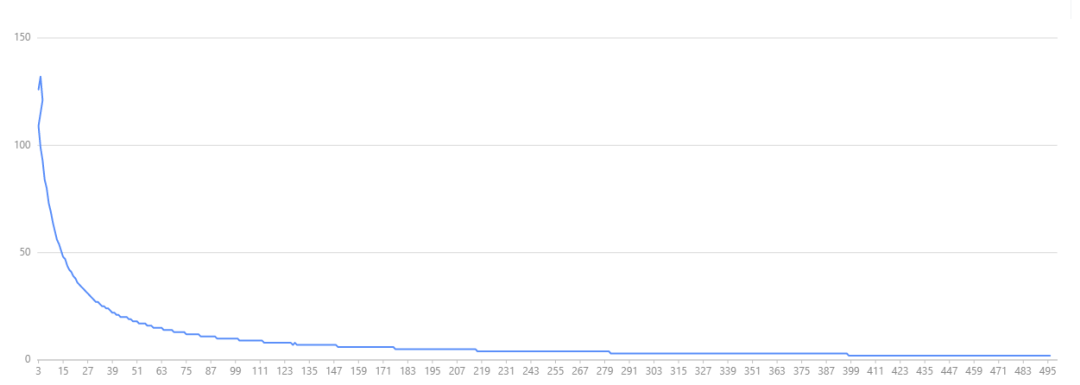
之前我们用了三个存储节点, 发现有分布不均匀的情况, 上图是我做了一个简单的测试, x 轴是节点的数量, y 轴是标准偏差, 根据这个图的趋势得出的结论是, 节点越多的时候, 标准偏差也就越小, 节点分布的就越均匀。
实际中,服务器节点是有限的, 增加很多节点也肯定是不现实的, 那么就可以在服务器节点不变的情况下, 引入虚拟节点, 也叫做影子节点。
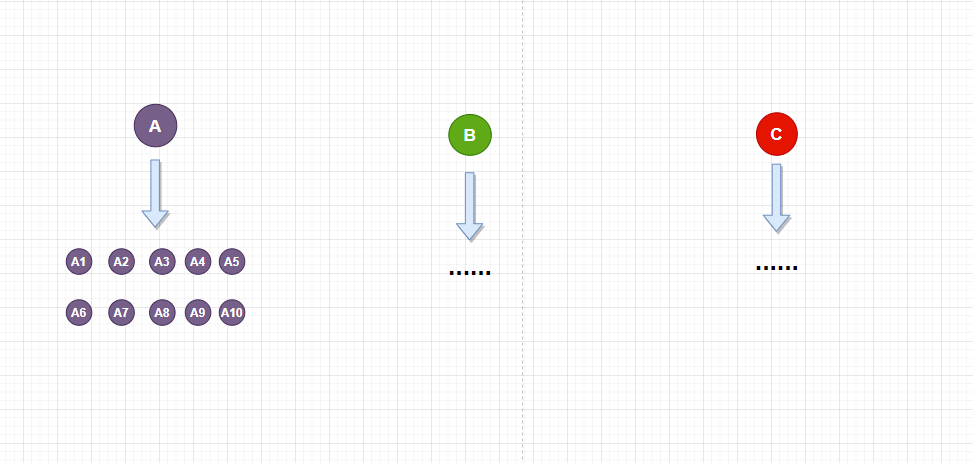
还记得我们之前是怎么对节点做hash映射的吗?公式是 hash(node) / 1000, 我们现在可以给A节点创建10个虚拟节点, 分别是 A1, A2,A3…, A10, 对应的虚拟节点的公式就是 hash(A1) / 1000 等等。这些虚拟节点和真实节点存在映射关系, 当图片映射到A节点的任意一个虚拟节点上时, 我们就把这个图片路由到A存储节点, 现在数组上已经有了30个虚拟节点做映射, 分布也比之前更均匀了, 当然你也可以创建更多的虚拟节点, 这些真实节点和虚拟节点的映射关系要保存在内存中或者是数据库中, 现在我们的映射图如下, 这里我给每个真实节点都添加了3个虚拟节点。
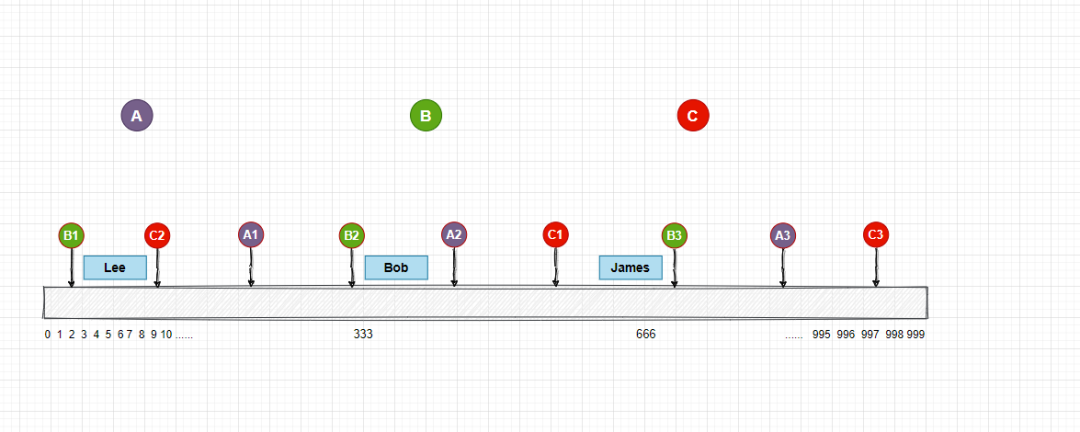
引入了虚拟节点后, 在数组的映射看起来平均很多了, 现在我们每个真实节点的请求压力都是一样的了, 接下来, 我们还要看下这个方案在节点的变动情况下应该怎么处理。
增加节点
现在增加了一个节点D,按照上面的规则, 实际上是要添加 D 的虚拟节点, D1,D2,D3,然后散列映射到数组上,如下图所示:
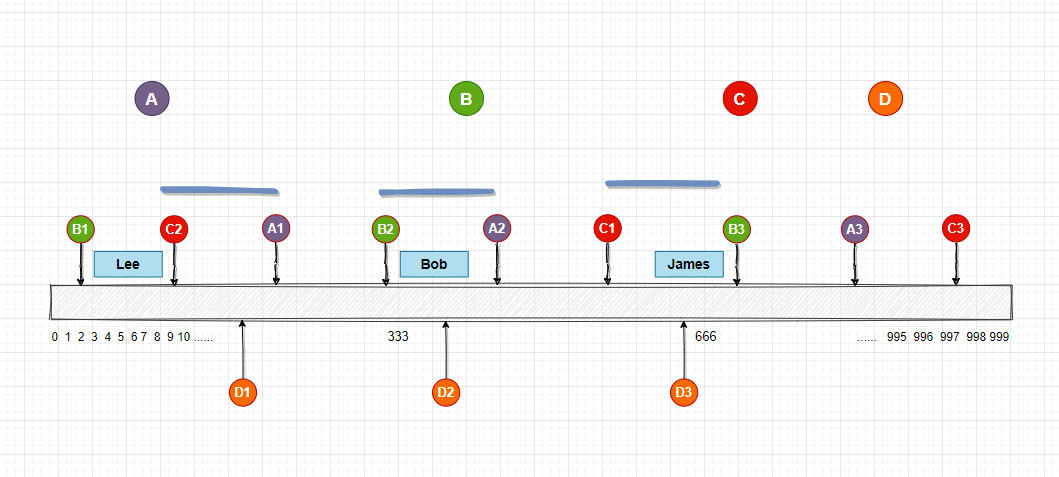
先看最左边, D1 插入到了 C2 和 A1 之间, 而A1和A节点对应, D1节点和D节点对应, 也就是说A节点的一部分数据要迁移到D节点, 这里我的思路是, 当在节点写入数据时, 同时把虚拟节点的信息也记录下来,这样就很方便做数据迁移了, 我们可以在A节点中只找出A1虚拟节点的数据, 而不是全部, 然后Hash计算映射后, 根据计算结果,一部分同步到D节点, 一部分保持不变。后边的数据也可以按照这个思路进行数据迁移。
节点减少
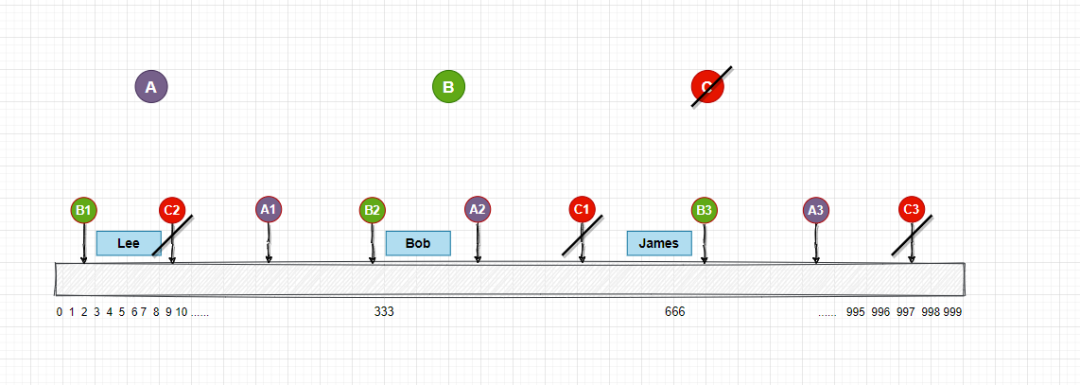
当C节点下线的时候, 我们同时要移除和C节点对应的虚拟节点,C1,C2,C3, 然后就是数据迁移的工作了, 根据图中的表示, 可以直接把 C节点中的C2节点的数据迁移到A1节点, C1迁移到B3,C3迁移到B1中, 完成!
总结
本文介绍了哈希和一致性哈希算法, 以及提供了一些数据迁移的思路, 回顾下这个方案, 首先需要定义一个比较大的固定值用于取模, 然后创建和真实节点对应的虚拟节点, 最后再把虚拟节点映射到数组上, 通过范围区间的方法, 来确定图片属于哪一个存储节点。
可能还有同学会说, 一致性hash也有缓存失效的时候,也需要手动迁移数据。是的, 维基百科对一致性Hash的定义是, 当节点的数量变动时,可以允许少部分的数据进行迁移, 而大部分的数据还是不变的。
上面的一致性Hash算法其实是经典的哈希环算法, 当然还有其他的算法, 比如跳跃一致性哈希法, 有兴趣也可以看一下, 以上内容均为个人理解, 如果错误, 可以指出, 希望对您有用!
发布者:全栈程序员-站长,转载请注明出处:https://javaforall.net/164574.html原文链接:https://javaforall.net



