
大家好,又见面了,我是你们的朋友全栈君。如果您正在找激活码,请点击查看最新教程,关注关注公众号 “全栈程序员社区” 获取激活教程,可能之前旧版本教程已经失效.最新Idea2022.1教程亲测有效,一键激活。
Jetbrains全系列IDE使用 1年只要46元 售后保障 童叟无欺
背景
一致性哈希算法在 1997 年由麻省理工学院的 Karger 等人在解决分布式 Cache 中提出的,设计目标是为了解决因特网中的热点问题,初衷和 CARP 十分类似。一致性哈希修正了 CARP 使用的简单哈希算法带来的问题,使得 DHT 可以在 P2P 环境中真正得到应用。
但现在一致性哈希算法在分布式系统中也得到了广泛应用,研究过 Memcached 缓存数据库的人都知道,Memcached 服务器端本身不提供分布式 Cache 的一致性,而是由客户端来提供,具体在计算一致性哈希时采用如下步骤:
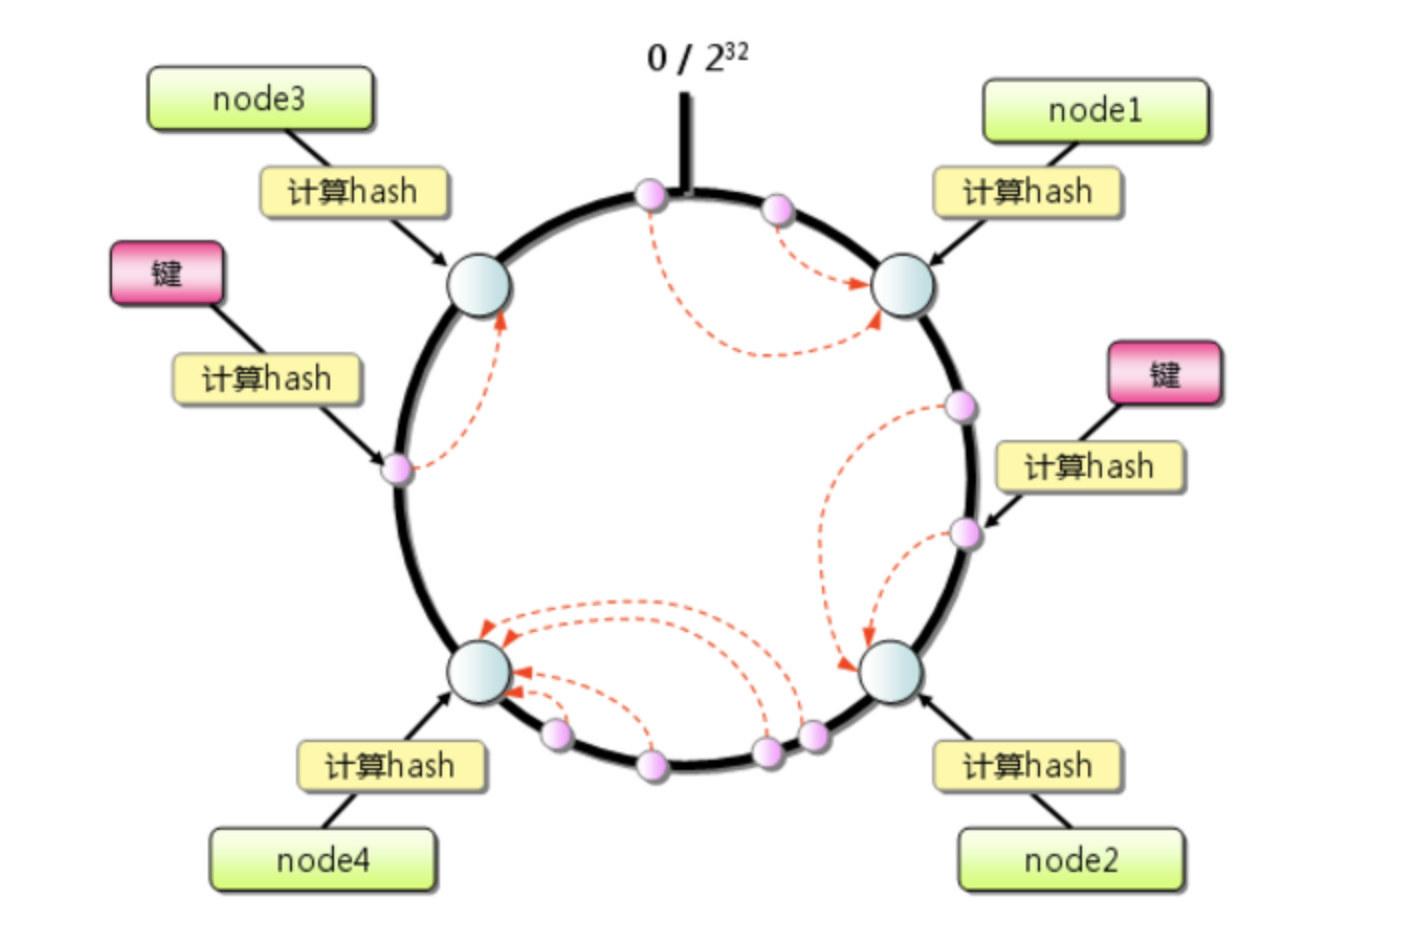
- 首先求出 Memcached 服务器(节点)的哈希值,并将其配置到
0~2^32的圆(continuum)上。 - 然后采用同样的方法求出存储数据的键的哈希值,并映射到相同的圆上。
- 然后从数据映射到的位置开始顺时针查找,将数据保存到找到的第一个服务器上。如果超过
2^32仍然找不到服务器,就会保存到第一台 Memcached 服务器上。

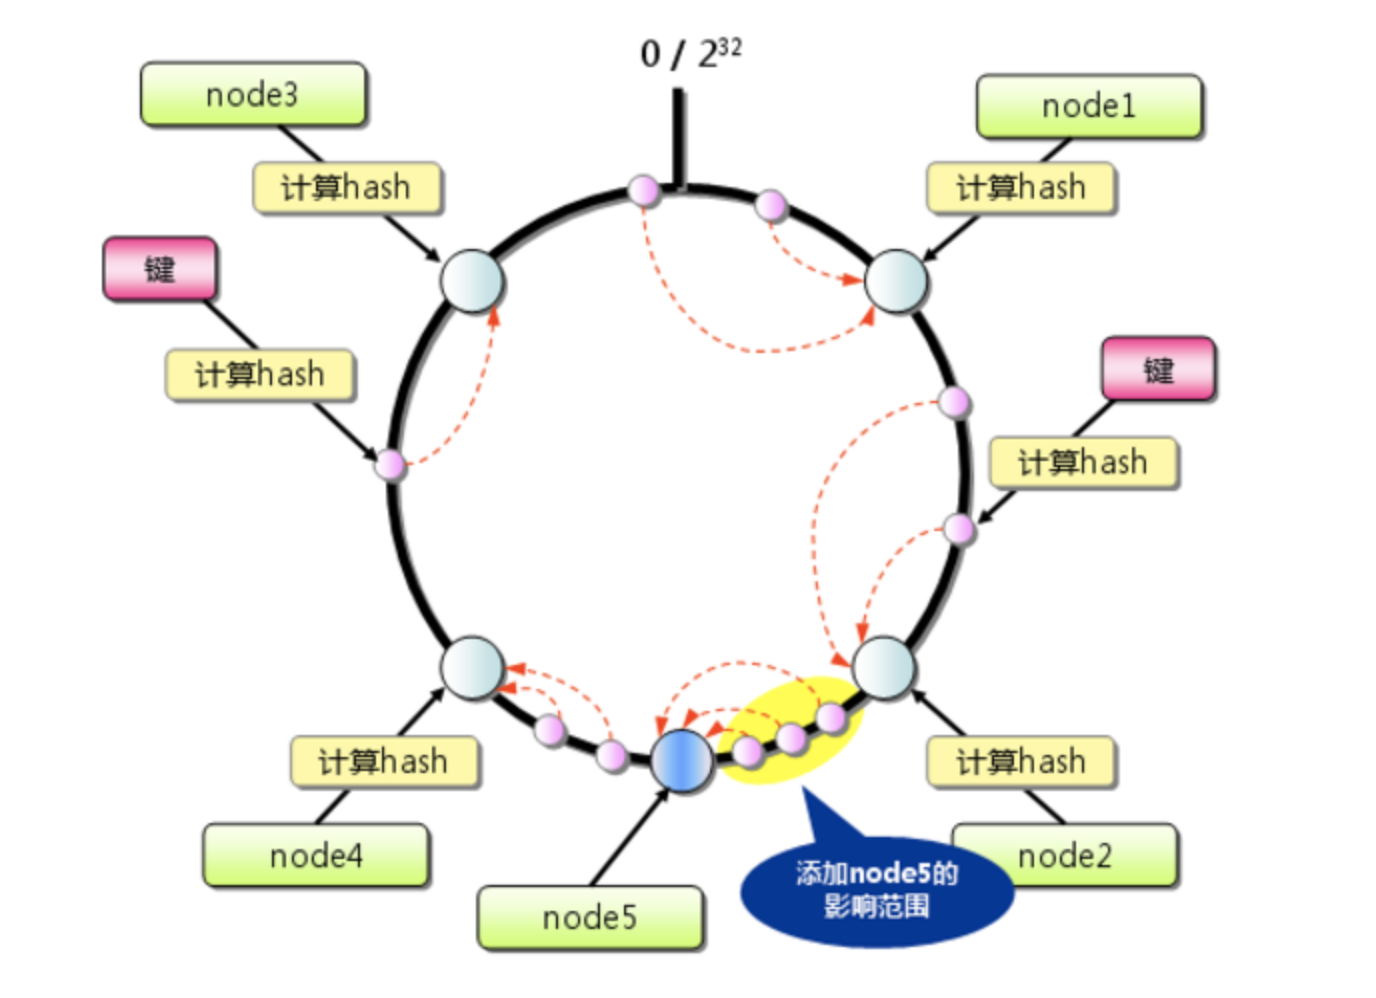
从上图的状态中添加一台 Memcached 服务器。余数分布式算法由于保存键的服务器会发生巨大变化而影响缓存的命中率,但在一致性哈希中,只有在圆(continuum)上增加服务器的地点逆时针方向的第一台服务器上的键会受到影响,如下图所示:
性质
考虑到分布式系统每个节点都有可能失效,并且新的节点很可能动态的增加进来,如何保证当系统的节点数目发生变化时仍然能够对外提供良好的服务,这是值得考虑的,尤其实在设计分布式缓存系统时,如果某台服务器失效,对于整个系统来说,如果不采用合适的算法来保证一致性,那么缓存在系统中的所有数据都可能会失效(即由于系统节点数目变少,客户端在请求某一对象时需要重新计算其hash值,通常与系统中的节点数目有关,由于hash值已经改变,所以很可能找不到保存该对象的服务器节点),因此一致性哈希就显得至关重要,良好的分布式 Cahce 系统中的一致性哈希算法应该满足以下几个方面。
平衡性(Balance)
平衡性是指哈希的结果能够尽可能分布到所有的缓冲中去,这样可以使得所有的缓冲空间都得到利用。很多哈希算法都能够满足这一条件。
单调性(Monotonicity)
单调性是指如果已经有一些内容通过哈希分派到了相应的缓冲中,又有新的缓冲区加入到系统中,那么哈希的结果应能够保证原有已分配的内容可以被映射到新的缓冲区中去,而不会被映射到旧的缓冲集合中的其他缓冲区。简单的哈希算法往往不能满足单调性的要求,如最简单的线性哈希:x = (ax + b) mod (P),在上式中,P表示全部缓冲的大小。不难看出,当缓冲大小发生变化时(从P1到P2),原来所有的哈希结果均会发生变化,从而不满足单调性的要求。哈希结果的变化意味着当缓冲空间发生变化时,所有的映射关系需要在系统内全部更新。而在 P2P 系统内,缓冲的变化等价于 Peer 加入或退出系统,这一情况在 P2P 系统中会频繁发生,因此会带来极大计算和传输负荷。单调性就是要求哈希算法能够应对这种情况。
分散性(Spread)
在分布式环境中,终端有可能看不到所有的缓冲,而是只能看到其中的一部分。当终端希望通过哈希过程将内容映射到缓冲上时,由于不同终端所见的缓冲范围有可能不同,从而导致哈希的结果不一致,最终的结果是相同的内容被不同的终端映射到不同的缓冲区中。这种情况显然是应该避免的,因为它导致相同内容被存储到不同缓冲中去,降低了系统存储的效率。分散性的定义就是上述情况发生的严重程度。好的哈希算法应能够尽量避免不一致的情况发生,也就是尽量降低分散性。
负载(Load)
负载问题实际上是从另一个角度看待分散性问题。既然不同的终端可能将相同的内容映射到不同的缓冲区中,那么对于一个特定的缓冲区而言,也可能被不同的用户映射为不同的内容。与分散性一样,这种情况也是应当避免的,因此好的哈希算法应能够尽量降低缓冲的负荷。
平滑性(Smoothness)
平滑性是指缓存服务器的数目平滑改变和缓存对象的平滑改变是一致的。
原理
一致性哈希算法(Consistent Hashing)最早在论文《Consistent Hashing and Random Trees: Distributed Caching Protocols for Relieving Hot Spots on the World Wide Web》中被提出。简单来说,一致性哈希将整个哈希值空间组织成一个虚拟的圆环,如假设某哈希函数H的值空间为0-2^32-1(即哈希值是一个 32 位无符号整形),整个哈希空间环如下:
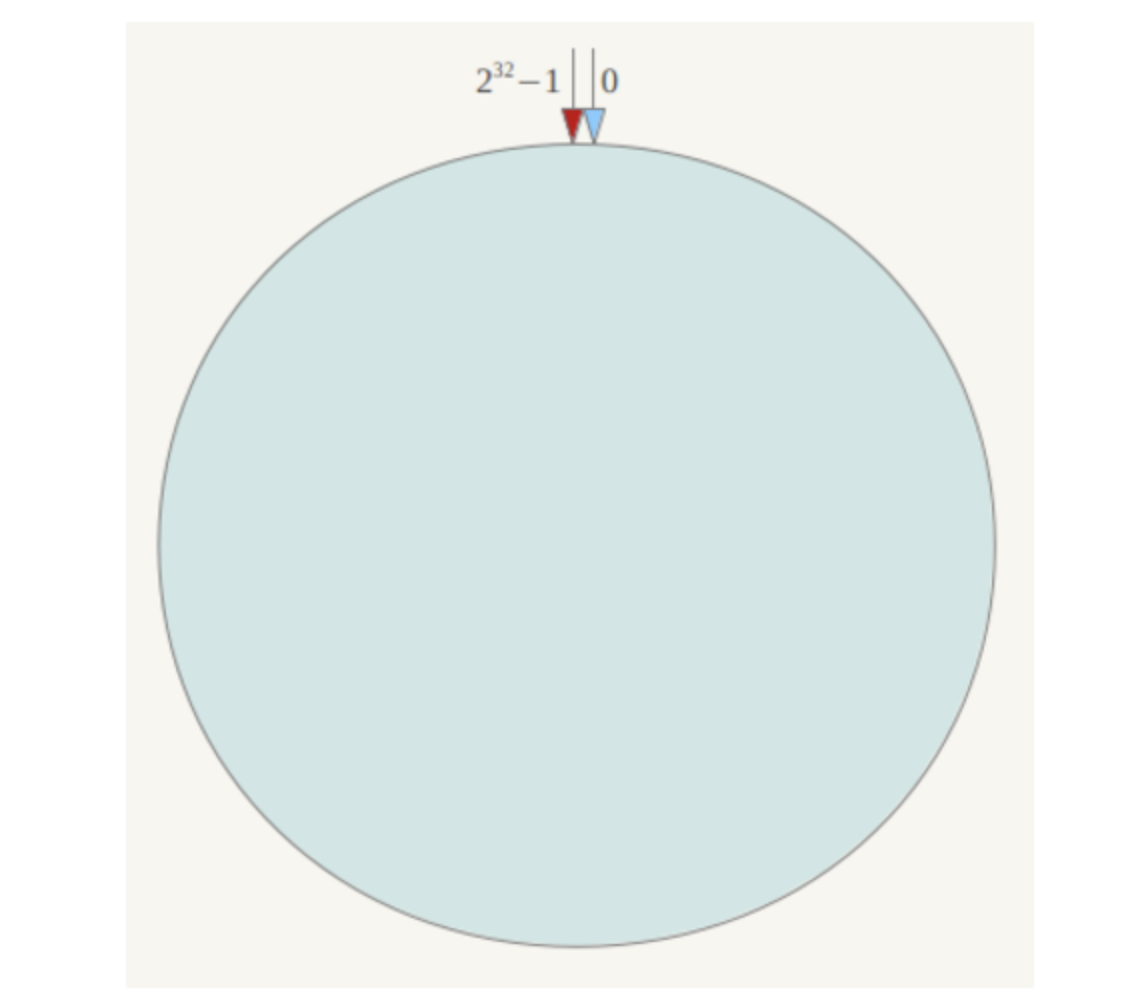
整个空间按顺时针方向组织,0和2^32-1在零点中方向重合。
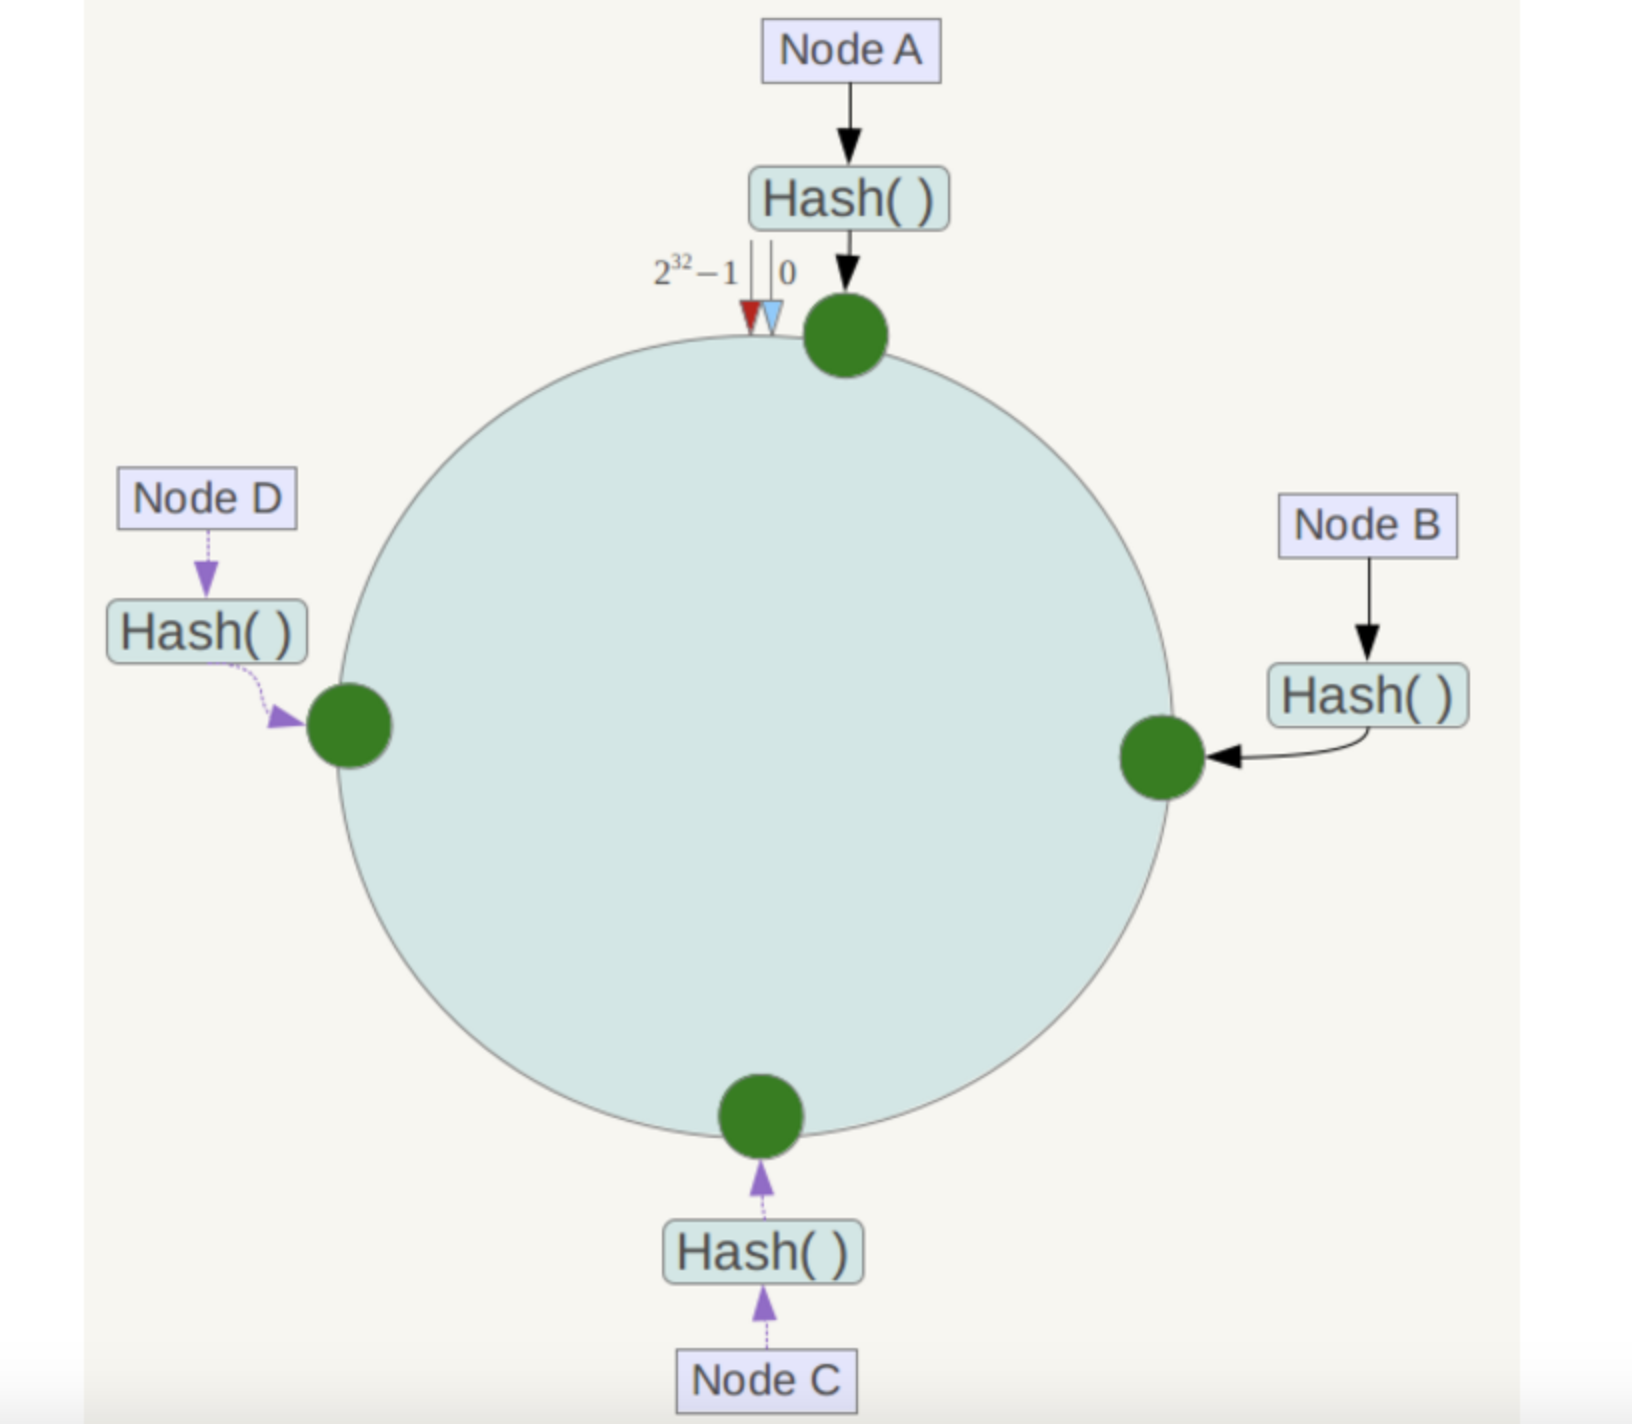
下一步将各个服务器使用H进行一个哈希,具体可以选择服务器的 IP 或主机名作为关键字进行哈希,这样每台机器就能确定其在哈希环上的位置,这里假设将上文中四台服务器使用 IP 地址哈希后在环空间的位置如下:
接下来,使用如下算法定位数据访问到相应服务器:将数据key使用相同的函数H计算出哈希值,并确定此数据在环上的位置,从此位置沿环顺时针“行走”,第一台遇到的服务器就是其应该定位到的服务器。例如我们有Object A、Object B、Object C和Object D四个数据对象,经过哈希计算后,在环空间上的位置如下:
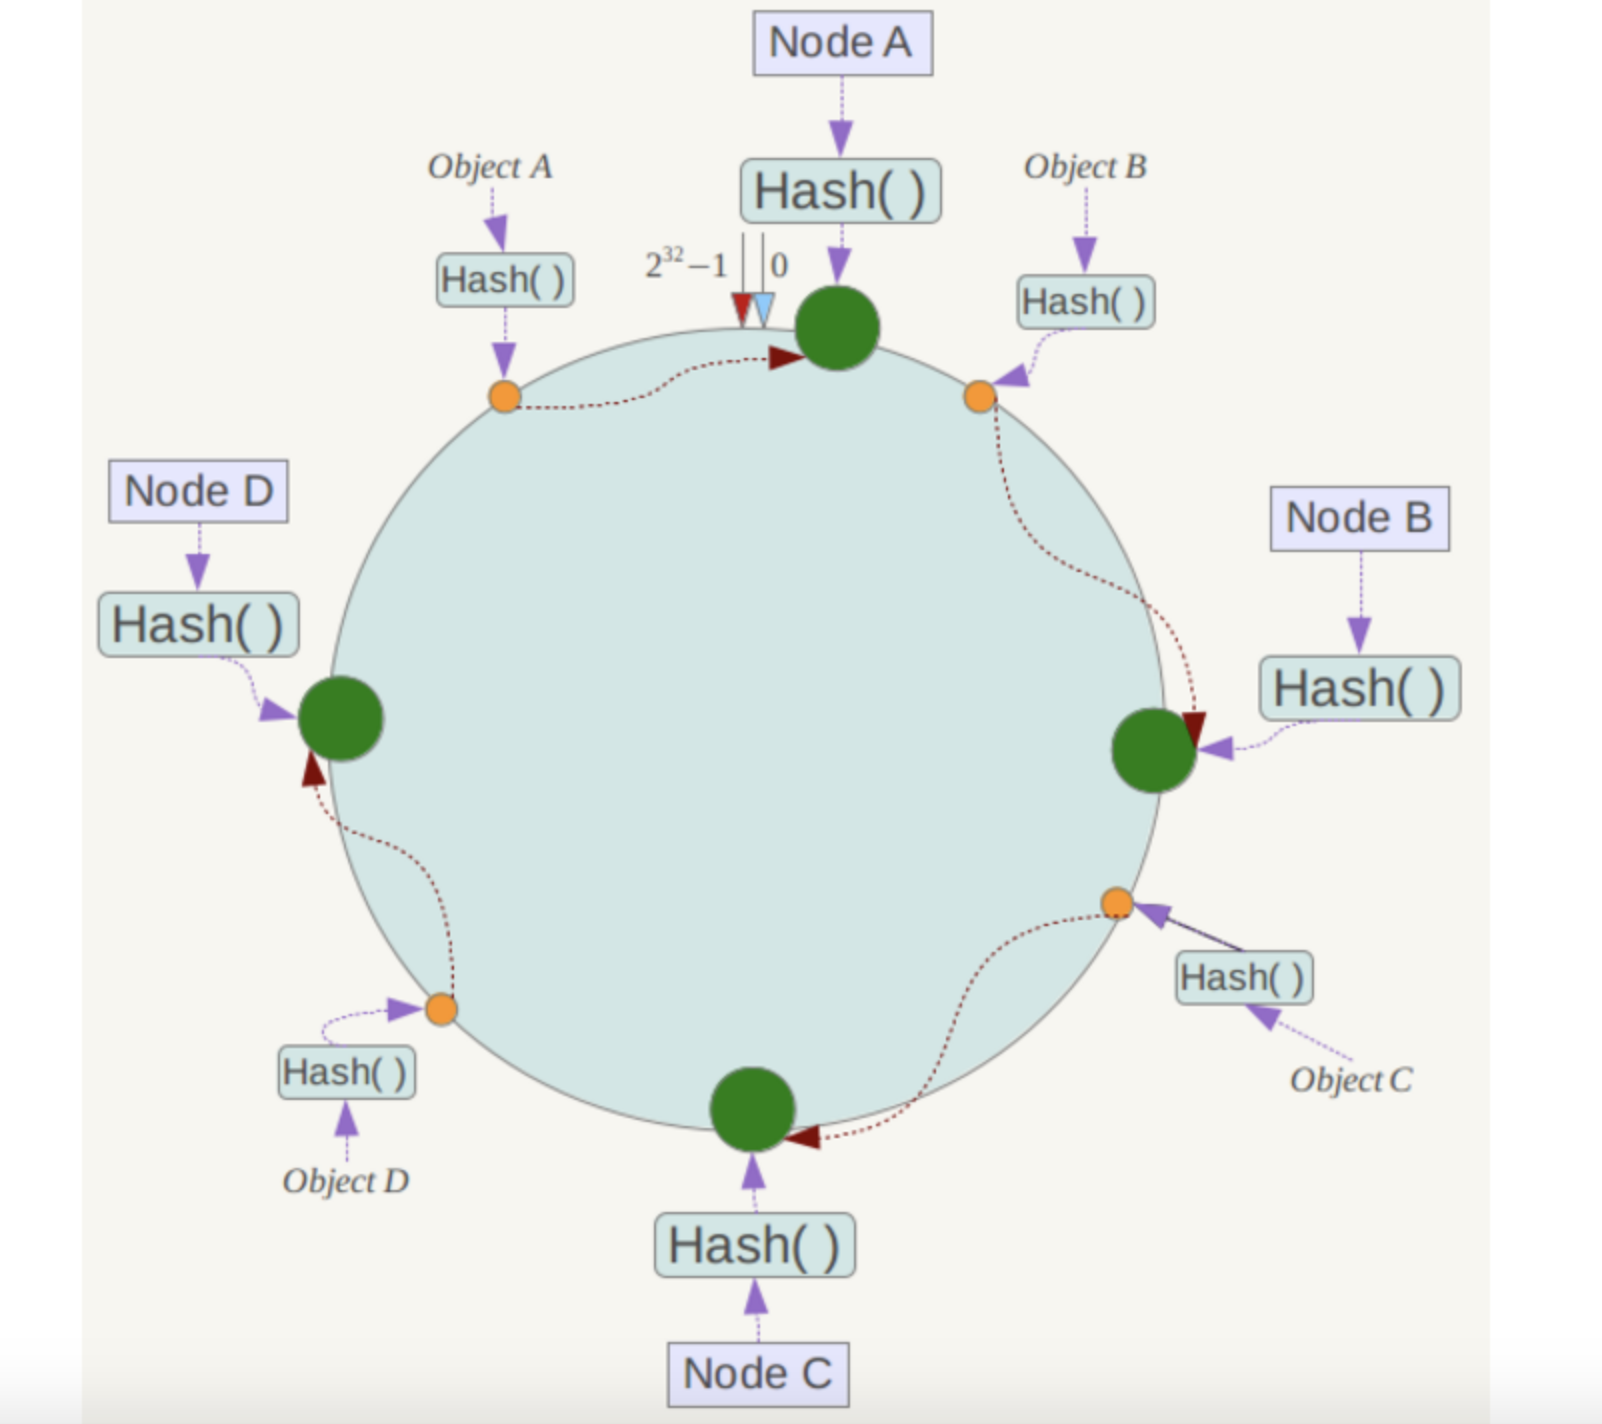
根据一致性哈希算法,数据A会被定为到Node A上,B被定为到Node B上,C被定为到Node C上,D被定为到Node D上。
下面分析一致性哈希算法的容错性和可扩展性。现假设Node C不幸宕机,可以看到此时对象A、B、D不会受到影响,只有C对象被重定位到Node D。一般的,在一致性哈希算法中,如果一台服务器不可用,则受影响的数据仅仅是此服务器到其环空间中前一台服务器(即沿着逆时针方向行走遇到的第一台服务器)之间数据,其它不会受到影响。
下面考虑另外一种情况,如果在系统中增加一台服务器Node X,如下图所示:
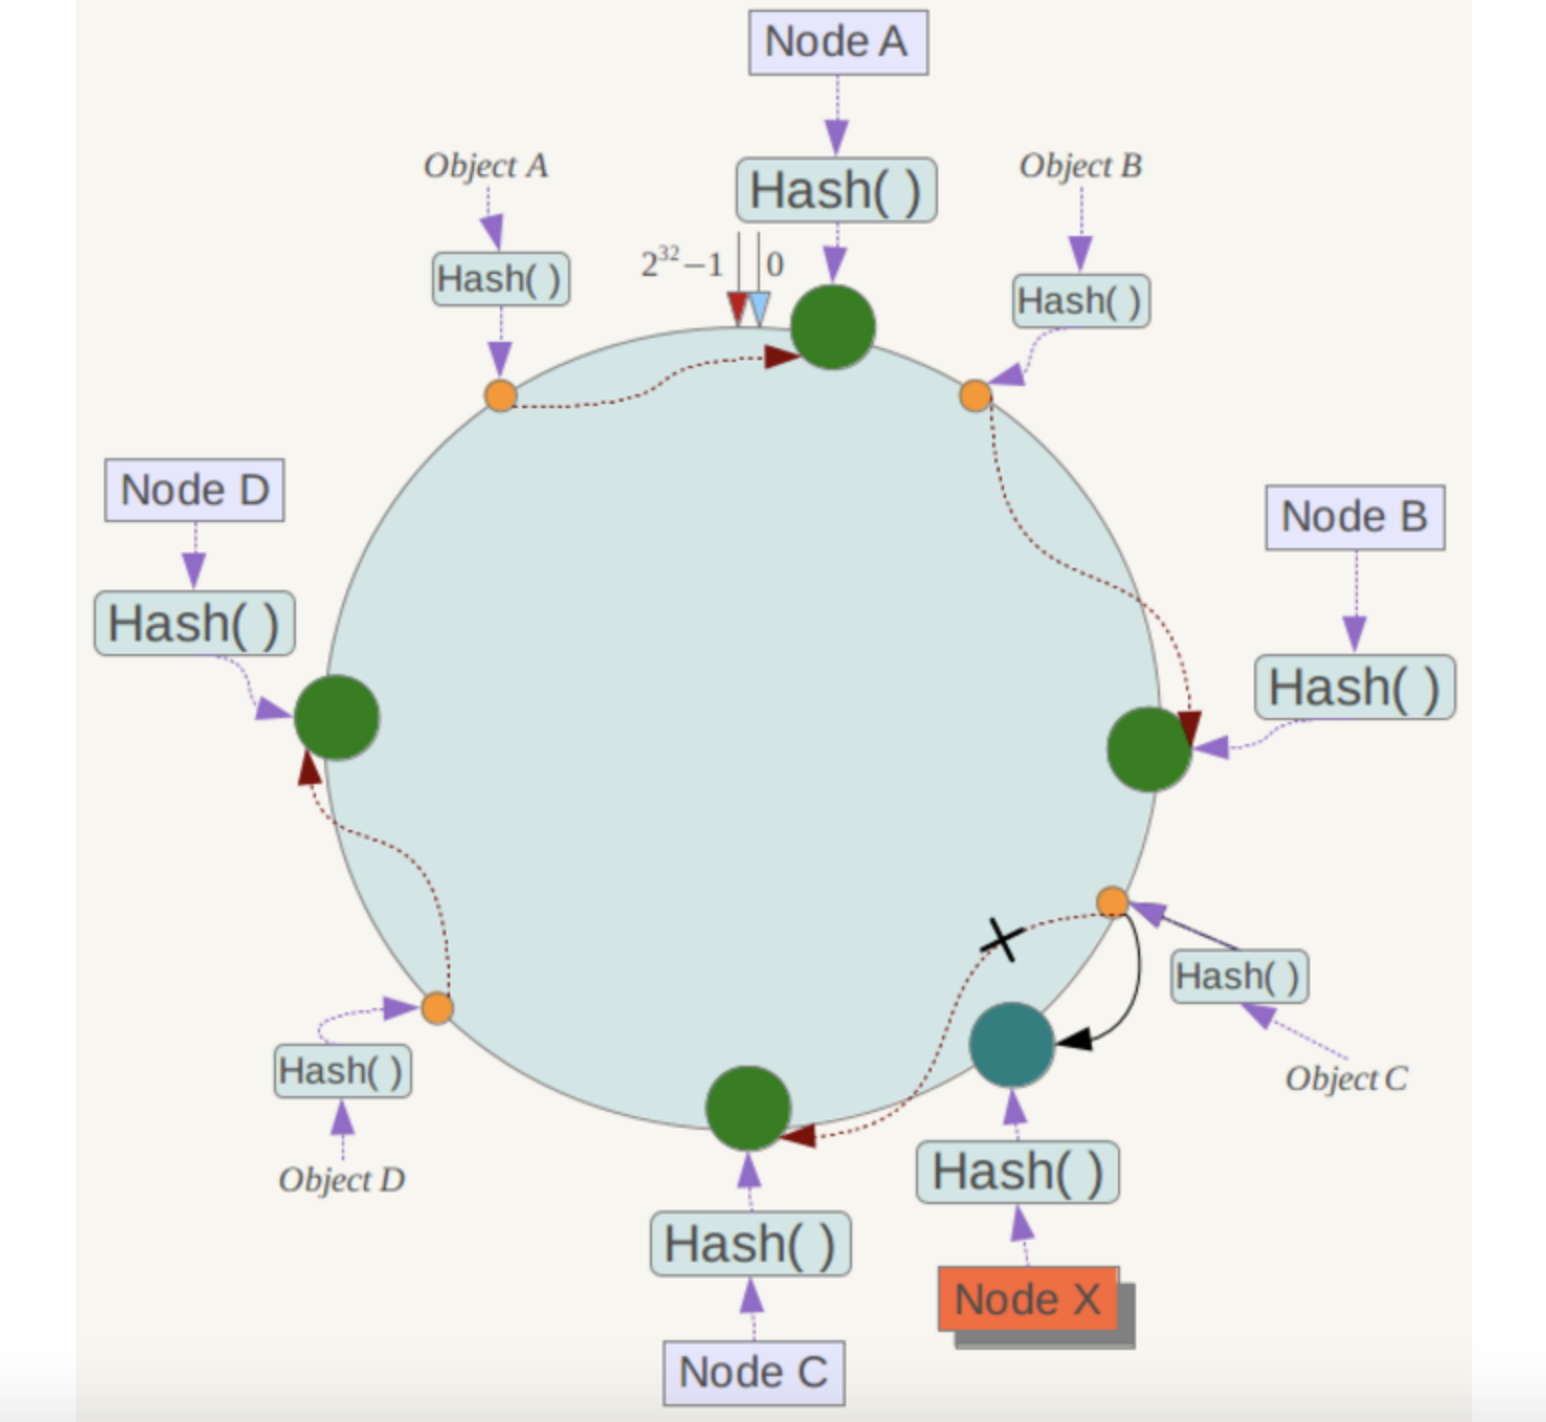
此时对象Object A、B、D不受影响,只有对象C需要重定位到新的Node X 。一般的,在一致性哈希算法中,如果增加一台服务器,则受影响的数据仅仅是新服务器到其环空间中前一台服务器(即沿着逆时针方向行走遇到的第一台服务器)之间数据,其它数据也不会受到影响。
综上所述,一致性哈希算法对于节点的增减都只需重定位环空间中的一小部分数据,具有较好的容错性和可扩展性。
另外,一致性哈希算法在服务节点太少时,容易因为节点分部不均匀而造成数据倾斜问题。例如系统中只有两台服务器,其环分布如下,
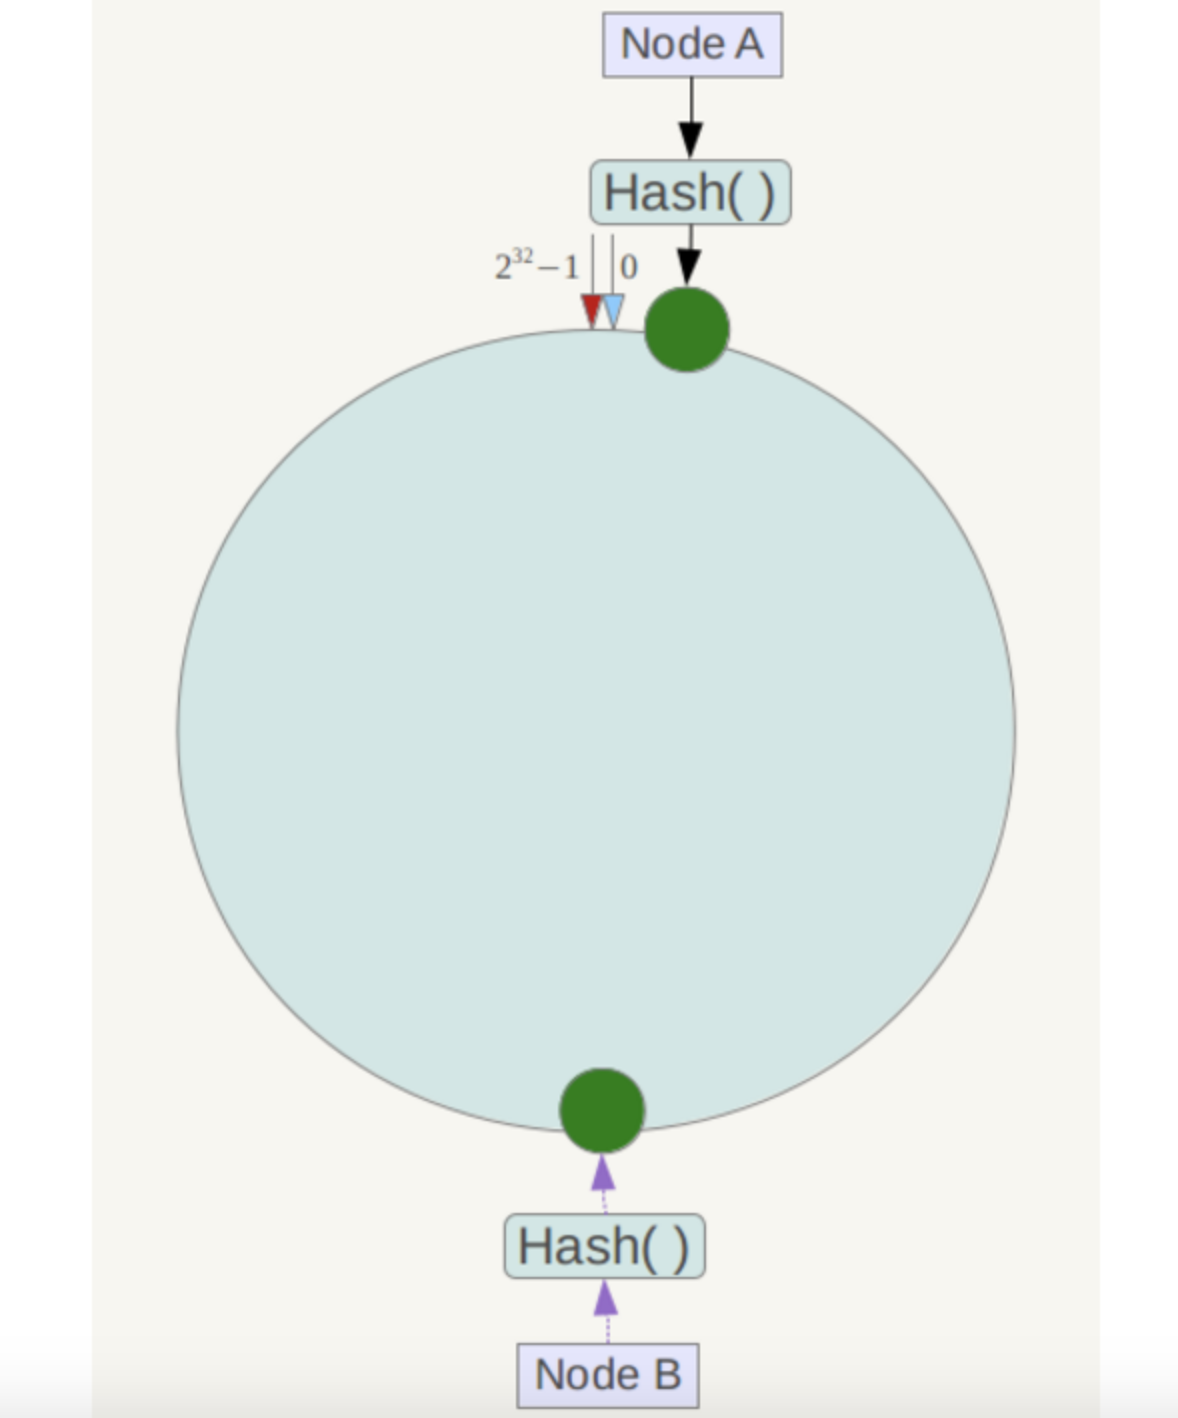
此时必然造成大量数据集中到Node A上,而只有极少量会定位到Node B上。为了解决这种数据倾斜问题,一致性哈希算法引入了虚拟节点机制,即对每一个服务节点计算多个哈希,每个计算结果位置都放置一个此服务节点,称为虚拟节点。具体做法可以在服务器 IP 或主机名的后面增加编号来实现。例如上面的情况,可以为每台服务器计算三个虚拟节点,于是可以分别计算Node A#1、Node A#2、Node A#3、Node B#1、Node B#2、Node B#3的哈希值,于是形成六个虚拟节点:
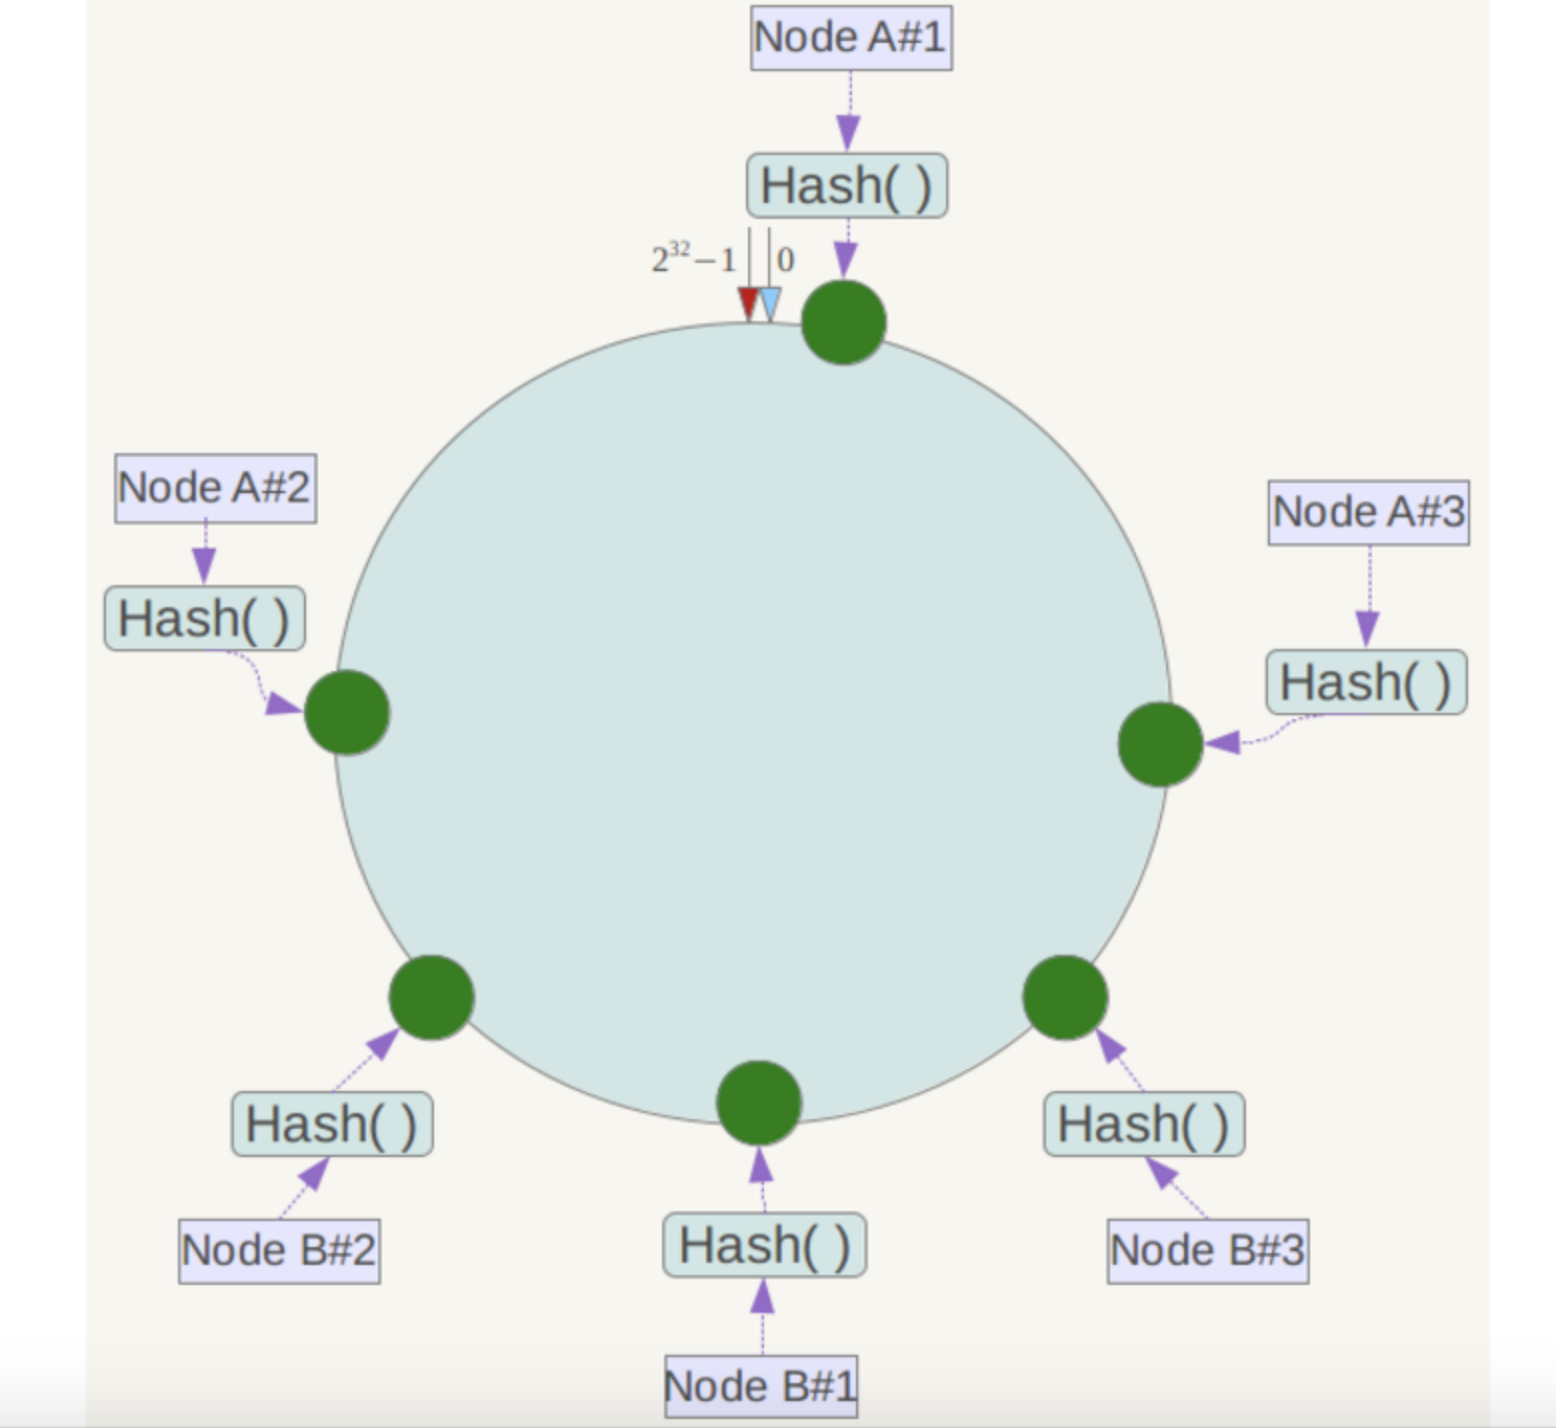
同时数据定位算法不变,只是多了一步虚拟节点到实际节点的映射,例如定位到Node A#1、Node A#2、Node A#3三个虚拟节点的数据均定位到Node A上,这样就解决了服务节点少时数据倾斜的问题。
在实际应用中,通常将虚拟节点数设置为 32 甚至更大,因此即使很少的服务节点也能做到相对均匀的数据分布。
名称解析:
- CARP,
Common Access Redundancy Protocol,即共用地址冗余协议,能够使多台主机共享同一个 IP 地址。在某些配置中,这样做可以提高可用性,或实现负载均衡。这些主机也可以同时使用其他的不同的 IP 地址。 - DHT,
Distributed Hash Table,即分布式哈希表,是一种分布式存储方法。在不需要服务器的情况下,每个客户端负责一个小范围的路由,并负责存储一小部分数据,从而实现整个 DHT 网络的寻址和存储。 - P2P,
Peer to Peer,即对等计算机网络,是一种在对等者(Peer)之间分配任务和工作负载的分布式应用架构,是对等计算模型在应用层形成的一种组网或网络形式。
发布者:全栈程序员-站长,转载请注明出处:https://javaforall.net/164577.html原文链接:https://javaforall.net



