
Jetbrains全系列IDE使用 1年只要46元 售后保障 童叟无欺

这篇论文是Hinton在15年提出的,为了提升模型的有效性,模型的复杂度的不断增加,上线实时提供服务成了难题,而知识蒸馏的思路正好可以解决这个问题,同时模型的效果相比复杂模型也不会下降太多。
论文中以生物中蝴蝶变态发育作类比介绍知识蒸馏:通过不同的形态,完成同样的使命(任务)。
Hinton提出可以通过一个简单模型直接学习复杂模型的概率分布结果,如果one-hot的目标是一种hard-targets,那么这种就是一种soft-targets。
一种方法是直接比较logits来避免这个问题。具体地,对于每一条数据,记原模型产生的某个logits是 v i v_i vi ,新模型产生的logits是 z i z_i zi ,我们需要最小化
1 2 ( z i − v i ) 2 (1) \frac{1}{2}(z_i-v_i)^2 \tag{1} 21(zi−vi)2(1)
Hinton提出了升温蒸馏的概念,温度就是其中的关键点,升温蒸馏,降温预测,完美。
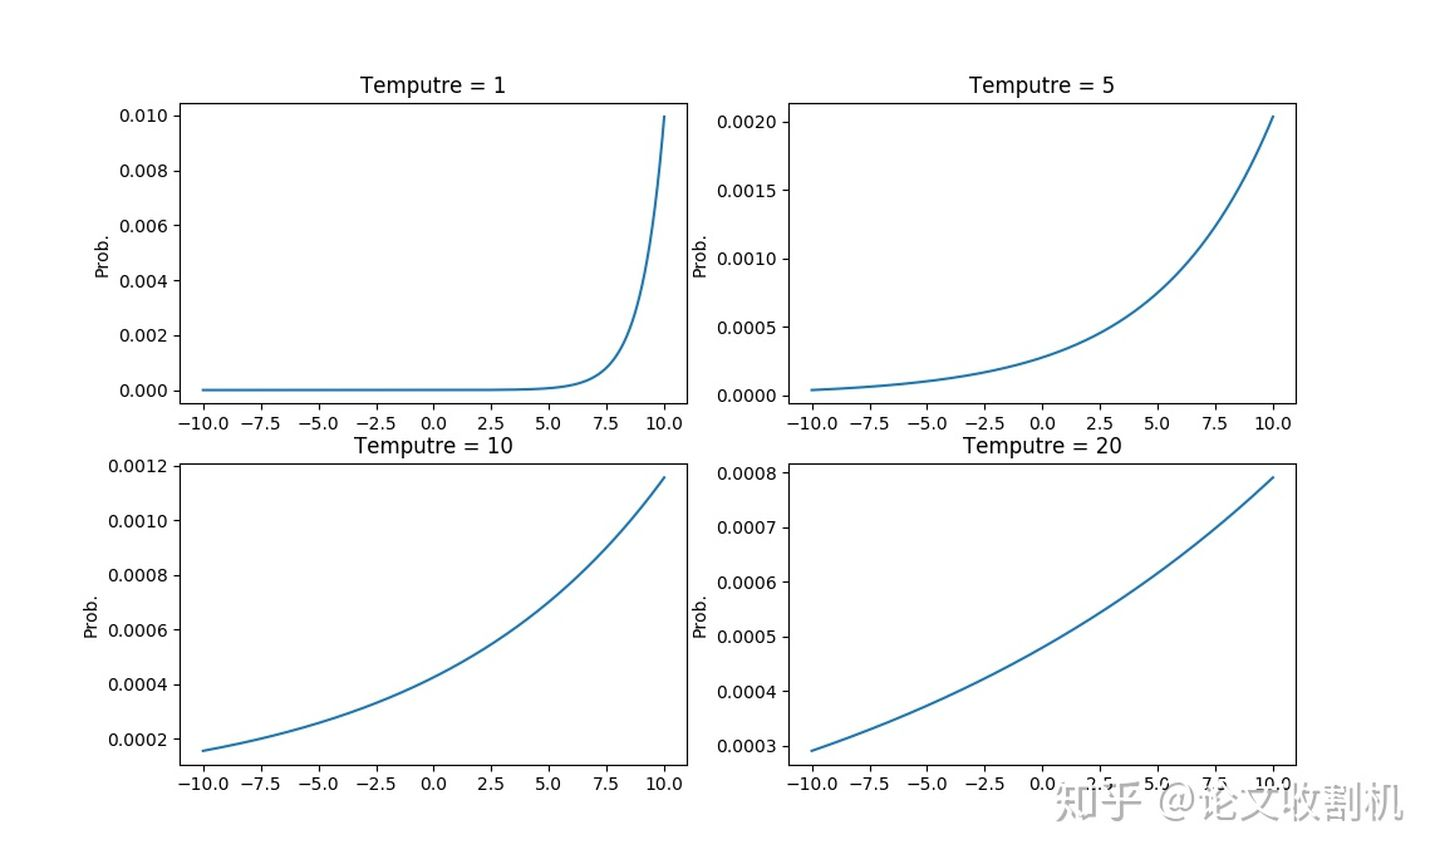
其中温度T就是用来做平滑的,T越大,平滑力度越大,使得轻量模型学习时可以关注到那些概率很小的类别;T越小,则相反,T=1时,就是平常所见的概率分布。
考虑一个广义的softmax函数:
q i = e x p ( z i / T ) ∑ j e x p ( z j / T ) (2) q_i=\frac{exp(z_i/T)}{\sum_j{exp(z_j/T)}} \tag{2} qi=∑jexp(zj/T)exp(zi/T)(2)
可以证明,上面的logit值作为训练目标是这种方法的一种特例,总是可以通过调整T来达到。其中 T T T 是温度,这是从统计力学中的玻尔兹曼分布中借用的概念。容易证明,当温度 T T T 趋向于0时,softmax输出将收敛为一个one-hot向量;温度 T T T 趋向于无穷时,softmax的输出则更「软」。因此,在训练新模型的时候,可以使用较高的 T T T 使得softmax产生的分布足够软,这时让新模型(同样温度下)的softmax输出近似原模型;在训练结束以后再使用正常的温度 T = 1 T=1 T=1 来预测。具体地,在训练时我们需要最小化两个分布的交叉熵(Cross-entropy),记新模型利用公式 (2) 产生的分布是 q q q ,原模型产生的分布是 p p p ,则我们需要最小化
C = − p T log q (3) C=-p^T\log q \tag{3} C=−pTlogq(3)
下面计算交叉熵损失对softmax输入的梯度,由链式法则,有:
∂ C ∂ z = ∂ C ∂ q ∂ q ∂ z (4) \frac{\partial C}{\partial z}=\frac{\partial C}{\partial q} \frac{\partial q}{\partial z} \tag{4} ∂z∂C=∂q∂C∂z∂q(4)
由于式(3)中的 p p p 是原模型产生的softmax输出,与 z z z 无关。
结合式(3)可得:
∂ C ∂ q i = − p i q i (5) \frac{\partial C}{\partial q_i} = -\frac{p_i}{q_i} \tag{5} ∂qi∂C=−qipi(5)
所以,
∂ C ∂ q = [ − p 1 q 1 − p 2 q 2 ⋮ − p n q n ] (6) \frac{\partial C}{\partial q} = \left[ \begin{matrix} -\frac{p_1}{q_1} \\ -\frac{p_2}{q_2} \\ \vdots \\ -\frac{p_n}{q_n} \end{matrix}\right] \tag{6} ∂q∂C=⎣⎢⎢⎢⎡−q1p1−q2p2⋮−qnpn⎦⎥⎥⎥⎤(6)
式(4)中, ∂ q ∂ z \frac{\partial q}{\partial z} ∂z∂q 是一个 n × n n \times n n×n 的方阵,分类讨论可以得到。
记 Z = ∑ k e x p ( z k / T ) Z=\sum_{k}exp(z_k/T) Z=∑kexp(zk/T),由除法的求到公式,输出 q i q_i qi 对输入 z j z_j zj 的偏导为:
∂ q i ∂ z j = 1 Z 2 ( Z ∂ e x p ( z i / T ) ∂ z j − e x p ( z i / T ) ∂ Z ∂ z j ) = 1 Z 2 ( Z ∂ e x p ( z i / T ) ∂ z j − e x p ( z i / T ) ⋅ 1 T e x p ( z j / T ) ) = 1 Z ∂ e x p ( z i / T ) ∂ z j − 1 T Z 2 e x p ( z i / T ) e x p ( z j / T ) = 1 Z ∂ e x p ( z i / T ) ∂ z j − 1 T e x p ( z i / T ) Z e x p ( z j / T ) Z = 1 Z ∂ e x p ( z i / T ) ∂ z j − 1 T q i q j (7) \begin{aligned} \frac{\partial q_i}{\partial z_j} &= \frac{1}{Z^2}(Z \frac{\partial {exp(z_i/T)}}{\partial z_j} – exp(z_i/T) \frac{\partial Z}{\partial z_j}) \\ &= \frac{1}{Z^2}(Z \frac{\partial {exp(z_i/T)}}{\partial z_j} – exp(z_i/T) \cdot \frac{1}{T}exp(z_j/T)) \\ &= \frac{1}{Z} \frac{\partial exp(z_i/T)}{\partial z_j}-\frac{1}{TZ^2}exp(z_i/T)exp(z_j/T) \\ &= \frac{1}{Z}\frac{\partial exp(z_i/T)}{\partial z_j} – \frac{1}{T}\frac{exp(z_i/T)}{Z} \frac{exp(z_j/T)}{Z} \\ &= \frac{1}{Z}\frac{\partial exp(z_i/T)}{\partial z_j} – \frac{1}{T}q_iq_j \end{aligned} \tag{7} ∂zj∂qi=Z21(Z∂zj∂exp(zi/T)−exp(zi/T)∂zj∂Z)=Z21(Z∂zj∂exp(zi/T)−exp(zi/T)⋅T1exp(zj/T))=Z1∂zj∂exp(zi/T)−TZ21exp(zi/T)exp(zj/T)=Z1∂zj∂exp(zi/T)−T1Zexp(zi/T)Zexp(zj/T)=Z1∂zj∂exp(zi/T)−T1qiqj(7)
对 ∂ e x p ( z i / T ) ∂ z j \frac{\partial exp(z_i/T)}{\partial z_j} ∂zj∂exp(zi/T) 分类讨论得到:
∂ e x p ( z i / T ) ∂ z j = { 1 T e x p ( z i / T ) i = j 0 i ≠ j (8) \frac{\partial exp(z_i/T)}{\partial z_j} = \left\{ \begin{array}{rcl} \frac{1}{T}exp(z_i/T) & & {i = j} \\ 0 & & {i \neq j} \end{array} \right. \tag{8} ∂zj∂exp(zi/T)={
T1exp(zi/T)0i=ji=j(8)
将式(8)带入式(7),得到:
∂ q i ∂ z j = { 1 T ( e x p ( z i / T ) Z − q i q j ) i = j − 1 T q i q j i ≠ j = { 1 T ( q i − q i q j ) i = j − 1 T q i q j i ≠ j (9) \begin{aligned} \frac{\partial q_i}{\partial z_j} &= \left\{ \begin{array}{rcl} \frac{1}{T}(\frac{exp(z_i/T)}{Z}-q_iq_j) & & {i = j} \\ -\frac{1}{T}q_iq_j & & {i \neq j} \end{array} \right. \\ &= \left\{ \begin{array}{rcl} \frac{1}{T}(q_i-q_iq_j) & & {i = j} \\ -\frac{1}{T}q_iq_j & & {i \neq j} \end{array} \right. \end{aligned} \tag{9} ∂zj∂qi={
T1(Zexp(zi/T)−qiqj)−T1qiqji=ji=j={
T1(qi−qiqj)−T1qiqji=ji=j(9)
所以, ∂ q ∂ z \frac{\partial q}{\partial z} ∂z∂q 的形式如下:
∂ q ∂ z = 1 T [ q 1 − q 1 2 − q 1 q 2 ⋯ − q 1 q n − q 2 q 1 q 2 − q 2 2 ⋯ − q 2 q n ⋮ ⋮ ⋱ ⋮ − q n q 1 − q n q 2 ⋯ q n − q n 2 ] (10) \frac{\partial q}{\partial z}=\frac{1}{T} \left[ \begin{matrix} q_1-q_1^2 & -q_1q_2 & \cdots & -q_1q_n \\ -q_2q_1 & q_2-q_2^2 & \cdots & -q_2q_n \\ \vdots & \vdots & \ddots & \vdots \\ -q_nq_1 & -q_nq_2 & \cdots & q_n-q_n^2 \end{matrix} \right] \tag{10} ∂z∂q=T1⎣⎢⎢⎢⎡q1−q12−q2q1⋮−qnq1−q1q2q2−q22⋮−qnq2⋯⋯⋱⋯−q1qn−q2qn⋮qn−qn2⎦⎥⎥⎥⎤(10)
将式(10)带入到式(4)中,得到:
∂ C ∂ z = 1 T [ q 1 − q 1 2 − q 1 q 2 ⋯ − q 1 q n − q 2 q 1 q 2 − q 2 2 ⋯ − q 2 q n ⋮ ⋮ ⋱ ⋮ − q n q 1 − q n q 2 ⋯ q n − q n 2 ] [ − p 1 q 1 − p 2 q 2 ⋮ − p n q n ] = 1 T [ − p 1 + ∑ k p k q 1 − p 2 + ∑ k p k q 2 ⋮ − p n + ∑ k p k q n ] = 1 T [ − p 1 + q 1 − p 2 + q 2 ⋮ − p n + q n ] = 1 T ( q − p ) (11) \begin{aligned} \frac{\partial C}{\partial z} &=\frac{1}{T} \left[ \begin{matrix} q_1-q_1^2 & -q_1q_2 & \cdots & -q_1q_n \\ -q_2q_1 & q_2-q_2^2 & \cdots & -q_2q_n \\ \vdots & \vdots & \ddots & \vdots \\ -q_nq_1 & -q_nq_2 & \cdots & q_n-q_n^2 \end{matrix} \right] \left[ \begin{matrix} -\frac{p_1}{q_1} \\ -\frac{p_2}{q_2} \\ \vdots \\ -\frac{p_n}{q_n} \end{matrix}\right] \\ &= \frac{1}{T} \left[\begin{matrix} -p_1+\sum_kp_kq_1 \\ -p_2+\sum_kp_kq_2 \\ \vdots \\ -p_n+\sum_kp_kq_n \end{matrix}\right] \\ &= \frac{1}{T} \left[\begin{matrix} -p_1+q_1 \\ -p_2+q_2 \\ \vdots \\ -p_n+q_n \end{matrix}\right] \\ &=\frac{1}{T}(q-p) \end{aligned} \tag{11} ∂z∂C=T1⎣⎢⎢⎢⎡q1−q12−q2q1⋮−qnq1−q1q2q2−q22⋮−qnq2⋯⋯⋱⋯−q1qn−q2qn⋮qn−qn2⎦⎥⎥⎥⎤⎣⎢⎢⎢⎡−q1p1−q2p2⋮−qnpn⎦⎥⎥⎥⎤=T1⎣⎢⎢⎢⎡−p1+∑kpkq1−p2+∑kpkq2⋮−pn+∑kpkqn⎦⎥⎥⎥⎤=T1⎣⎢⎢⎢⎡−p1+q1−p2+q2⋮−pn+qn⎦⎥⎥⎥⎤=T1(q−p)(11)
所以,有:
∂ C ∂ z i = 1 T ( q i − p i ) (12) \frac{\partial C}{\partial z_i} =\frac{1}{T}(q_i-p_i) \tag{12} ∂zi∂C=T1(qi−pi)(12)
结合(2)式,得到:
∂ C ∂ z i = 1 T ( q i − p i ) = 1 T ( e x p ( z i / T ) ∑ j e x p ( z j / T ) − e x p ( v i / T ) ∑ j e x p ( v j / T ) ) (13) \begin{aligned} \frac{\partial C}{\partial z_i} &=\frac{1}{T}(q_i-p_i) \\ &=\frac{1}{T}(\frac{exp(z_i/T)}{\sum_j exp(z_j/T)}-\frac{exp(v_i/T)}{\sum_j exp(v_j/T)}) \end{aligned} \tag{13} ∂zi∂C=T1(qi−pi)=T1(∑jexp(zj/T)exp(zi/T)−∑jexp(vj/T)exp(vi/T))(13)
使用等价无穷小 e x − 1 ∼ x e^x-1 \sim x ex−1∼x 作替换:
∂ C ∂ z i ≈ 1 T ( 1 + z i / T ∑ j ( 1 + z j / T ) − 1 + v i / T ∑ j ( 1 + v j / T ) ) = ( 1 + z i / T N + ∑ j z j / T − 1 + v i / T N + ∑ j v j / T ) (14) \begin{aligned} \frac{\partial C}{\partial z_i} &\approx \frac{1}{T}(\frac{1+z_i/T}{\sum_j(1+z_j/T)}-\frac{1+v_i/T}{\sum_j(1+v_j/T)}) \\ &= (\frac{1+z_i/T}{N+\sum_j{z_j/T}}- \frac{1+v_i/T}{N+\sum_j{v_j/T}}) \end{aligned} \tag{14} ∂zi∂C≈T1(∑j(1+zj/T)1+zi/T−∑j(1+vj/T)1+vi/T)=(N+∑jzj/T1+zi/T−N+∑jvj/T1+vi/T)(14)
假设所有logits对每个样本都是零均值化的,
∑ j z j = ∑ j v j = 0 (15) \sum_{j}z_j=\sum_{j}v_j=0 \tag{15} j∑zj=j∑vj=0(15)
则有,
∂ C ∂ z i ≈ 1 T ( 1 + z i / T N − 1 + v i / T N ) = 1 N T 2 ( z i − v i ) (16) \begin{aligned} \frac{\partial C}{\partial z_i} &\approx \frac{1}{T}(\frac{1+z_i/T}{N}- \frac{1+v_i/T}{N}) \\ &= \frac{1}{NT^2}(z_i-v_i) \end{aligned} \tag{16} ∂zi∂C≈T1(N1+zi/T−N1+vi/T)=NT21(zi−vi)(16)
所以,如果:1. T T T 非常大,2. logits对所有样本都是零均值化的,则知识蒸馏和最小化logits的平方差(公式(1))是等价的(因为梯度大致是同一个形式)。实验表明,温度 T T T 不能取太大,而应该使用某个适中的值,这表明忽略极负的logits对新模型的表现很有帮助(较低的温度产生的分布比较「硬」,倾向于忽略logits中极小的负值)。
同一个样本,用在大规模神经网络上产生的软目标来训练一个小的网络时,因为并不是直接标注的一个硬目标,学习起来会更快收敛。
更巧妙的是,这个样本我们甚至可以使用无标注的数据来训练小网络,因为大的神经网络将数据结构信息学习保存起来,小网络就可以直接从得到的soft target中来获得知识。
这个做法类似学习了样本空间嵌入(embedding)信息,从而利用空间嵌入信息学习新的网络。
随着温度上升,软目标分布更均匀
T参数是一个温度超参数,按照softmax的分布来看,随着T参数的增大,这个软目标的分布更加均匀。
所以:
1.首先用较大的T值来训练模型,这时候复杂的神经网络能够产生更均匀分布的软目标;
2.之后小规模的神经网络用相同的T值来学习由大规模神经产生的软目标,接近这个软目标从而学习到数据的结构分布特征;
3.最后在实际应用中,将T值恢复到1,让类别概率偏向正确类别
Reference:
https://arxiv.org/pdf/1503.02531.pdf
https://zhuanlan.zhihu.com/p/71986772
https://zhuanlan.zhihu.com/p/97522736
https://zhuanlan.zhihu.com/p/39945855
https://zhuanlan.zhihu.com/p/93287223
https://zhuanlan.zhihu.com/p/90049906
发布者:全栈程序员-站长,转载请注明出处:https://javaforall.net/169743.html原文链接:https://javaforall.net


