
kakfa是我们在项目开发中经常使用的消息中间件。由于它的写性能非常高,因此,经常会碰到读取Kafka消息队列时拥堵的情况。遇到这种情况时,有时我们不能直接清理整个topic,因为还有别的服务正在使用该topic。因此只能额外启动一个相同名称的consumer-group来加快消息消费(如果该topic只有一个分区,再启动一个新的消费者,没有作用)。
完整的代码在这里,欢迎加星号、fork。
官方文档在https://docs.spring.io/spring-kafka/reference/html/_reference.html
###第一步,并发消费###
先看代码,重点是这我们使用的是ConcurrentKafkaListenerContainerFactory并且设置了factory.setConcurrency(4); (我的topic有4个分区,为了加快消费将并发设置为4,也就是有4个KafkaMessageListenerContainer)
    @Bean
    KafkaListenerContainerFactory<ConcurrentMessageListenerContainer<String, String>> kafkaListenerContainerFactory() {
        ConcurrentKafkaListenerContainerFactory<String, String> factory = new ConcurrentKafkaListenerContainerFactory<>();
        factory.setConsumerFactory(consumerFactory());
        factory.setConcurrency(4);
        factory.setBatchListener(true);
        factory.getContainerProperties().setPollTimeout(3000);
        return factory;
    }
注意也可以直接在application.properties中添加spring.kafka.listener.concurrency=3,然后使用@KafkaListener并发消费。
###第二步,批量消费###
然后是批量消费。重点是factory.setBatchListener(true);
以及 propsMap.put(ConsumerConfig.MAX_POLL_RECORDS_CONFIG, 50);
一个设启用批量消费,一个设置批量消费每次最多消费多少条消息记录。
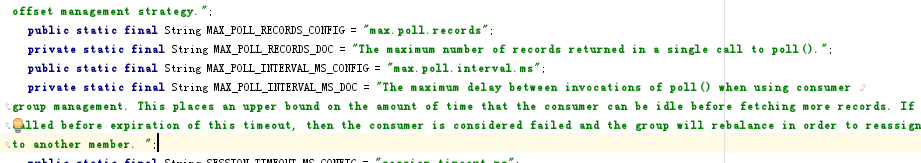
重点说明一下,我们设置的ConsumerConfig.MAX_POLL_RECORDS_CONFIG是50,并不是说如果没有达到50条消息,我们就一直等待。官方的解释是”The maximum number of records returned in a single call to poll().”, 也就是50表示的是一次poll最多返回的记录数。
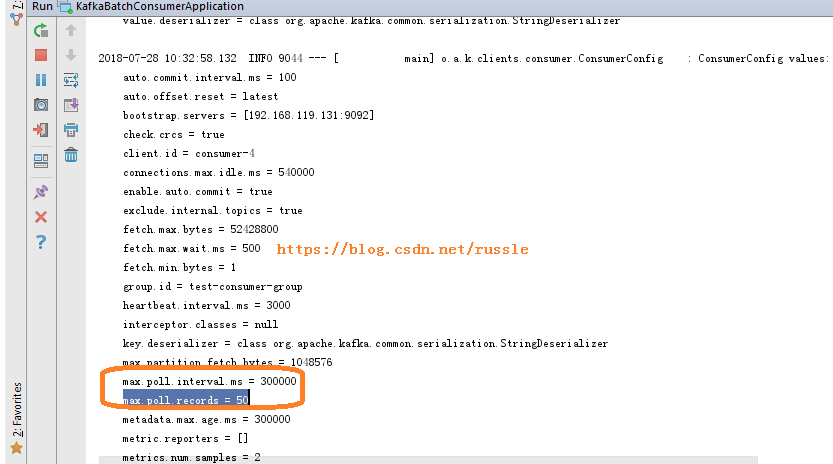
从启动日志中可以看到还有个 max.poll.interval.ms = 300000, 也就说每间隔max.poll.interval.ms我们就调用一次poll。每次poll最多返回50条记录。
max.poll.interval.ms官方解释是”The maximum delay between invocations of poll() when using consumer group management. This places an upper bound on the amount of time that the consumer can be idle before fetching more records. If poll() is not called before expiration of this timeout, then the consumer is considered failed and the group will rebalance in order to reassign the partitions to another member. “;
    @Bean
    KafkaListenerContainerFactory<ConcurrentMessageListenerContainer<String, String>> kafkaListenerContainerFactory() {
        ConcurrentKafkaListenerContainerFactory<String, String> factory = new ConcurrentKafkaListenerContainerFactory<>();
        factory.setConsumerFactory(consumerFactory());
        factory.setConcurrency(4);
        factory.setBatchListener(true);
        factory.getContainerProperties().setPollTimeout(3000);
        return factory;
    }

   @Bean
    public Map<String, Object> consumerConfigs() {
        Map<String, Object> propsMap = new HashMap<>();
        propsMap.put(ConsumerConfig.BOOTSTRAP_SERVERS_CONFIG, propsConfig.getBroker());
        propsMap.put(ConsumerConfig.ENABLE_AUTO_COMMIT_CONFIG, propsConfig.getEnableAutoCommit());
        propsMap.put(ConsumerConfig.AUTO_COMMIT_INTERVAL_MS_CONFIG, "100");
        propsMap.put(ConsumerConfig.SESSION_TIMEOUT_MS_CONFIG, "15000");
        propsMap.put(ConsumerConfig.KEY_DESERIALIZER_CLASS_CONFIG, StringDeserializer.class);
        propsMap.put(ConsumerConfig.VALUE_DESERIALIZER_CLASS_CONFIG, StringDeserializer.class);
        propsMap.put(ConsumerConfig.GROUP_ID_CONFIG, propsConfig.getGroupId());
        propsMap.put(ConsumerConfig.AUTO_OFFSET_RESET_CONFIG, propsConfig.getAutoOffsetReset());
        propsMap.put(ConsumerConfig.MAX_POLL_RECORDS_CONFIG, 50);
        return propsMap;
    }
启动日志截图

关于max.poll.records和max.poll.interval.ms官方解释截图:
###第三步,分区消费###
对于只有一个分区的topic,不需要分区消费,因为没有意义。下面的例子是针对有2个分区的情况(我的完整代码中有4个listenPartitionX方法,我的topic设置了4个分区),读者可以根据自己的情况进行调整。
public class MyListener {
    private static final String TPOIC = "topic02";

    @KafkaListener(id = "id0", topicPartitions = { @TopicPartition(topic = TPOIC, partitions = { "0" }) })
    public void listenPartition0(List<ConsumerRecord<?, ?>> records) {
        log.info("Id0 Listener, Thread ID: " + Thread.currentThread().getId());
        log.info("Id0 records size " +  records.size());

        for (ConsumerRecord<?, ?> record : records) {
            Optional<?> kafkaMessage = Optional.ofNullable(record.value());
            log.info("Received: " + record);
            if (kafkaMessage.isPresent()) {
                Object message = record.value();
                String topic = record.topic();
                log.info("p0 Received message={}",  message);
            }
        }
    }

    @KafkaListener(id = "id1", topicPartitions = { @TopicPartition(topic = TPOIC, partitions = { "1" }) })
    public void listenPartition1(List<ConsumerRecord<?, ?>> records) {
        log.info("Id1 Listener, Thread ID: " + Thread.currentThread().getId());
        log.info("Id1 records size " +  records.size());

        for (ConsumerRecord<?, ?> record : records) {
            Optional<?> kafkaMessage = Optional.ofNullable(record.value());
            log.info("Received: " + record);
            if (kafkaMessage.isPresent()) {
                Object message = record.value();
                String topic = record.topic();
                log.info("p1 Received message={}",  message);
            }
        }
}
关于分区和消费者关系,后面会补充,先摘录如下:
If, say, 6 TopicPartition s are provided and the concurrency is 3; each container will get 2 partitions. For 5 TopicPartition s, 2 containers will get 2 partitions and the third will get 1. If the concurrency is greater than the number of TopicPartitions, the concurrency will be adjusted down such that each container will get one partition.
最后,总结,如果我们的topic有多个分区,经过以上步骤可以很好的加快消息消费。如果只有一个分区,因为已经有一个同名group id在消费了,新启动的一个基本上没有作用(本人测试结果)。
具体代码在这里,欢迎加星号,fork。
发布者:全栈程序员-站长,转载请注明出处:https://javaforall.net/181878.html原文链接:https://javaforall.net



