
一、前言
前面博客小编向大家分享了 kafka如何保证消息不丢失?,基本是从producer和broker来分析的,producer要支持重试和acks,producer要做好副本和及时刷盘落地。
这篇博客呢,就跟大家一起聊一下 kafka 消费者如何消费的?如何避免重复消费?
二、消费者消费流程
消费流程:
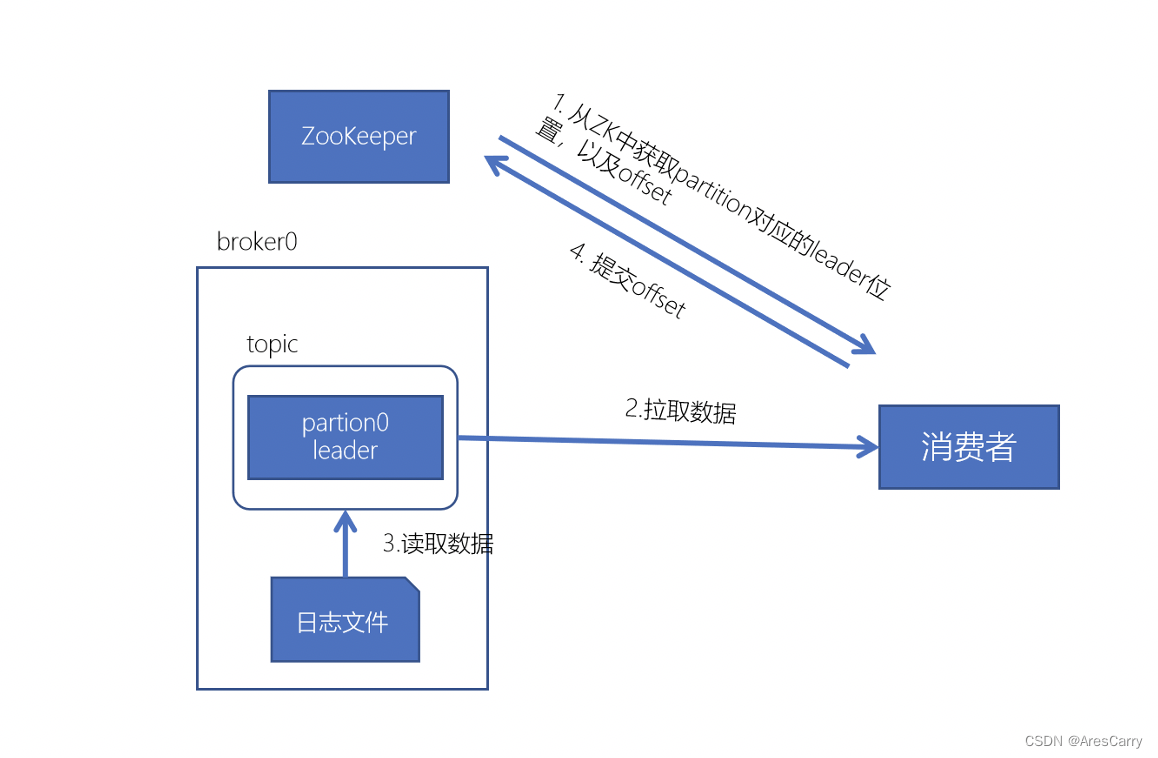
- 从zk获取要消费的partition 的leader的位置 以及 offset位置
- 拉数据,这里拉数据是直接从broker的pagecash拉取,零拷贝 ,所以很快。
- 如果pagecash数据不全,就会从磁盘中拉取,并发送
- 消费完成后,可以手动提交offset,也可以自动提交offset。

消费策略有哪些?如何配置
一般我们消费测试是不会变的,都使用默认的,也就是第一种,range策略。
- Range 范围分配策略(默认)
默认策略,保证基本是均衡的。
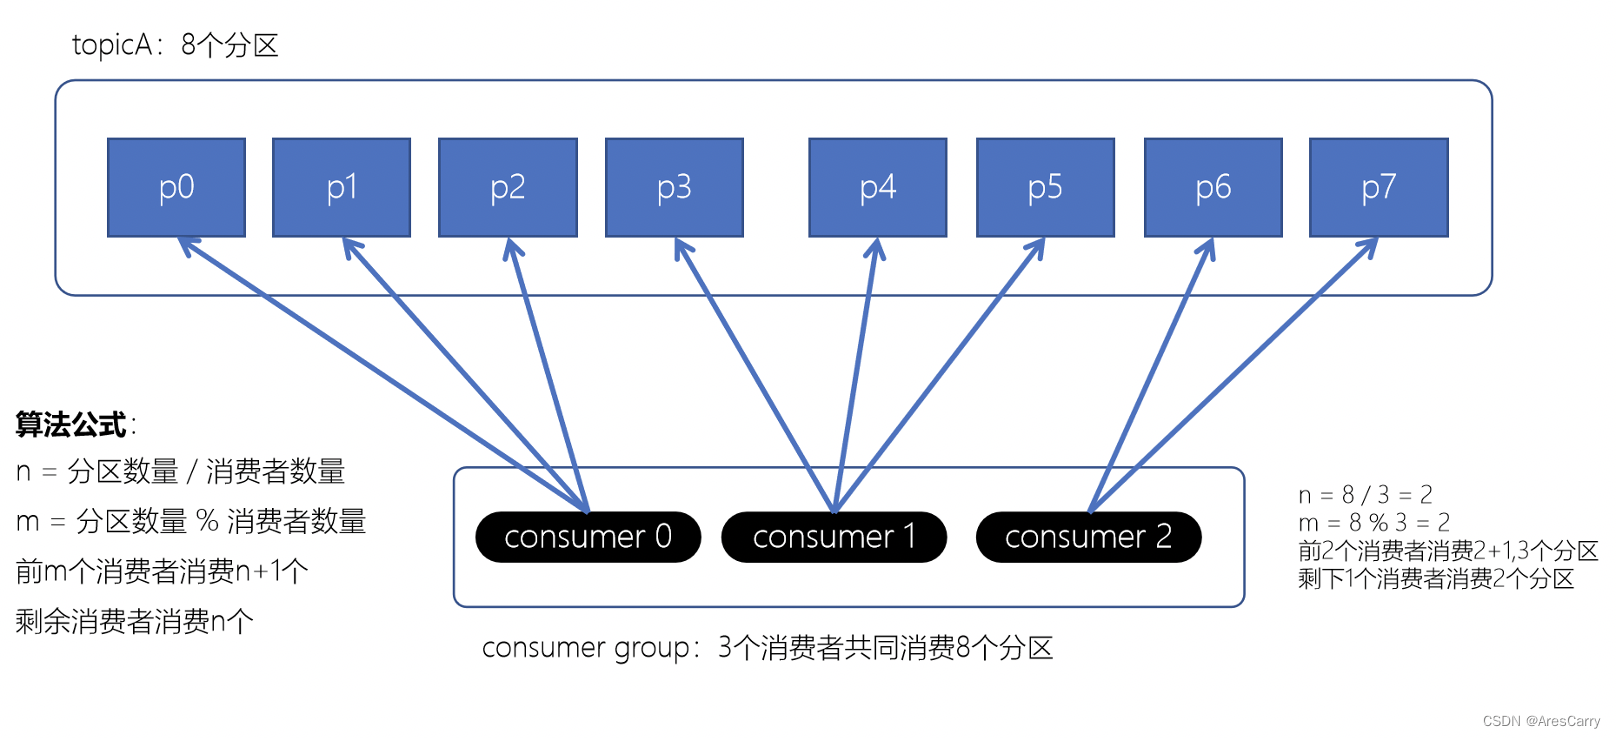
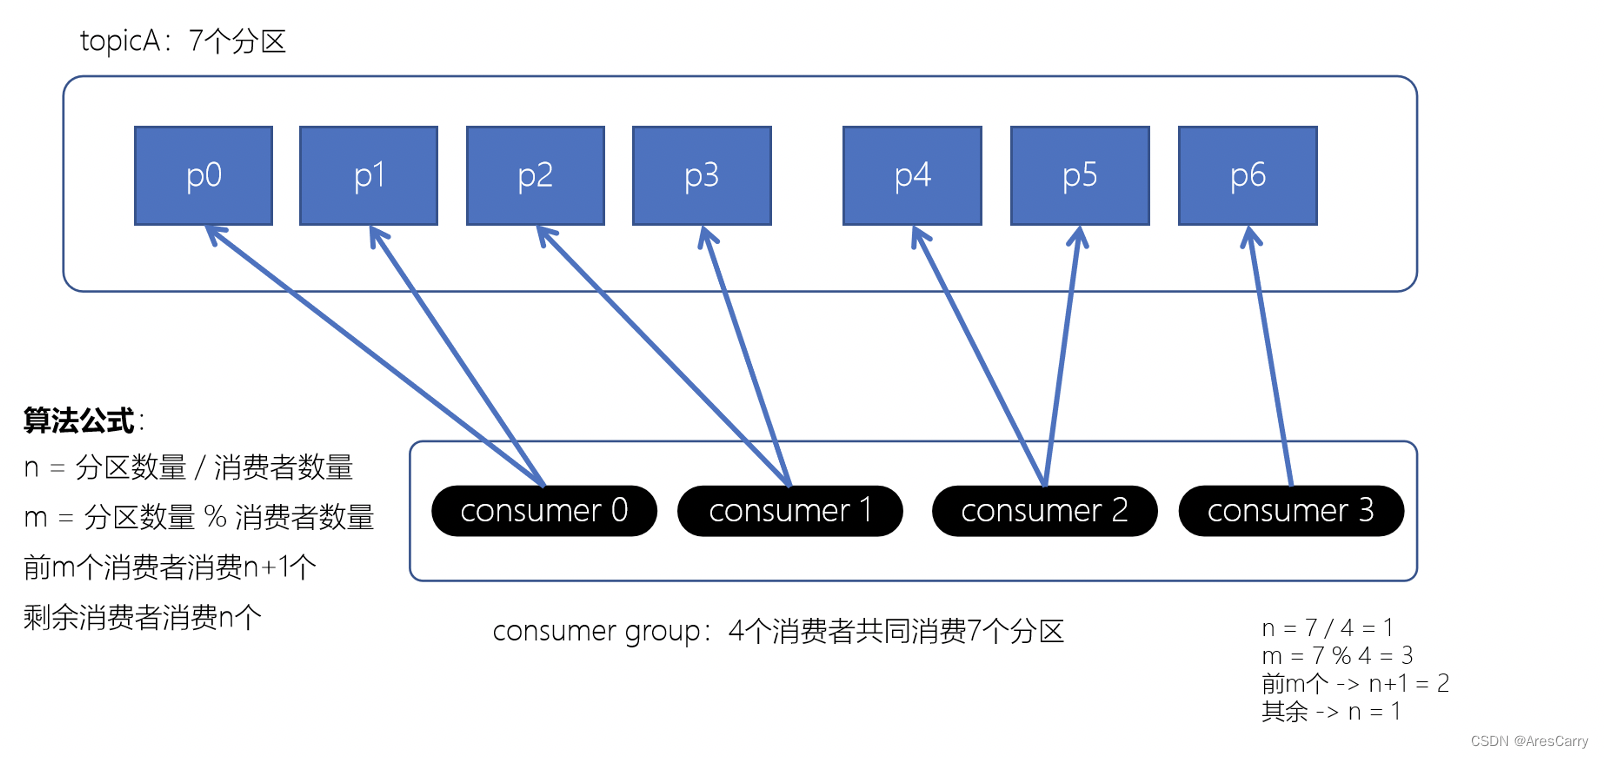
计算公式 :
n = 分区数/消费者数
m = 分区数%消费者数
前m个消费者,消费n+1个,剩余的消费n个
eg:12个partition,9个消费者
12/9 = 1
12%9 = 3
前3台 消费2个partition,后6台各消费1个partition。
- RoundRobin 轮询
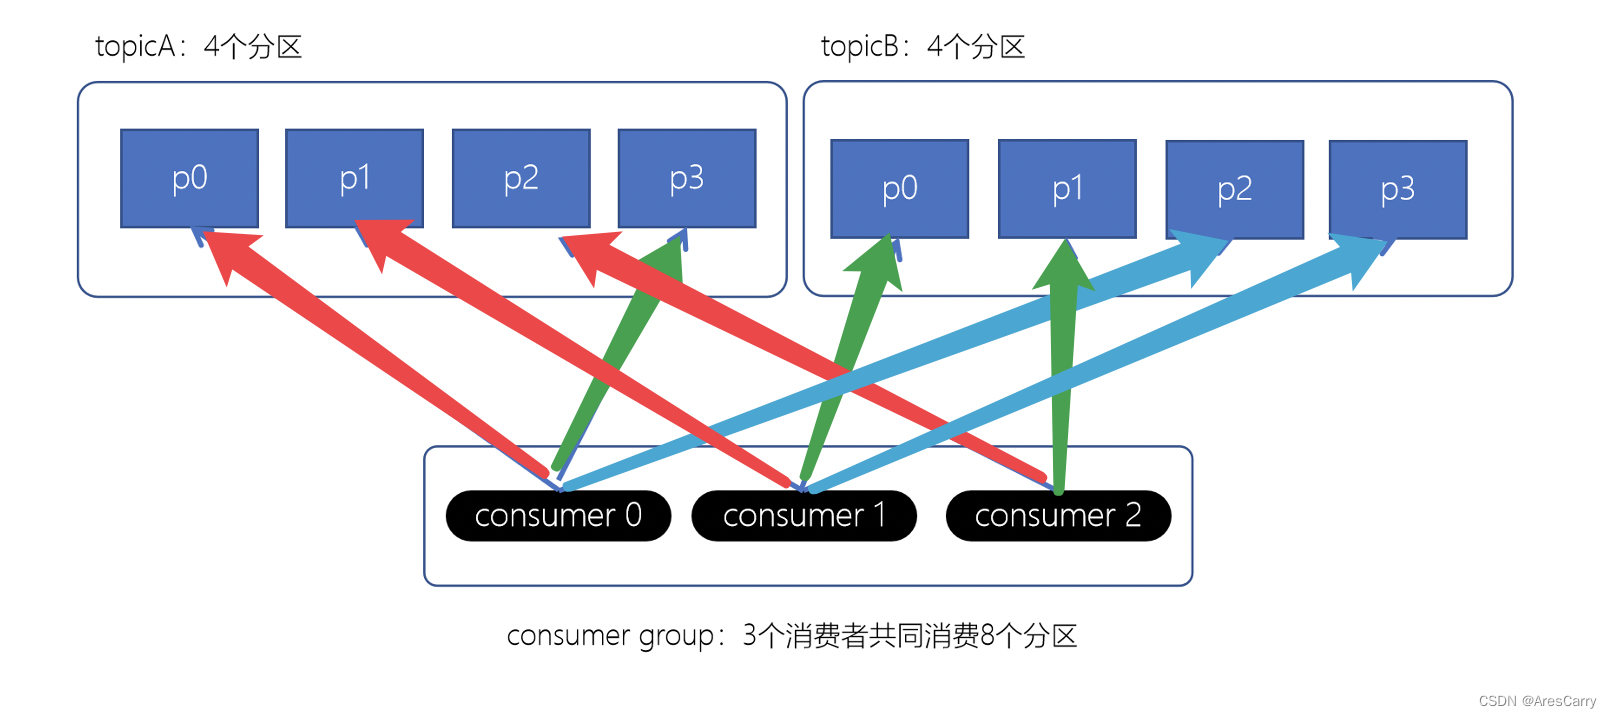
先根据topic 和 topic的partition的hashcode进行一个排序,然后以轮询的方式分配给各个消费者。
- stricky粘性分配策略
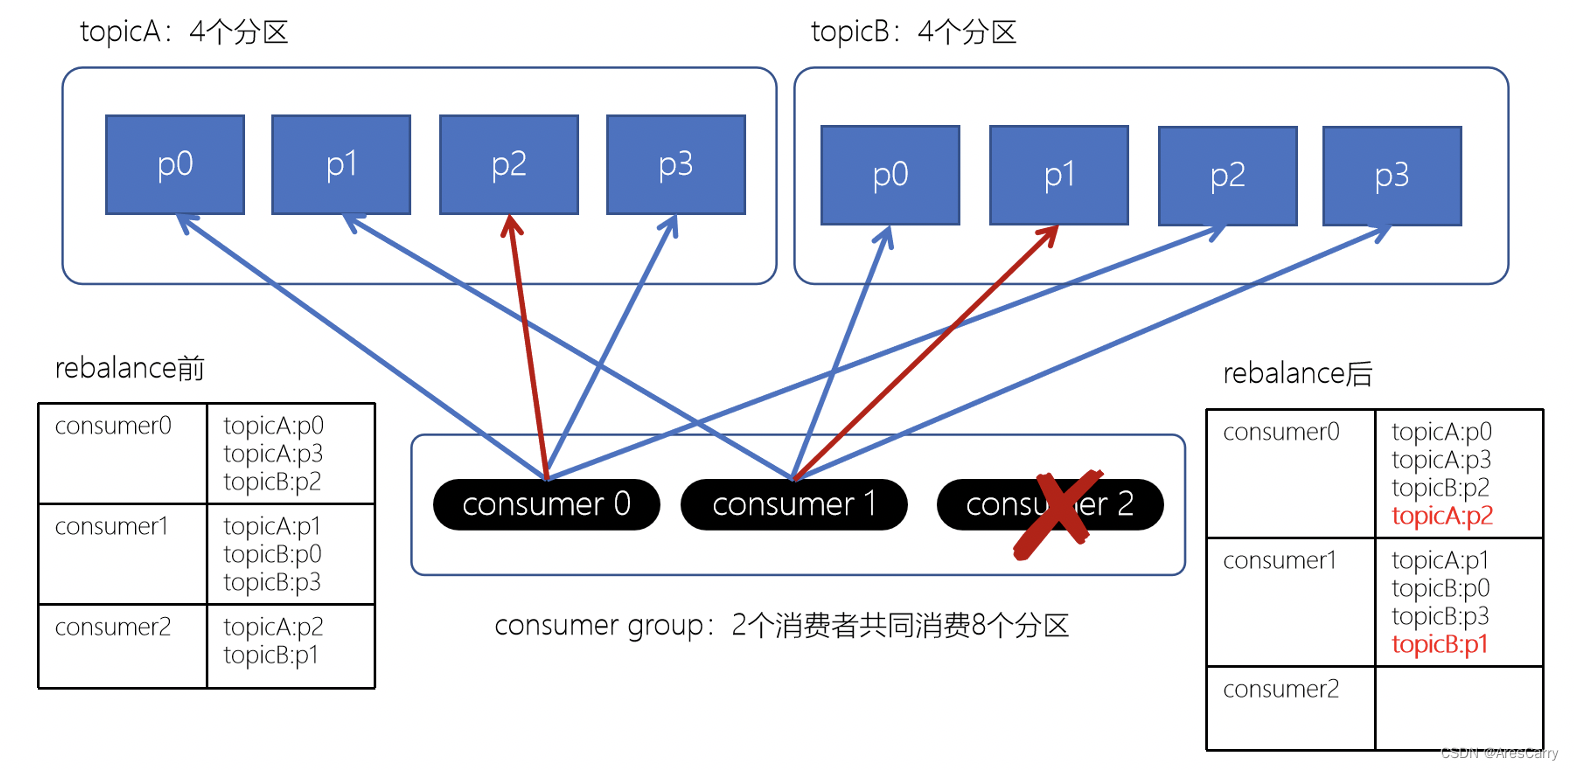
在没有reblence的时候和轮询策略一样
当发生rebalence的时候,尽可能的保证与上一次分配一致
比如默认是
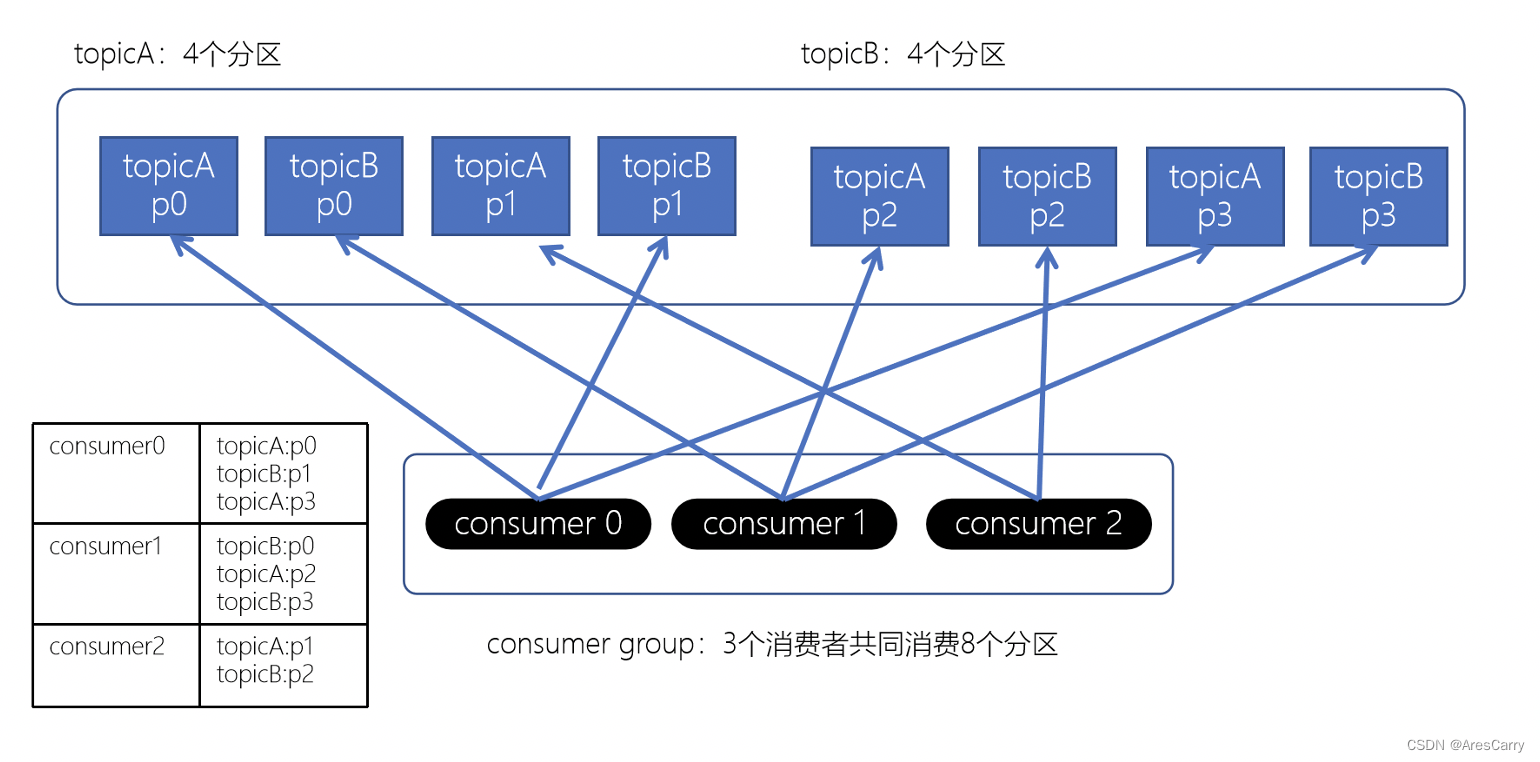
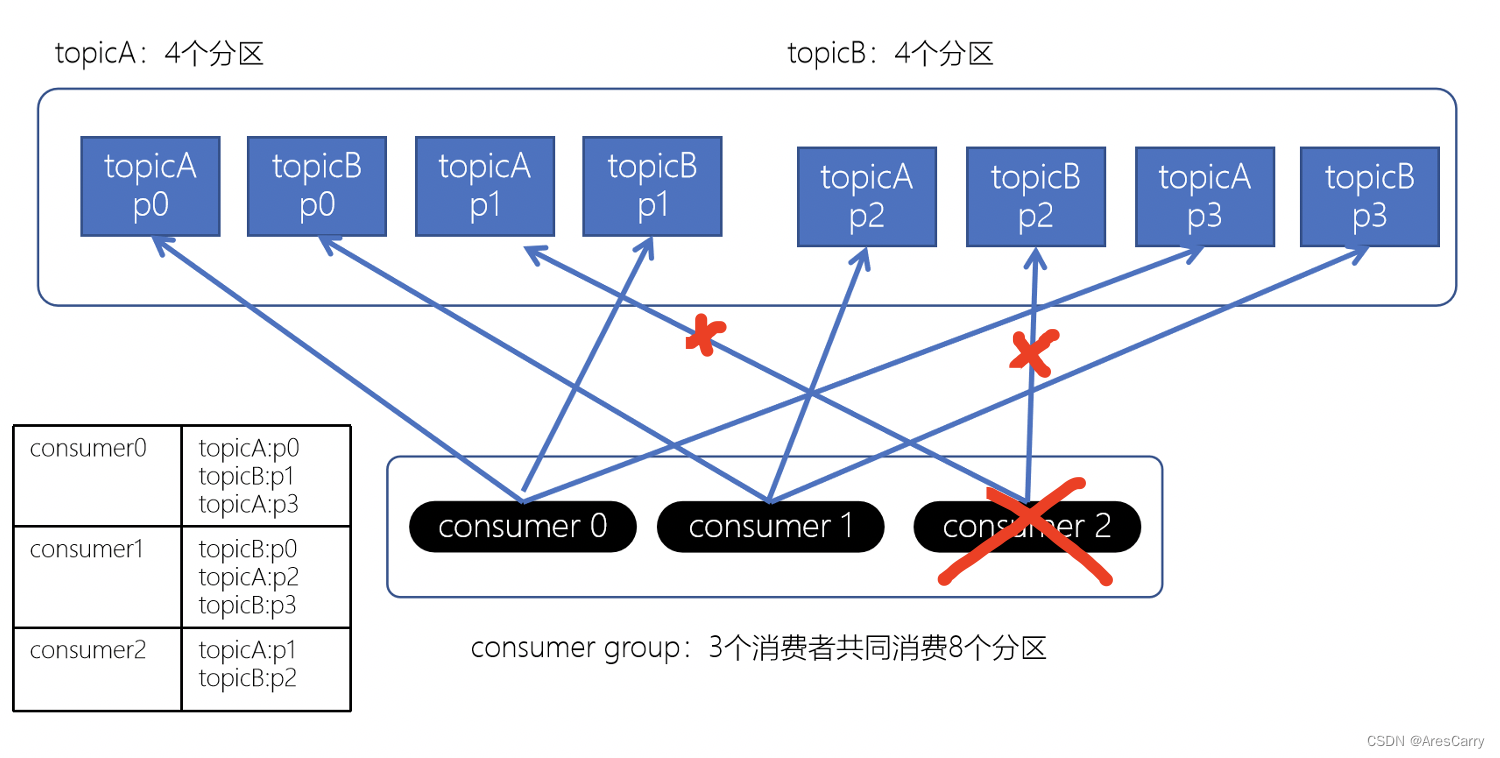
比如consumer2 挂了,topicA p1 和topicB p2就没有消费者了,这个时候要进行消费组的rebalence。
然后按照轮询策略分配一下。
可以在配置消费配置的时候,指定消费策略:
//Range
propsMap.put(ConsumerConfig.PARTITION_ASSIGNMENT_STRATEGY_CONFIG, org.apache.kafka.clients.consumer.RangeAssignor.class);

//RoundRobin
propsMap.put(ConsumerConfig.PARTITION_ASSIGNMENT_STRATEGY_CONFIG, org.apache.kafka.clients.consumer.RoundRobinAssignor.class);

//stricky
propsMap.put(ConsumerConfig.PARTITION_ASSIGNMENT_STRATEGY_CONFIG, org.apache.kafka.clients.consumer.StickyAssignor.class);
什么是零拷贝?
普通把文件发送到远程服务器的方法:
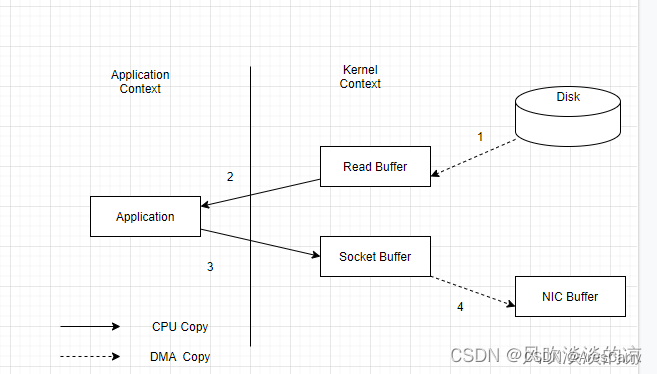
1.读磁盘内容,拷贝到内核缓冲区
2.cpu把内核缓冲区数据拷贝到用户空间缓冲区
3.调用write(),把用户空间缓冲区数据拷贝到内核的Socket Buffer中
4.把sb中的数据拷贝到网卡缓冲区 NIC Buffer ,网卡在传输
从上面的流程看, 1和3 其实是多余的,用户和内核相互转换,会带来cpu上下文切换,对cpu性能有影响。
零拷贝 就是对这两次的拷贝忽略掉,应用程序可以直接把磁盘中的数据从内核中,直接传输到socket,不用互相拷贝。其中用到了Direct Memory Access 技术,可以把数据直接从内核空间传递到网卡设备,kafka中把数据直接从磁盘复制到 pagecash,给消费者读取,如图:
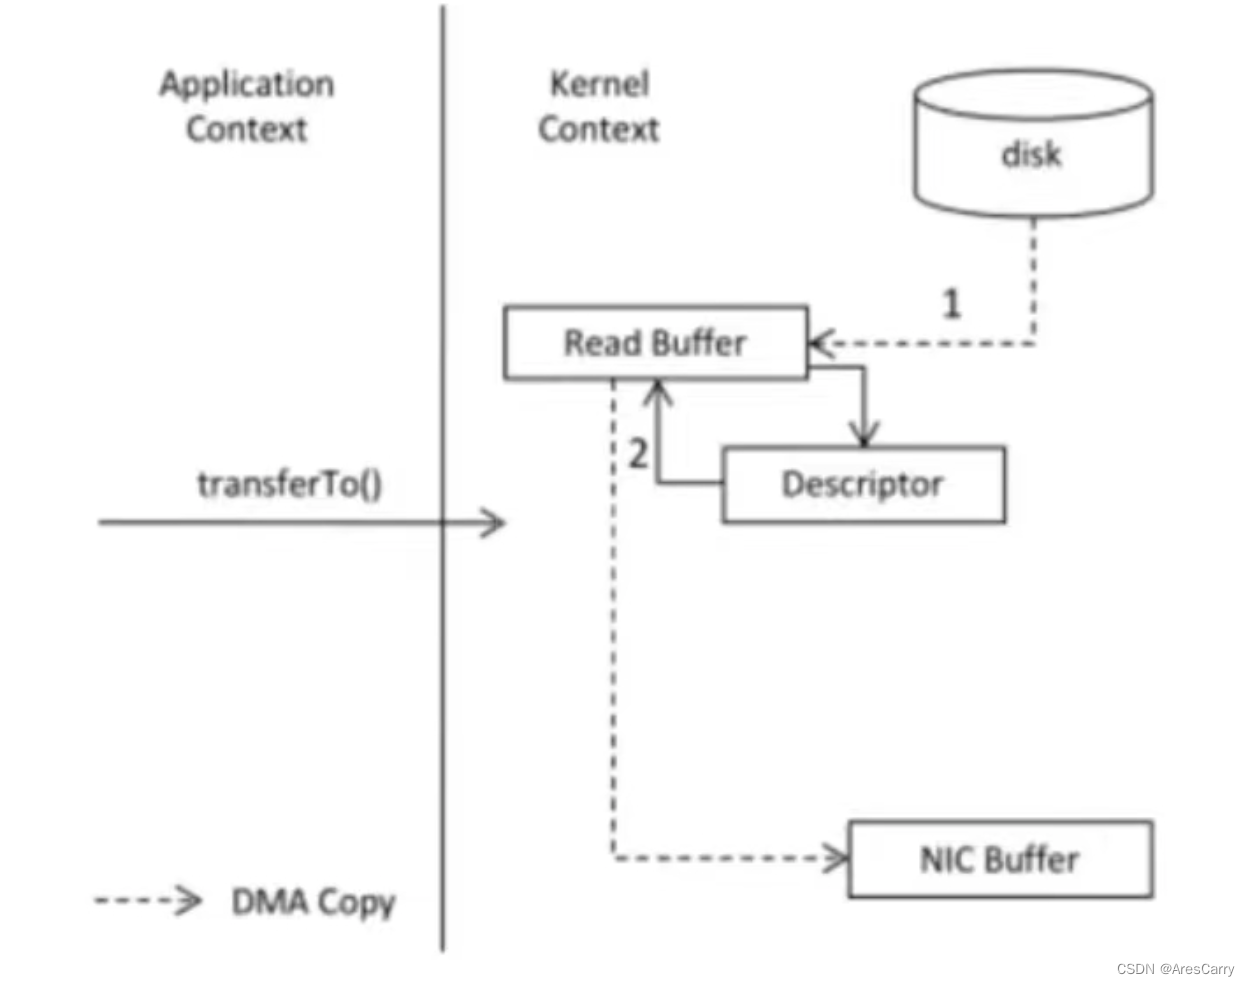
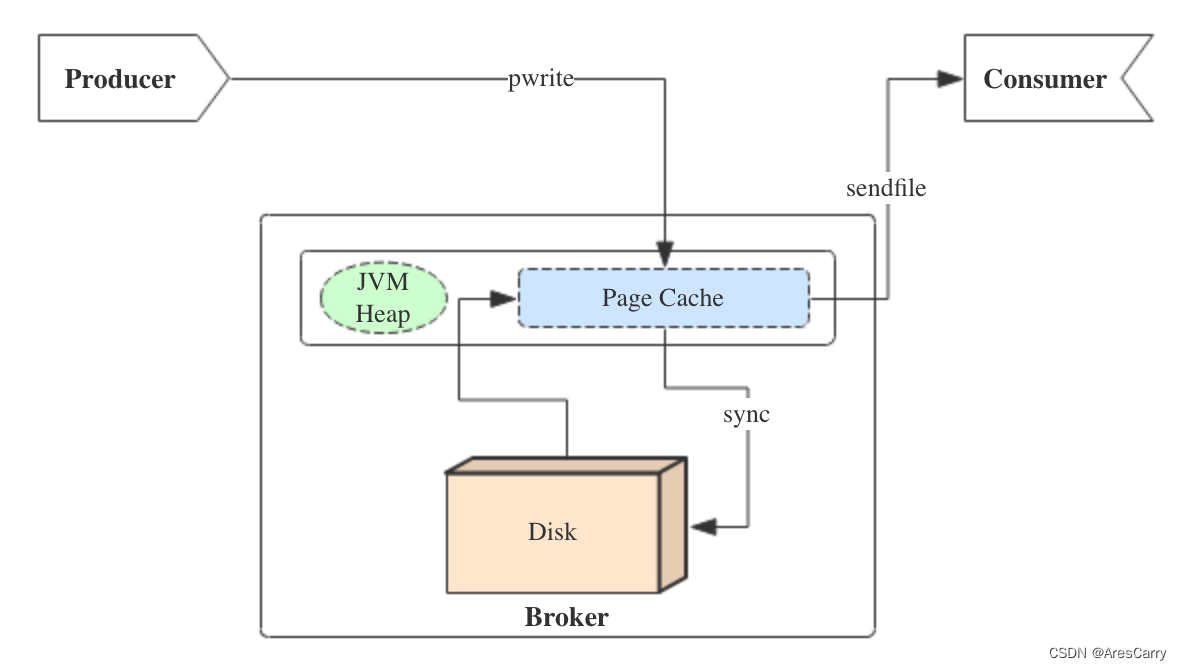
零拷贝其实不是没有拷贝,只是减少了不必要的拷贝次数,比如内核到用户空间的拷贝。
linux 中使用sendfile()实现零拷贝
java中nio用到零拷贝,比如filechannel.transferTo()。
mmap 文件映射机制:把磁盘文件映射到内存,用户通过修改内存,就可以修改磁盘文件。提高io效率,减少了复制开销。
三、如何避免重复消费?
分析原因:
1.生产者重复提交
2.rebalence引起重复消费
超过一定时间(max.poll.interval.ms设置的值,默认5分钟)未进行poll拉取消息,则会导致客户端主动离开队列,而引发Rebalance,提交offset失败。其他消费者会从没有提交的位置消费,从而导致重复消费。
解决方案:
1.提高消费速度
- 增加消费者
- 多线程消费
- 异步消费
- 调整消费处理时间
2.幂等处理
-
消费者设置幂等校验
-
开启kafka幂等配置,生产者开启幂等配置,将消息生成md5,然后保存到redis中,处理新消息的时候先校验。这个尽量不要开启,消耗性能。
props.put(ProducerConfig.ENABLE_IDEMPOTENCE_CONFIG, true);
四、如何顺序消费?
我们知道kafka,整个topic有多个partition,每个partition内的消息是有顺序的。
五、如何延迟消费?
kafka是无状态的,没有延迟的功能。pulsar和rabbitmq实现更加方便。
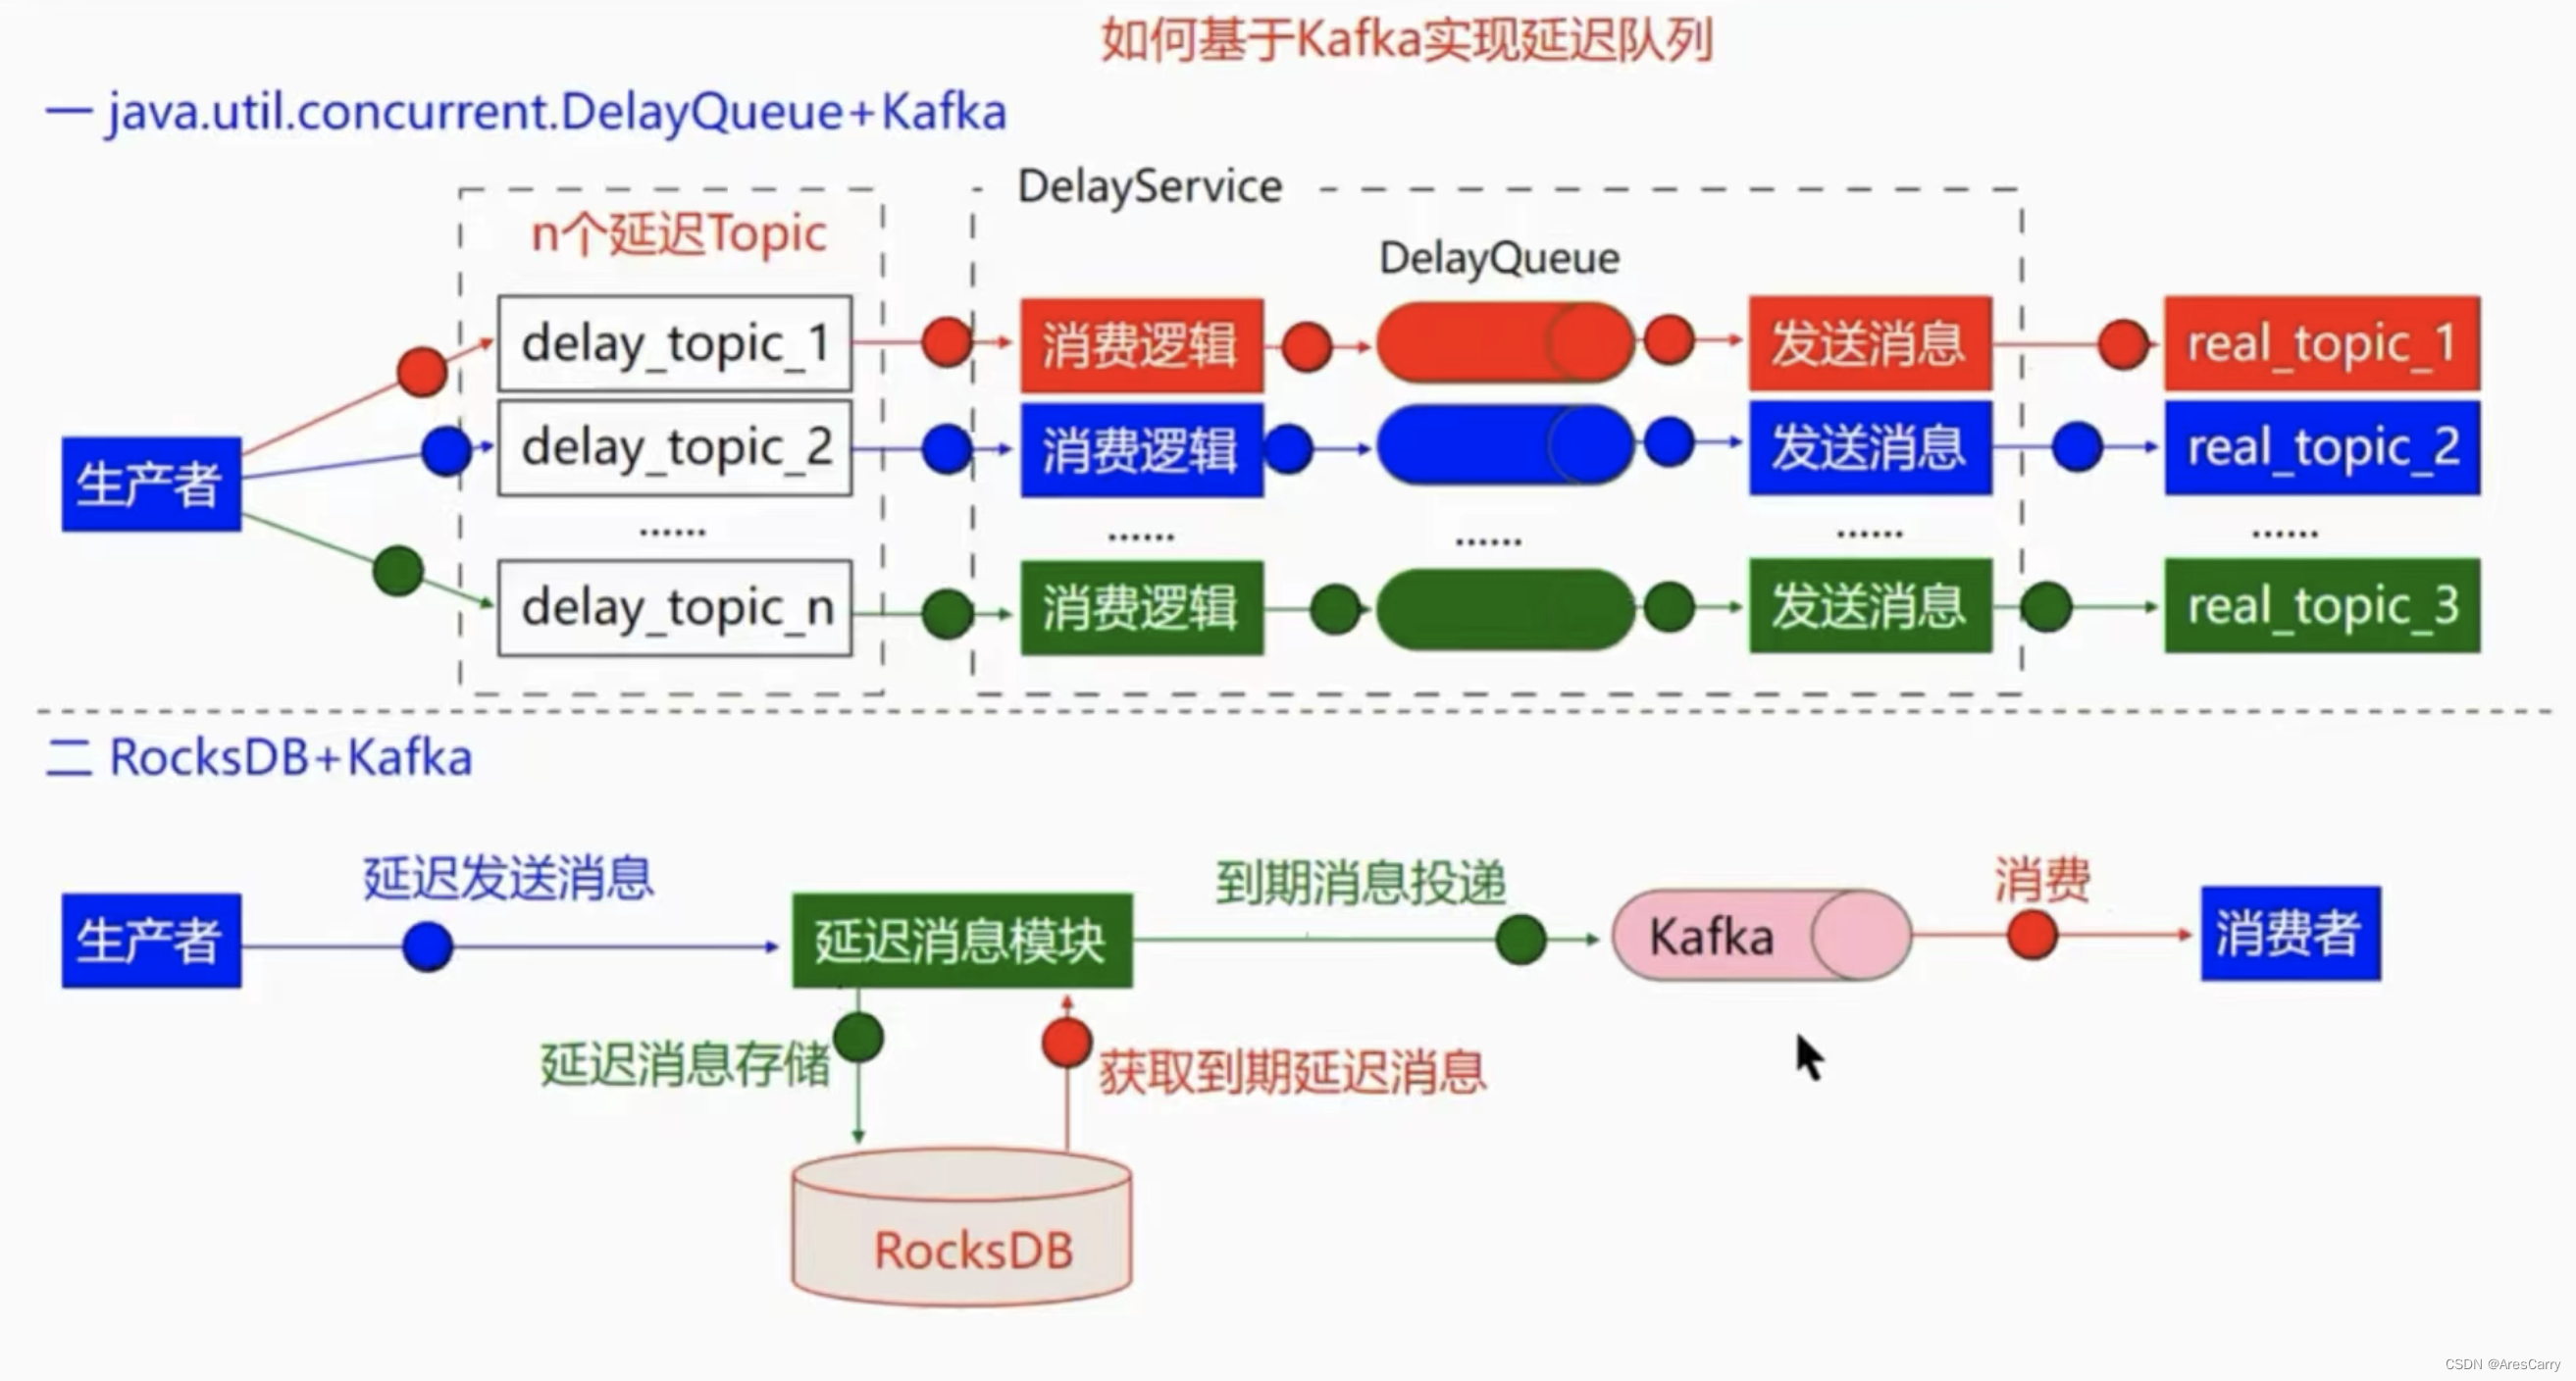
开发延迟推送服务,定时检索延迟消息,发送给kafka。
六、频繁rebanlence怎么解决?
再均衡,保证所有消费者相对均衡消费。rebalence的时候,所有消费者,停止消费,直到rebanlence完成。
触发时机:
1.consumer个数变化
2.订阅topic个数变化
3.订阅的topic的partition变化
解决方案:
使用消息队列Kafka版时消费客户端频繁出现Rebalance
频繁出现rebalence,可能是消费者的消费时间过长,超过一定时间(max.poll.interval.ms设置的值,默认5分钟)未进行poll拉取消息,则会导致客户端主动离开队列,而引发Rebalance。
1.参数调整:
session.timeout.ms:v0.10.2之前的版本可适当提高该参数值,需要大于消费一批数据的时间,但不要超过30s,建议设置为25s;而v0.10.2及其之后的版本,保持默认值10s即可。
max.poll.records:降低该参数值,建议远远小于<单个线程每秒消费的条数> * <消费线程的个数> * <max.poll.interval.ms>的积。
max.poll.interval.ms: 该值要大于<max.poll.records> / (<单个线程每秒消费的条数> * <消费线程的个数>)的值。
2.尽量提高客户端的消费速度,消费逻辑另起线程进行处理。
3.减少Group订阅Topic的数量,一个Group订阅的Topic最好不要超过5个,建议一个Group只订阅一个Topic。
附:批量消费代码
import com.ctrip.framework.apollo.ConfigService;
import org.apache.kafka.clients.consumer.ConsumerConfig;
import org.apache.kafka.common.serialization.StringDeserializer;
import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;
import org.springframework.kafka.annotation.EnableKafka;
import org.springframework.kafka.config.ConcurrentKafkaListenerContainerFactory;
import org.springframework.kafka.config.KafkaListenerContainerFactory;
import org.springframework.kafka.core.DefaultKafkaConsumerFactory;
import org.springframework.kafka.listener.ConcurrentMessageListenerContainer;

import java.util.HashMap;
import java.util.Map;

@Configuration
@EnableKafka
public class BehaviorConsumerConfig {


    public Map<String, Object> consumerConfigs() {

        Map<String, Object> propsMap = new HashMap<>();
        propsMap.put(ConsumerConfig.BOOTSTRAP_SERVERS_CONFIG, servers);
        propsMap.put(ConsumerConfig.ENABLE_AUTO_COMMIT_CONFIG, enableAutoCommit);
        propsMap.put(ConsumerConfig.GROUP_ID_CONFIG, groupId);
        propsMap.put(ConsumerConfig.AUTO_COMMIT_INTERVAL_MS_CONFIG, autoCommitInterval);
        propsMap.put(ConsumerConfig.AUTO_OFFSET_RESET_CONFIG, autoOffsetReset);
        propsMap.put(ConsumerConfig.KEY_DESERIALIZER_CLASS_CONFIG, StringDeserializer.class);
        propsMap.put(ConsumerConfig.VALUE_DESERIALIZER_CLASS_CONFIG, StringDeserializer.class);
        propsMap.put(ConsumerConfig.MAX_POLL_RECORDS_CONFIG, maxPollRecordsConfig);
            propsMap.put(ConsumerConfig.PARTITION_ASSIGNMENT_STRATEGY_CONFIG, org.apache.kafka.clients.consumer.StickyAssignor.class);

        propsMap.put("security.protocol", protocol);
        propsMap.put("ssl.truststore.location", truststoreLocation.replaceAll("file://", ""));
        propsMap.put("ssl.truststore.password", truststorePassword);
        propsMap.put("login.config.location", loginConfigLocation);
        propsMap.put("sasl.mechanism", mechanism);
        return propsMap;
    }

    @Bean("batchContainerFactory")
    KafkaListenerContainerFactory<ConcurrentMessageListenerContainer<String, String>> kafkaListenerContainerFactory() {

        ConcurrentKafkaListenerContainerFactory<String, String> factory = new ConcurrentKafkaListenerContainerFactory<>();
        factory.setConsumerFactory(new DefaultKafkaConsumerFactory<>(consumerConfigs()));

        // 并发创建的消费者数量
        factory.setConcurrency(4);
        factory.getContainerProperties().setPollTimeout(3000);

        //设置为批量消费,每个批次数量在Kafka配置参数中设置ConsumerConfig.MAX_POLL_RECORDS_CONFIG
        factory.setBatchListener(true);
        return factory;
    }
}
七、小结
本篇我们基本上把消费者的消费梳理干净了,以及消费会遇到的 重复消费,顺序消费,延迟消费等问题都也解释了给出了解决方案。方案一通百通。
发布者:全栈程序员-站长,转载请注明出处:https://javaforall.net/183641.html原文链接:https://javaforall.net



