
Jetbrains全系列IDE使用 1年只要46元 售后保障 童叟无欺
目录
一、TCP协议
TCP,即Transmission Control Protocol,传输控制协议。人如其名,要对数据的传输进行一个详细的 控制。
TCP协议段格式
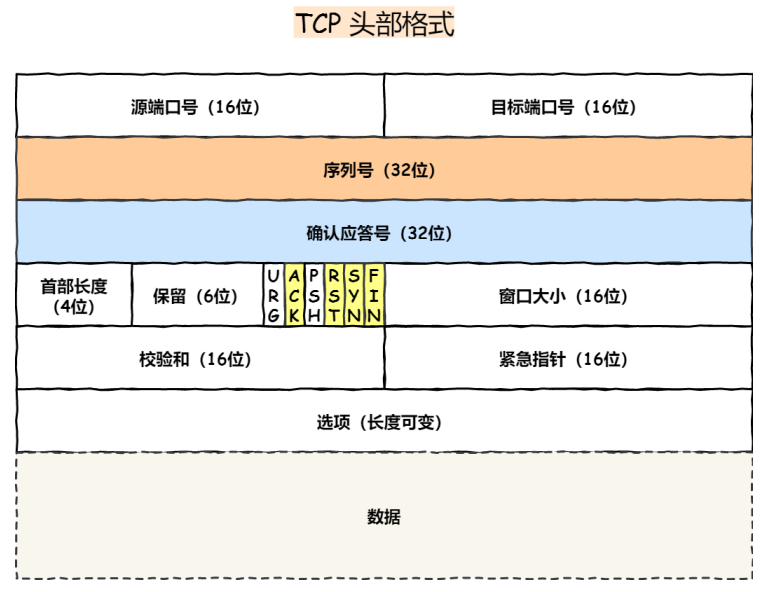
源/目的端口号:表示数据是从哪个进程来,到哪个进程去;
序列号:在建立连接时由计算机生成的随机数作为其初始值,通过 SYN 包传给接收端主机,每发送一 次数据,就「累加」一次该「数据字节数」的大小。用来解决网络包乱序问题。
确认应答号:指下一次「期望」收到的数据的序列号,发送端收到这个确认应答以后可以认为在这个序号以前的数据都已经被正常接收。用来解决不丢包的问题。
6位标志位:
URG:紧急指针是否有效
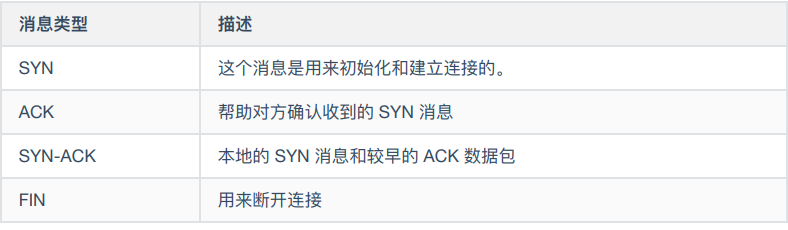
ACK:确认号是否有效,该位为 1 时,「确认应答」的字段变为有效,TCP 规定除了最初建立连接时的 SYN 包之外该位必须设置为 1 。
PSH:提示接收端应用程序立刻从TCP缓冲区把数据读走
RST:对方要求重新建立连接;我们把携带RST标识的称为复位报文段,该位为 1 时,表示 TCP 连接中出现异常必须强制断开连接。
SYN:请求建立连接;我们把携带SYN标识的称为同步报文段,该位为 1 时,表示希望建立连接,并在其「序列号」的字段进行序列号初始值的设定。
FIN:通知对方,本端要关闭了,我们称携带FIN标识的为结束报文段,该位为 1 时,表示今后不会再有数据发送,希望断开连接。当通信结束希望断开连接时, 通信双方的主机之间就可以相互交换 FIN 位为 1 的 TCP 段。
二、TCP原理
TCP对数据传输提供的管控机制,主要体现在两个方面:安全和效率。 这些机制和多线程的设计原则类似:保证数据传输安全的前提下,尽可能的提高传输效率。

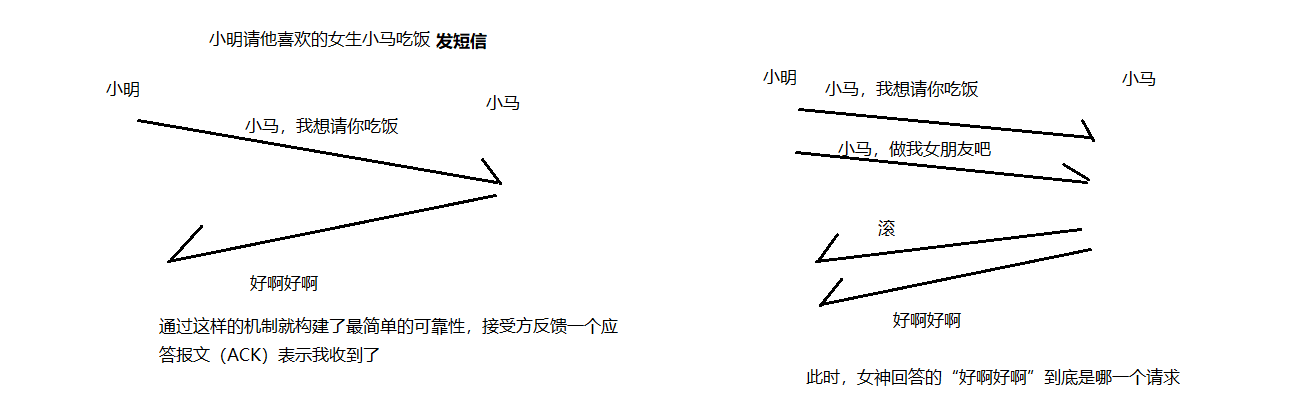
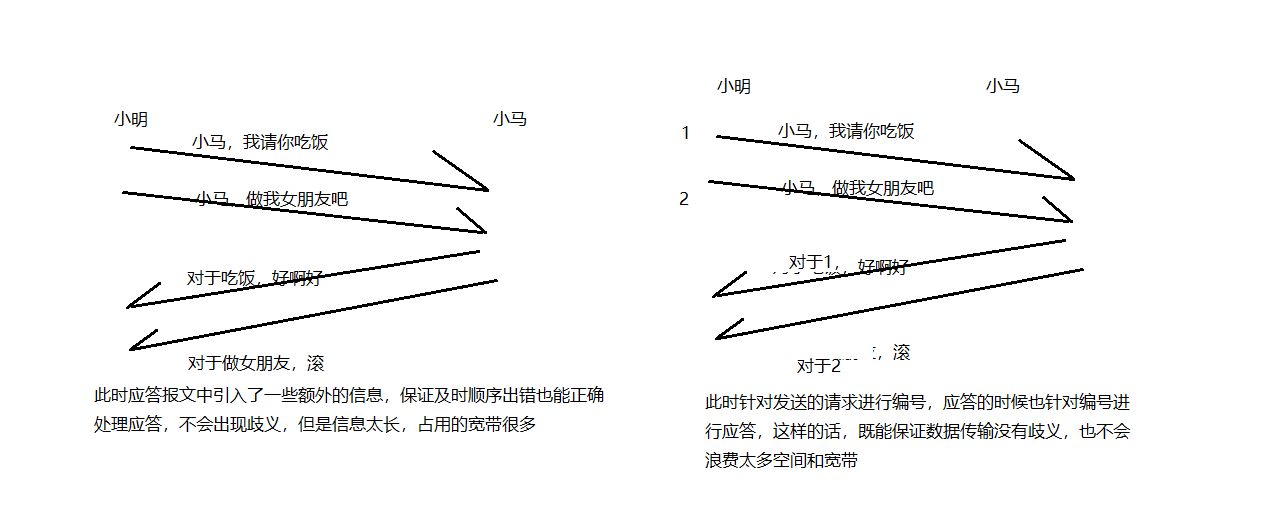
1,确认应答机制
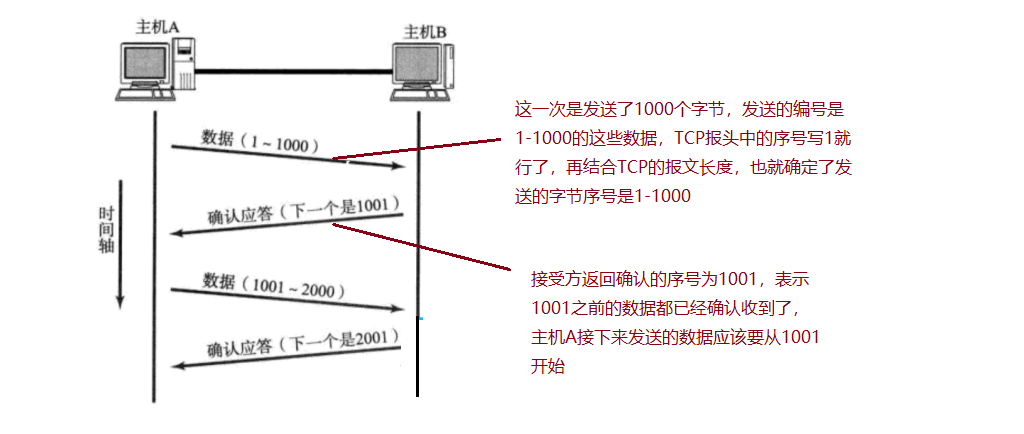
2,超时重传机制

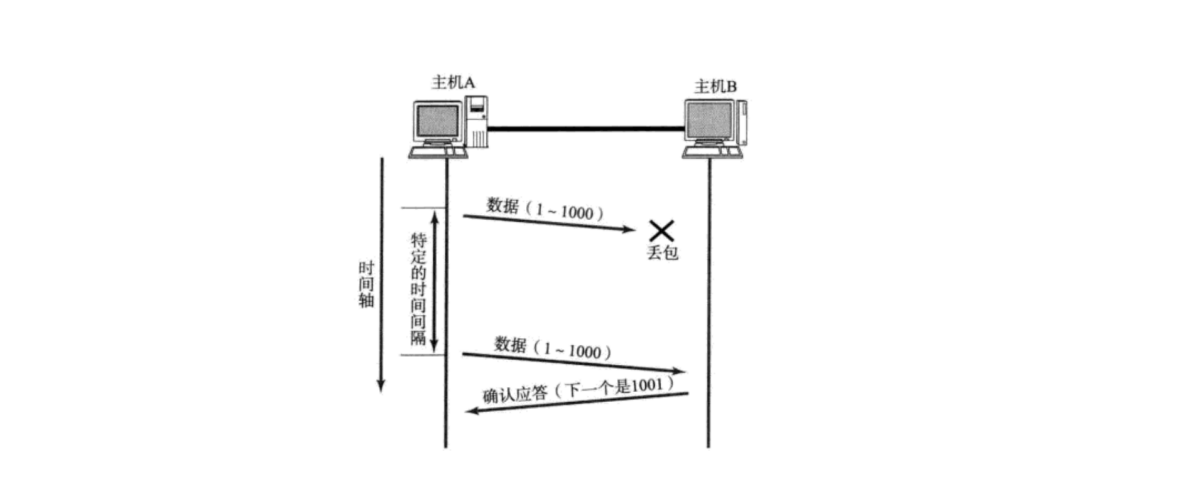
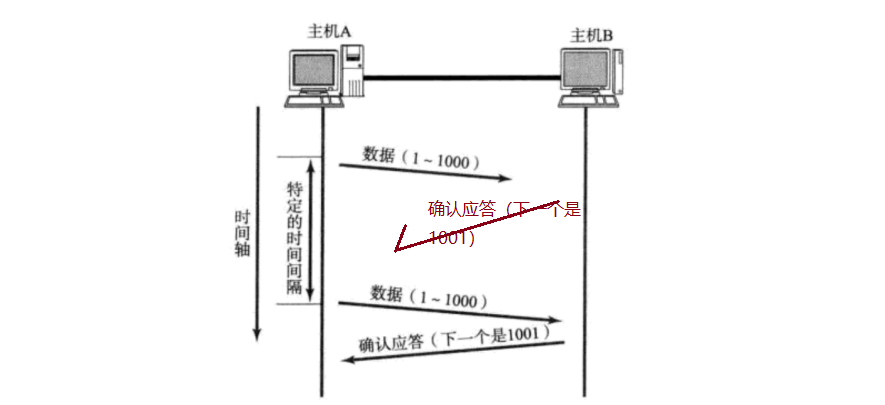
因此主机B会收到很多重复数据。那么TCP协议需要能够识别出那些包是重复的包,并且把重复的丢弃掉。这时候我们可以利用前面提到的序列号,就可以很容易做到去重的效果。
这时候我们可以利用前面提到的序列号,就可以很容易做到去重的效果。
最理想的情况下,找到一个最小的时间,保证 “确认应答一定能在这个时间内返回”。
但是这个时间的长短,随着网络环境的不同,是有差异的。
如果超时时间设的太长,会影响整体的重传效率;
如果超时时间设的太短,有可能会频繁发送重复的包;
TCP为了保证无论在任何环境下都能比较高性能的通信,因此会动态计算这个最大超时时间。
Linux中(BSD Unix和Windows也是如此),超时以500ms为一个单位进行控制,每次判定 超时重发的超时时间都是500ms的整数倍。
如果重发一次之后,仍然得不到应答,等待 2*500ms 后再进行重传。
如果仍然得不到应答,等待 4*500ms 进行重传。依次类推,以指数形式递增。
累计到一定的重传次数,TCP认为网络或者对端主机出现异常,强制关闭连接。
3,连接管理机制
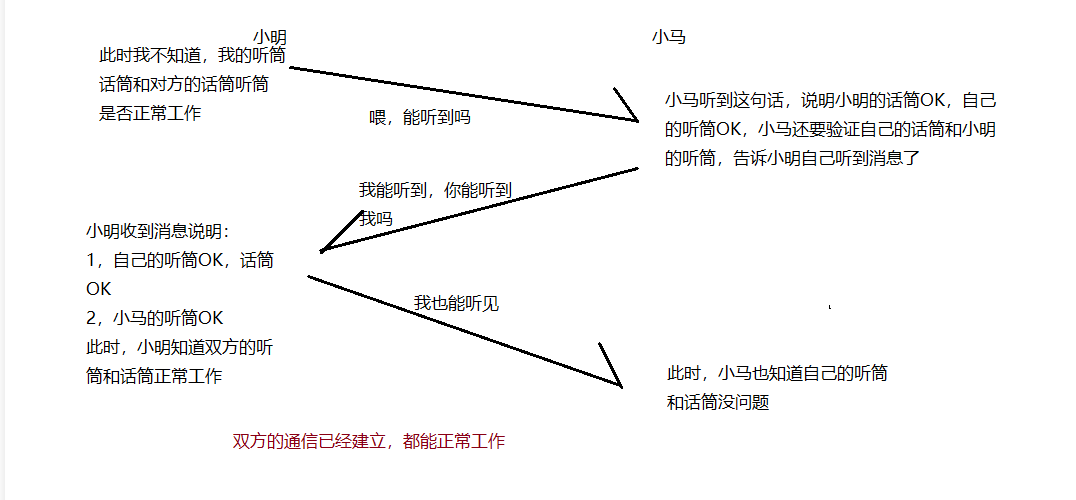
SYN同步报文段,尝试和对方建立连接,JavaSocket API中,客户端new Socket内核就会发起这样的SYN请求
SYN这个标志位为1,表示是一个同步报文段
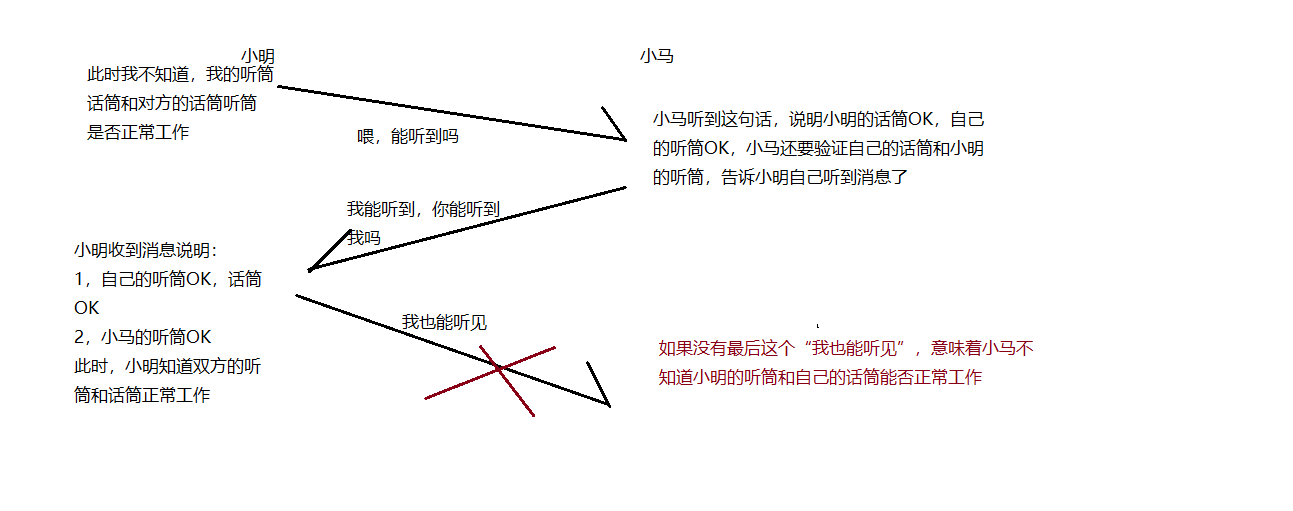
我能听见(ACK),你能听见我吗(SYN)
建立连接的过程,相当于通信双方各自给对方发送SYN,再各自给对方发送ACK中间的ACK和SYN和二为一,于是最后就是“三次握手”
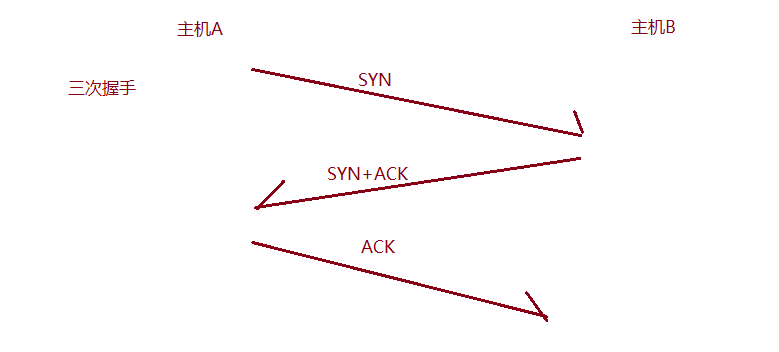
能否只有两次握手
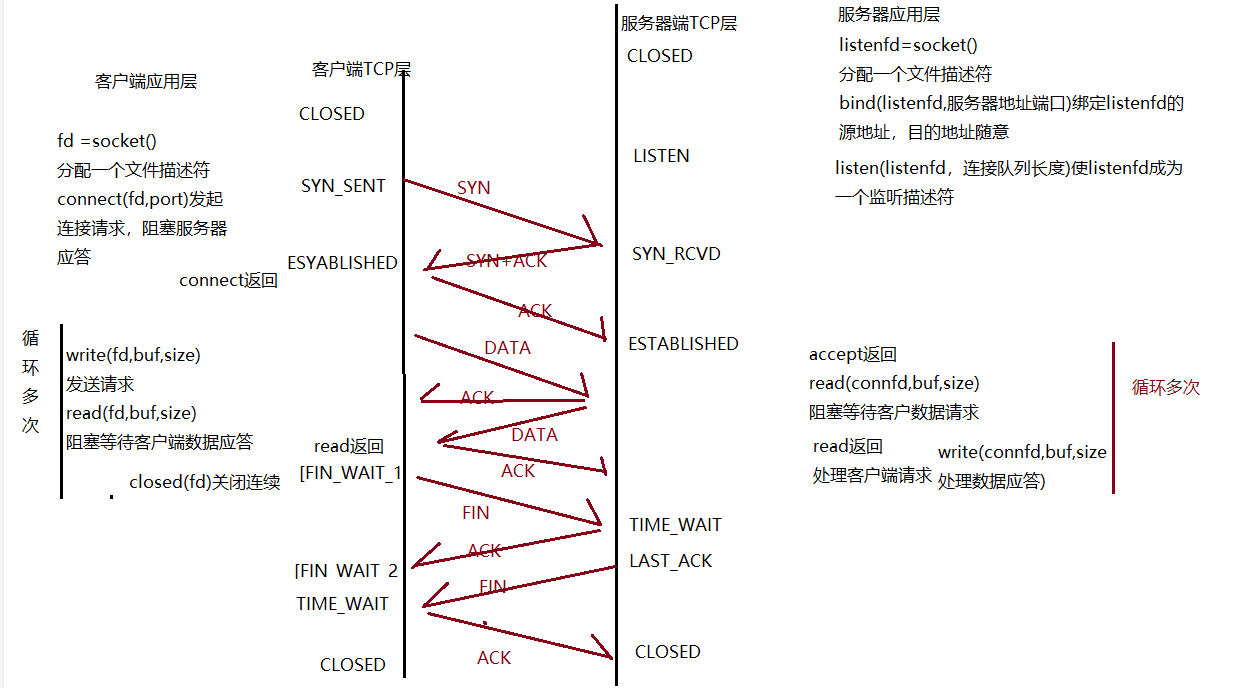
服务端状态转化:
[CLOSED -> LISTEN] 服务器端调用listen后进入LISTEN状态,等待客户端连接;
[LISTEN -> SYN_RCVD] 一旦监听到连接请求(同步报文段),就将该连接放入内核等待队 列中,并向客户端发送SYN确认报文。
[SYN_RCVD -> ESTABLISHED] 服务端一旦收到客户端的确认报文,就进入ESTABLISHED状 态,可以进行读写数据了。
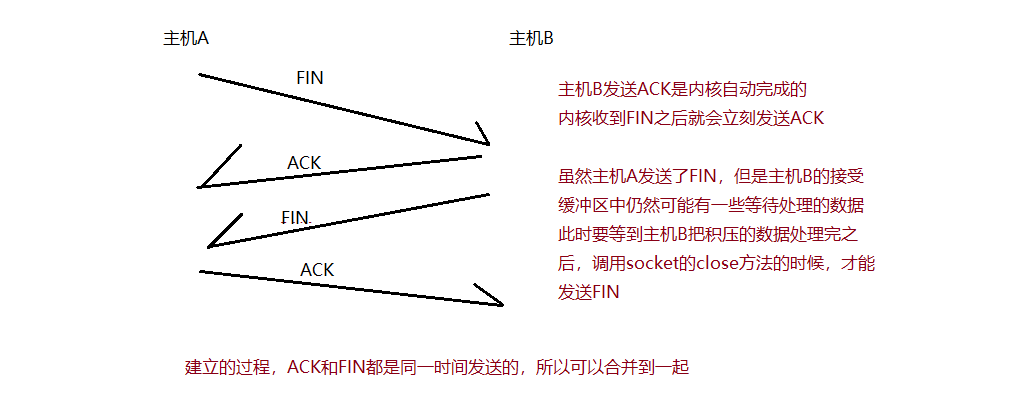
[ESTABLISHED -> CLOSE_WAIT] 当客户端主动关闭连接(调用close),服务器会收到结束 报文段,服务器返回确认报文段并进入CLOSE_WAIT;
[CLOSE_WAIT -> LAST_ACK] 进入CLOSE_WAIT后说明服务器准备关闭连接(需要处理完之 前的数据);当服务器真正调用close关闭连接时,会向客户端发送FIN,此时服务器进入 LAST_ACK状态,等待最后一个ACK到来(这个ACK是客户端确认收到了FIN)
[LAST_ACK -> CLOSED] 服务器收到了对FIN的ACK,彻底关闭连接。
客户端状态转化:
[CLOSED -> SYN_SENT] 客户端调用connect,发送同步报文段;
[SYN_SENT -> ESTABLISHED] connect调用成功,则进入ESTABLISHED状态,开始读写数据;
[ESTABLISHED -> FIN_WAIT_1] 客户端主动调用close时,向服务器发送结束报文段,同时 进入FIN_WAIT_1;
[FIN_WAIT_1 -> FIN_WAIT_2] 客户端收到服务器对结束报文段的确认,则进入 FIN_WAIT_2,开始等待服务器的结束报文段;
[FIN_WAIT_2 -> TIME_WAIT] 客户端收到服务器发来的结束报文段,进入TIME_WAIT,并发 出LAST_ACK;
[TIME_WAIT -> CLOSED] 客户端要等待一个2MSL(Max Segment Life,报文最大生存时 间)的时间,才会进入CLOSED状态。
重要的转状态:
1,LISTEN:服务器启动完毕,随时可以有客户端来连接
2,ESTABLISHED:建立连接成功,随时传输消息
服务器调用new ServerSocket就会绑定端口号,并且进入LISTEN状态
客户端调用new Socket,就会尝试和服务器建立连接并触发三次握手
三次握手不能只握两次,如果没有最后一个ACK,此时主机B是无法知道自己发送能力和对方接受能力是否正常
三次握手,握手四次可以但没必要,中间的SYN和ACK是同一时刻触发的
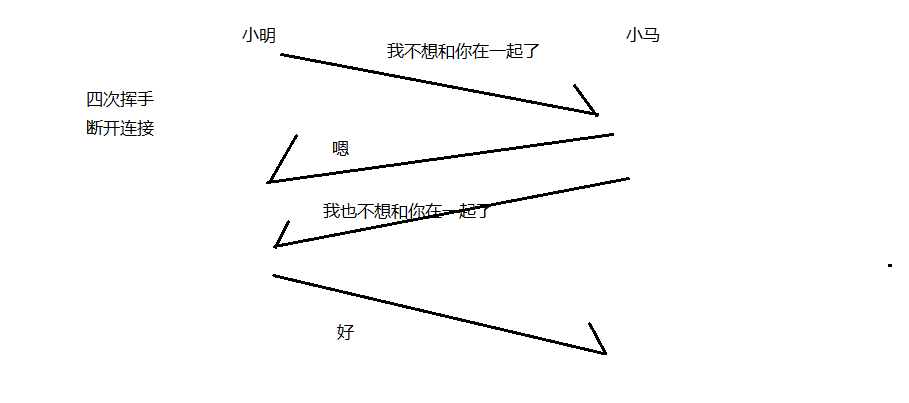
3,CLOSE_WAIT:四次挥手挥手一半剩下的两次就不挥手了(接收方没调用close方法,就会导致四次挥手只挥手两次,从而没有正确关闭连接)。
4,TIME_WAIT:谁主动断开连接,谁进入TIME_WAIT状态,此时主机已经完成四次挥手过程,但是仍然不能立即释放,要等TIME_WAIT状态保持一定时间之后释放
三次握手和四次挥手过程出现丢包就会触发超时重传
4,滑动窗口
没有滑动窗口的机制下,传输N份数据,就需要等待N次应答时间,总的传输时间:N份数据传输时间+N份应答时间。
滑动窗口的实质就是批量传输数据,总的传输时间:N份数据传输时间重叠成1份时间。
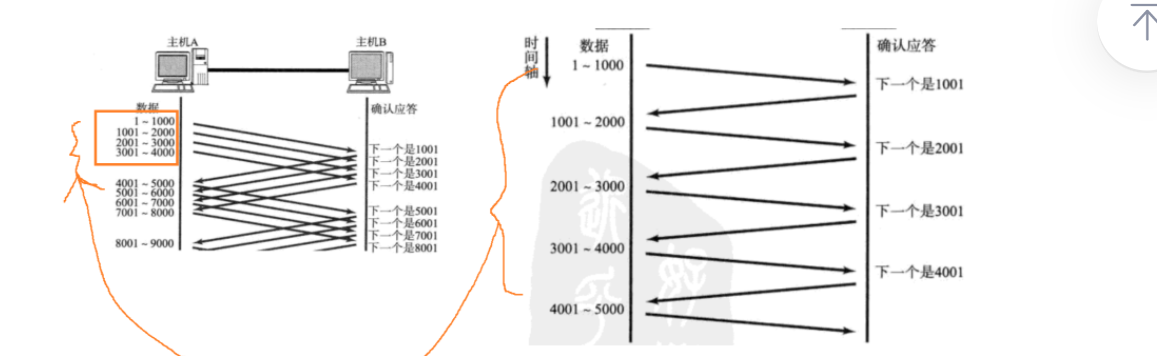
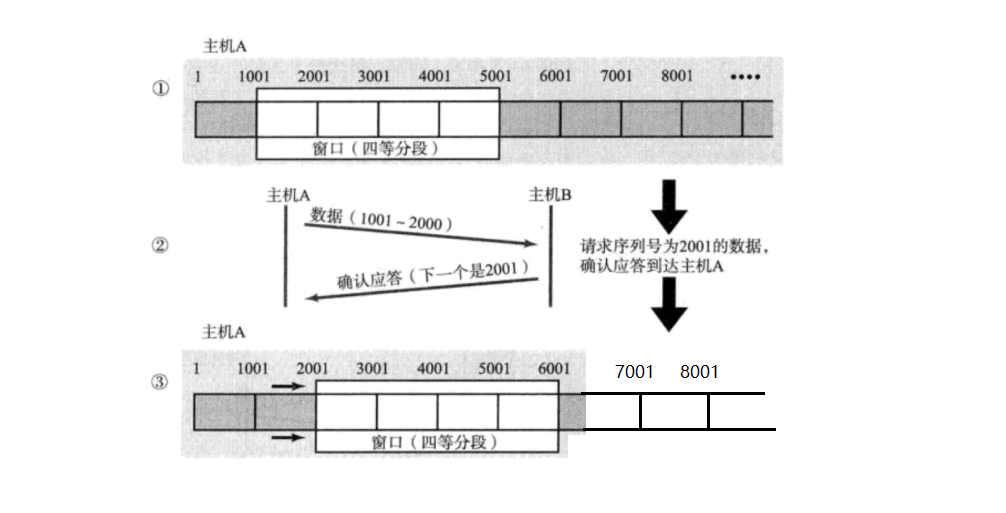
窗口:不等待ACK的情况下,批量发送的最大数据量,就叫“窗口大小”
滑动:形象的比喻,窗口的范围就是表示当前哪些数据在等待ACK,随着一个ACK到达,就立刻发送下一个数据,等待的数据包范围就在逐渐滑动
窗口的大小不变,当发送方收到2001的ACK,就意味着1001-2000的数据对方已经收到,此时立刻传输5001-6001的数据,此时等待的ACK数据包序号就是2001、3001、4001、5001.
ACK丢了
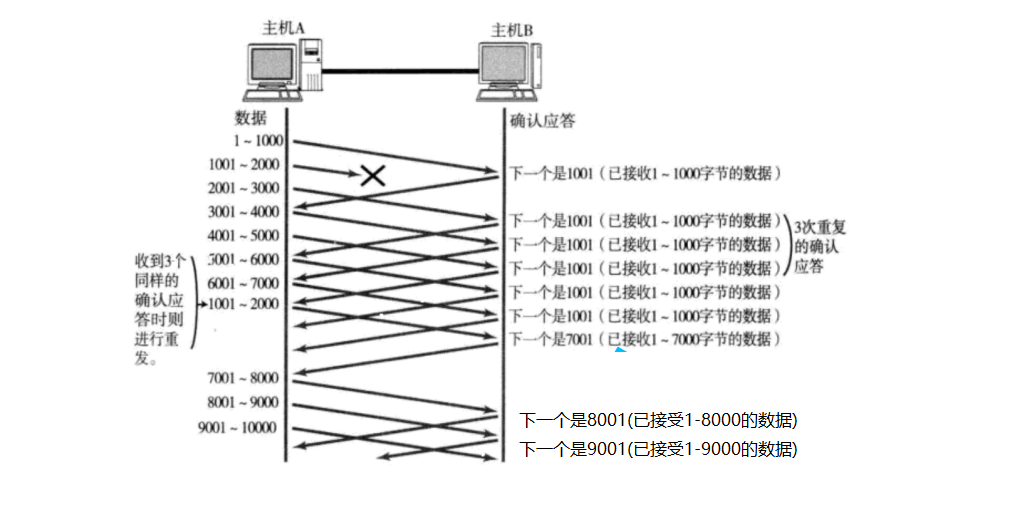
1001这个ACK丢了,2001这个ACK没丢,就认为1-1000这个数据也是顺利到达的,1001丢了就丢了,无所谓,2001能够包含1001ACK中的信息。
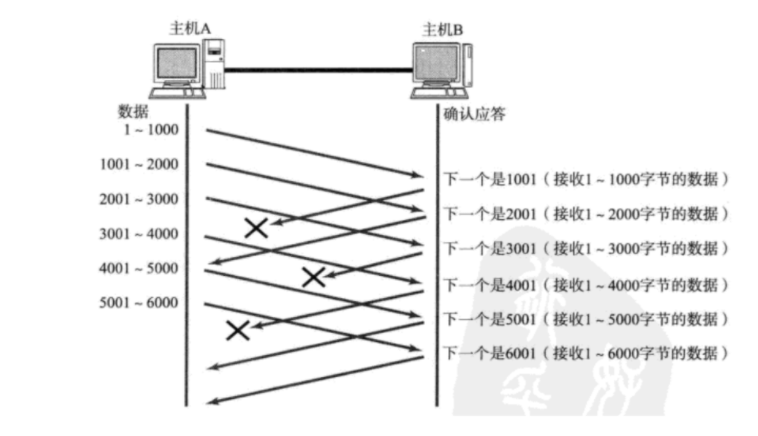
数据包就直接丢了
如果数据报丢了,例如1001-2000丢了,然后2001-3000,3001-4000等后面的这几个数据都顺利到达,此时主机B反馈的ACK的确认的序号始终是1001,如果主机A发现连续几个ACK都是1001,主机A就知道1001这个数据报丢失,就会重传1001
当主机B收到1001这个数据的时候,由于刚才到达2001-7000这些数据前面都已经收到了,接下俩ACK就从7001开始,重传只是重传丢失的数据,其他数据不需要额外重传
5,流量控制
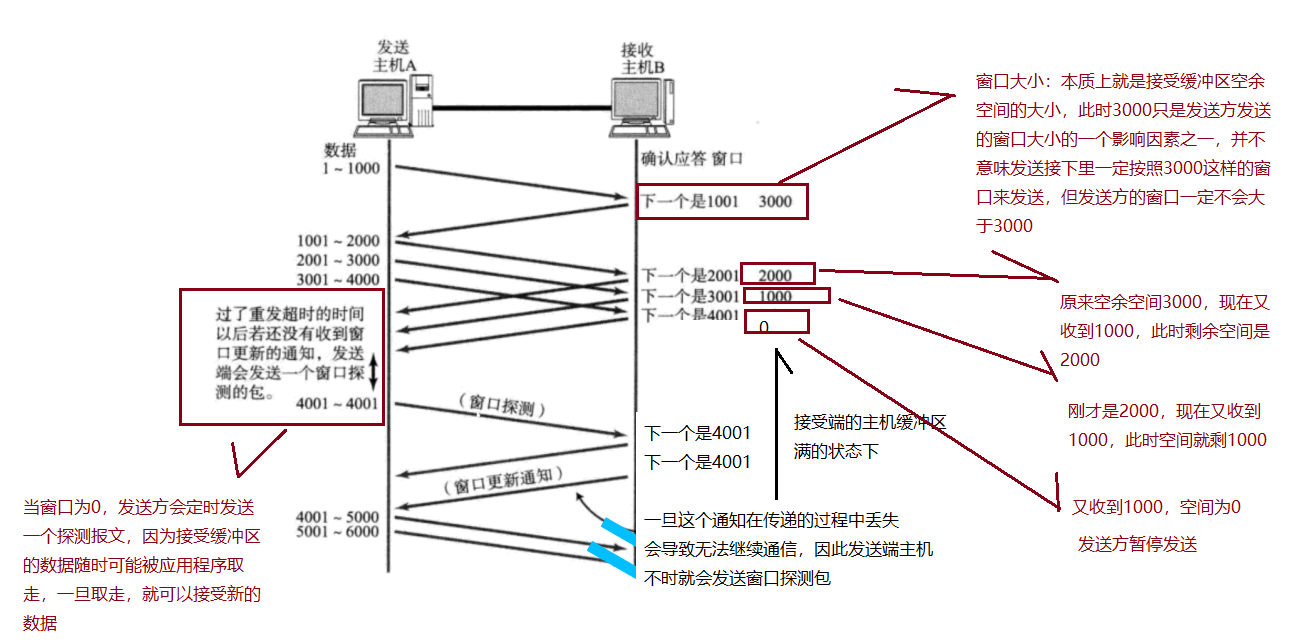
接收端处理数据的速度是有限的。如果发送端发的太快,导致接收端的缓冲区被打满,这个时候如果发送端继续发送,就会造成丢包,继而引起丢包重传等等一系列连锁反应。 因此TCP支持根据接收端的处理能力,来决定发送端的发送速度。这个机制就叫做流量控制(Flow Control);
接收端将自己可以接收的缓冲区大小放入 TCP 首部中的 “窗口大小” 字段,通过ACK端通知 发送端;
窗口大小字段越大,说明网络的吞吐量越高;
接收端一旦发现自己的缓冲区快满了,就会将窗口大小设置成一个更小的值通知给发送端;
发送端接受到这个窗口之后,就会减慢自己的发送速度;
如果接收端缓冲区满了,就会将窗口置为0;这时发送方不再发送数据,但是需要定期发送 一个窗口探测数据段,使接收端把窗口大小告诉发送端。
流量控制本质上,是根据接受方的处理能力来制约发送方的发送效率
根据接受缓冲区的剩余空间大小,来制约发送方的滑动窗口
通过TCP报头中的“窗口大小字段”来反映给发送方
6,拥塞控制
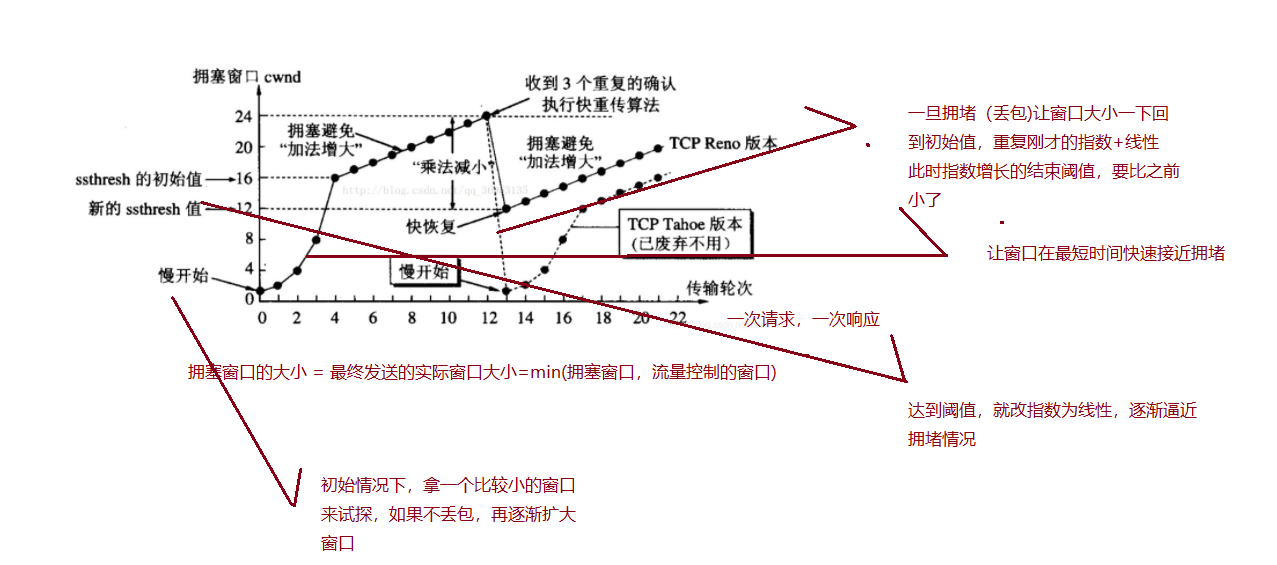
虽然TCP有了滑动窗口这个大杀器,能够高效可靠的发送大量的数据。但是如果在刚开始阶段就发送大 量的数据,仍然可能引发问题。 因为网络上有很多的计算机,可能当前的网络状态就已经比较拥堵。在不清楚当前网络状态下,贸然发送大量的数据,是很有可能引起雪上加霜的。 TCP引入 慢启动机制,先发少量的数据,探探路,摸清当前的网络拥堵状态,再决定按照多大的速度传 输数据;
拥塞控制由于不好衡量传输路径的拥堵情况,只能通过反复试探的方式,逐渐试探出应该要用多大的窗口
1,通过一个较小的窗口大小开始试探
2,如果没有发生拥堵(没有丢包)就指数方式扩大拥塞窗口
3,达到一定阈值后,线性增加窗口大小
4,一直到出现丢包,窗口回到初始值,调整阈值为出现丢包的窗口大小的一半
7,延迟应答
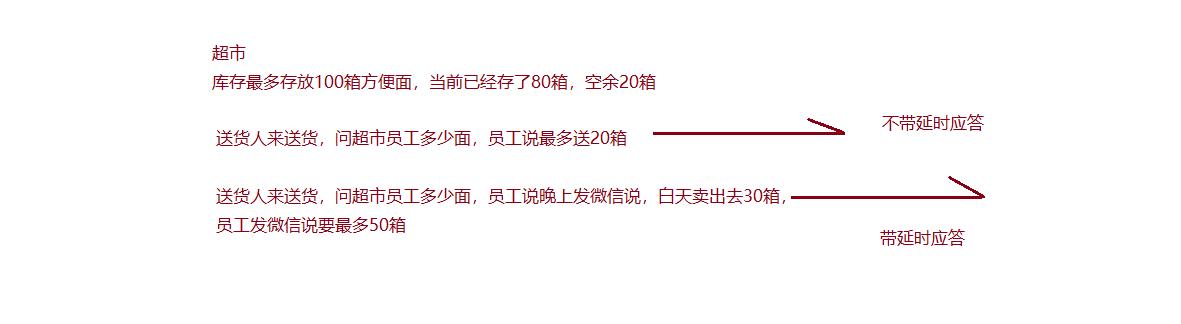
如果接收数据的主机立刻返回ACK应答,这时候返回的窗口可能比较小。
假设接收端缓冲区为1M。一次收到了500K的数据;如果立刻应答,返回的窗口就是500K;
但实际上可能处理端处理的速度很快,10ms之内就把500K数据从缓冲区消费掉了;
在这种情况下,接收端处理还远没有达到自己的极限,即使窗口再放大一些,也能处理过来;
如果接收端稍微等一会再应答,比如等待200ms再应答,那么这个时候返回的窗口大小就是 1M;
窗口越大,网络吞吐量就越大,传输效率就越高。我们的目标是在保证网络不拥塞的情况 下尽量提高传输效率;
8,捎带应答
在延时应答的基础上,进一步提高程序运行效率而引入的机制
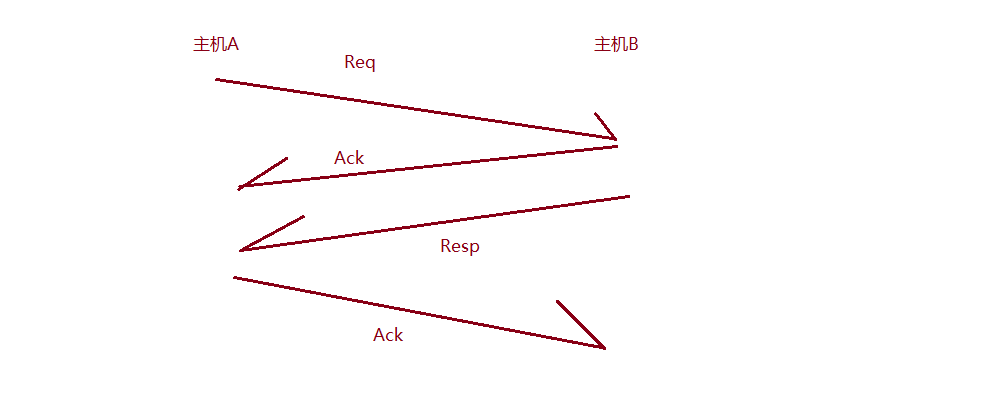
客户端和服务器之间的通信模式一般都是Requet-Response模式,“一问一答”
主机B要给主机A返回两个数据,严格的说,这两个数据的传输时机是不一样的
Req发送内核收到数据,就会立刻返回ACK,Resp返回应用程序代码,执行完Resp把响应写回客户端,才发送的响应
由于存在延时应答,ACK的传输时机有延时,延时的时间足够让英语程序完成响应计算,应用程序
返回Resp的时候发现刚才的ACK还没发,就在Resp的基础上,顺便捎带一个ACK的值
9,粘包问题
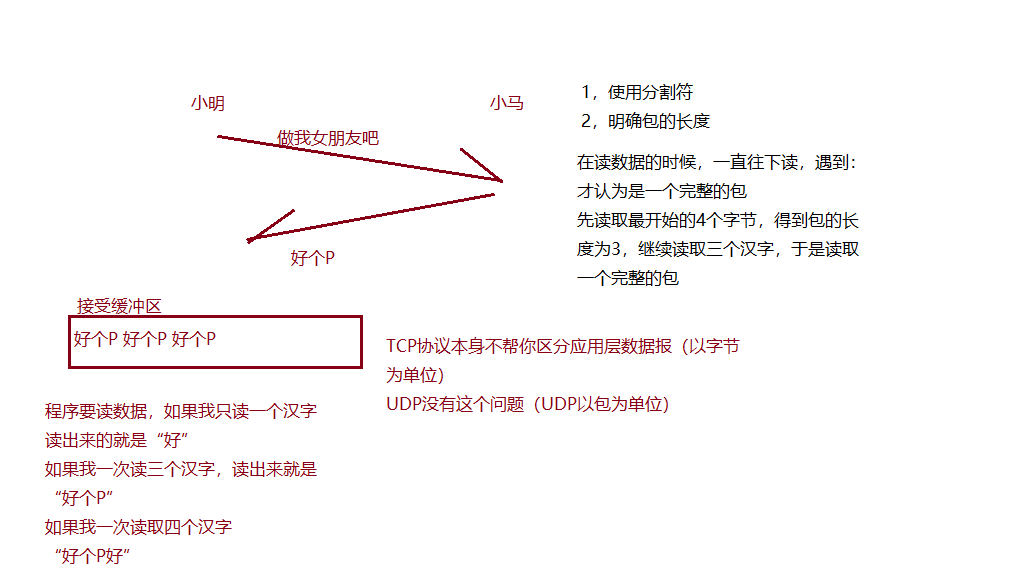
首先要明确,粘包问题中的 “包” ,是指的应用层的数据包。 在TCP的协议头中,没有如同UDP一样的 “报文长度” 这样的字段,但是有一个序号这样的字 段。 站在传输层的角度,TCP是一个一个报文过来的。按照序号排好序放在缓冲区中。 站在应用层的角度,看到的只是一串连续的字节数据。 那么应用程序看到了这么一连串的字节数据,就不知道从哪个部分开始到哪个部分,是一个 完整的应用层数据包。
那么如何避免粘包问题呢?归根结底就是一句话,明确两个包之间的边界。
对于定长的包,保证每次都按固定大小读取即可;例如上面的Request结构,是固定大小 的,那么就从缓冲区从头开始按sizeof(Request)依次读取即可; 对于变长的包,可以在包头的位置,约定一个包总长度的字段,从而就知道了包的结束位 置; 对于变长的包,还可以在包和包之间使用明确的分隔符(应用层协议,是程序猿自己来定 的,只要保证分隔符不和正文冲突即可)
发布者:全栈程序员-站长,转载请注明出处:https://javaforall.net/188526.html原文链接:https://javaforall.net



