
《mixup:BEYOND EMPIRICAL RISK MINIMIZATION》
- 2017(ICLR2018),Hongyi Zhang et al. Mixup ,MIT和FAIR
Q: 为什么data augmentation是理解为控制模型复杂度?
A: 准确地说,我觉得data augmentation既不能简单地理解为增加training data,也不能简单地理解为控制模型复杂度,而是两种效果兼而有之。考虑图像识别里常用的改变aspect ratio做data augmentation的方法,生成的图像虽然和真实图像相似,但是并不是来自于data distribution,更不是它的i.i.d.抽样。而经典的supervised learning以及统计学习理论的基本假设就是训练集和测试集都是data distribution的i.i.d.抽样,所以这并不是经典意义上的增加training data。这些合成的training data的作用,流行的解释是“增强模型对某种变换的invariance”。这句话反过来说,就是机器学习里经常提到的“减少模型估计的variance”,也就是控制了模型的复杂度。需要注意的是,L2正则化、dropout等等也都是在控制模型复杂度,只不过它们没有考虑数据本身的分布,而data augmentation属于更加机智的控制模型复杂度的方法。
其实反过来看,L2正则化和dropout也各自等价于某种data augmentation。参考Vicinal Risk Minimization 和 [1506.08700] Dropout as data augmentation
Q: label线性加权后,不是得到了这两个样本中间的类别了吗?
A: label用的是one-hot vector编码,可以理解为对k个类别的每个类给出样本属于该类的概率。加权以后就变成了”two-hot”,也就是认为样本同时属于混合前的两个类别。
另一种视角是不混合label,而是用加权的输入在两个label上分别计算cross-entropy loss,最后把两个loss加权作为最终的loss。由于cross-entropy loss的性质,这种做法和把label线性加权是等价的,大家可以自行思考一下。
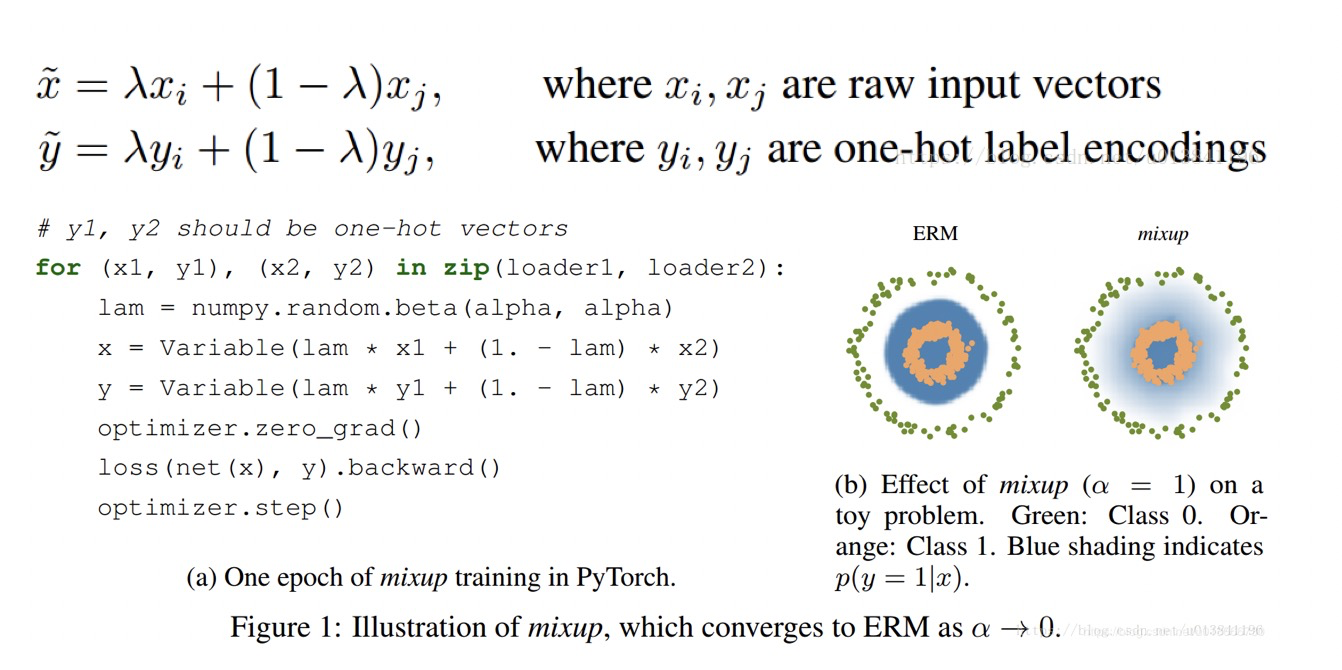

import numpy as np
import torch

def mixup_data(x, y, alpha=1.0, use_cuda=True):

    '''Compute the mixup data. Return mixed inputs, pairs of targets, and lambda'''
    if alpha > 0.:
        lam = np.random.beta(alpha, alpha)
    else:
        lam = 1.
    batch_size = x.size()[0]
    if use_cuda:
        index = torch.randperm(batch_size).cuda()
    else:
        index = torch.randperm(batch_size)

    mixed_x = lam * x + (1 - lam) * x[index,:] # 自己和打乱的自己进行叠加
    y_a, y_b = y, y[index]
    return mixed_x, y_a, y_b, lam

def mixup_criterion(y_a, y_b, lam):
    return lambda criterion, pred: lam * criterion(pred, y_a) + (1 - lam) * criterion(pred, y_b)
cutout:随机裁剪区域,填充0像素
cutmix:随机裁剪区域,填充其他图像到相应区域,代码可根据mixup来改写
发布者:全栈程序员-站长,转载请注明出处:https://javaforall.net/190027.html原文链接:https://javaforall.net



