
大家好,又见面了,我是你们的朋友全栈君。如果您正在找激活码,请点击查看最新教程,关注关注公众号 “全栈程序员社区” 获取激活教程,可能之前旧版本教程已经失效.最新Idea2022.1教程亲测有效,一键激活。
Jetbrains全系列IDE使用 1年只要46元 售后保障 童叟无欺
如何使用爬虫与JieBa库制作词云
所需库的安装
所需第三方库为如下:
import requests
from bs4 import BeautifulSoup
from wordcloud import WordCloud
import matplotlib.pyplot as plt
import jieba
import numpy as np
from PIL import Image
此网址内含大量python第三方库下载安装即可:
链接: https://www.lfd.uci.edu/~gohlke/pythonlibs/#pandas.
第三方库安装教程见博客:
利用爬虫爬取目标
利用第三方库requests库,requests是一个常用的用于http请求的模块
#获取http请求
def getHTMLText(url):
    try:
        r = requests.get(url, timeout=30) #获取html模块 timeout一般默认为30
        r.raise_for_status() #捕捉异常
        #r.encoding = 'utf-8'
        return r.text #http响应内容的字符串形式,即返回的页面内容
    except:
        return ""
requests 方法详解:
| 方法 | 属性 |
|---|---|
| requests.get() | 获取html的主要方法 |
| requests.raise_for_status | 捕捉异常如:网络连接错误,重定向错误等 |
| requests.text | http响应内容的字符串形式,即返回的页面内容 |
| r.encoding | 从http header 中猜测的相应内容编码方式 |
#爬取网页内容:
#url为目标网址
def getContent1(url):
    html = getHTMLText(url)
    # print(html)
    soup = BeautifulSoup(html, "html.parser")
    title = soup.select("div.LEFT > h1") #获取标题
    print(title[0].get_text())
    paras = soup.select("div.content-article > p.one-p") #获取内容
    #将爬取到内容存入打印
    for para in paras:
        if len(para) > 0:
            print(para.get_text())
            print()
      #将内容写入文件txt格式以用来制作词云
    fo = open("text.txt", "w+",newline='', encoding='utf-8')
    fo.writelines(title[0].get_text() + "\n")
    for para in paras:
        if len(para) > 0:
            fo.writelines(para.get_text() + "\n")
    fo.close()
    article = {

        'Title': title[0].get_text(),
        'Paragraph': paras,
    }
    print(article)
BeautifulSoup方法详解:
| 方法 | 说明 |
|---|---|
| BeautifulSoup(html, “html.parser”) | Python的内置标准库、执行速度适中 、文档容错能力强 |
| BeautifulSoup(markup, “lxml”) | 速度快、文档容错能力强 |
| BeautifulSoup(markup, “xml”) | 速度快、唯一支持XML的解析器 |
| soup.select() | 通过标签名查找内容 |
html标签名查看
以腾讯新闻为例:

 打开目标新闻界面按F12查看html源码
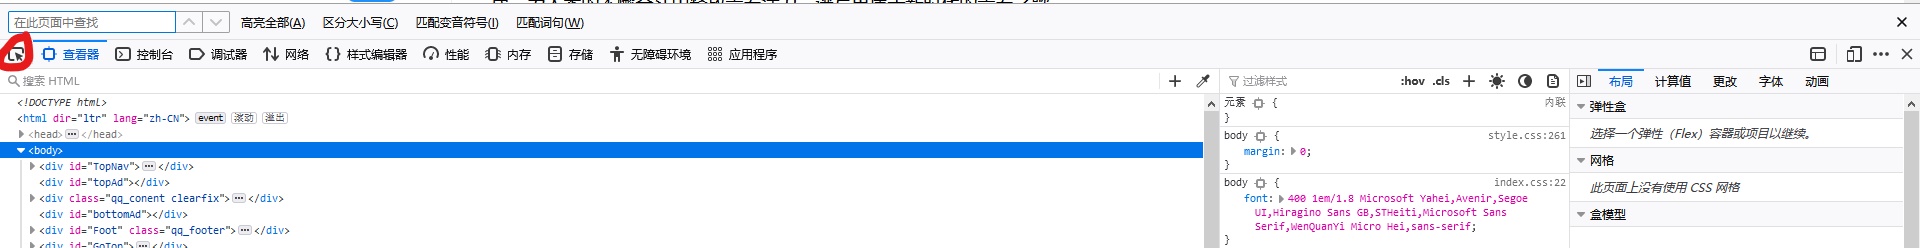 点击左上角红色箭头选取想要查看内容点击
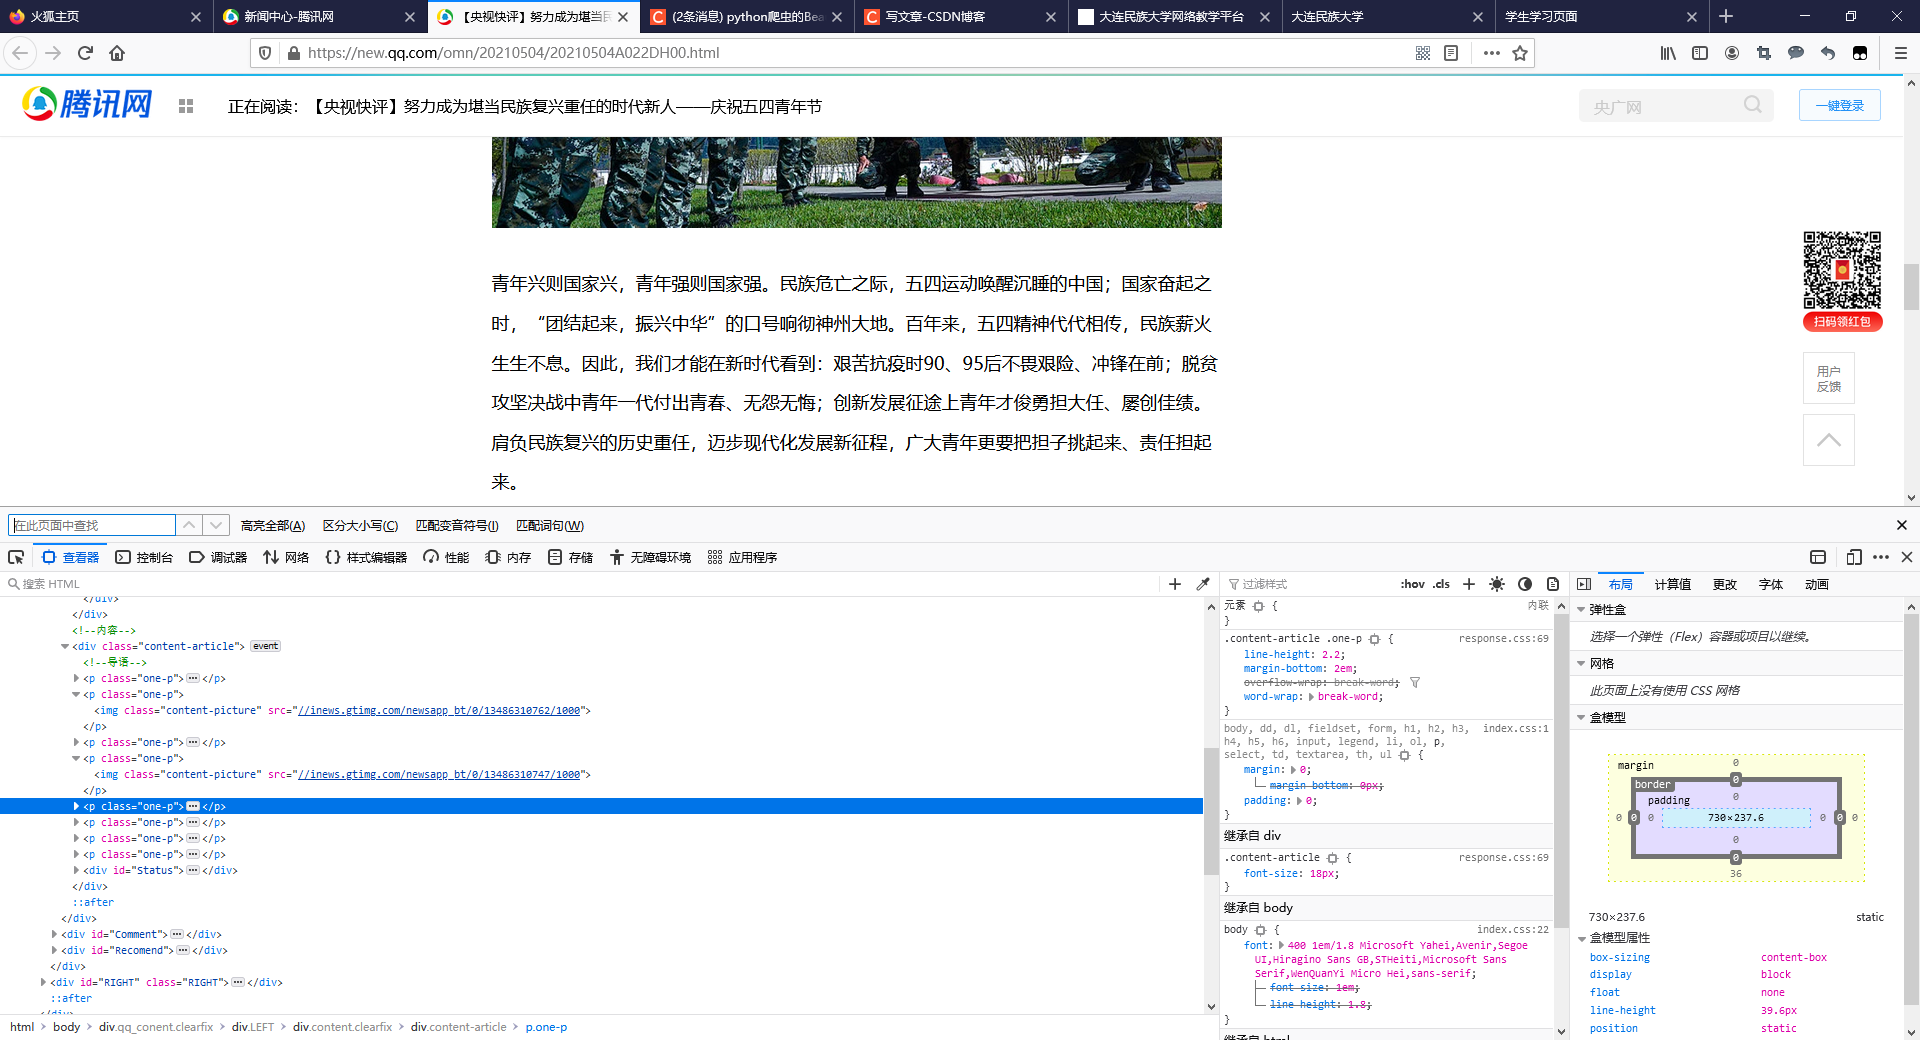 注意最底下一行会显示目标标签
注:
fo = open(“text.txt”, “w+”,newline=’’, encoding=‘utf-8’) 获取爬取到的内容写入文件时 打开文件时将encoding参数设置为utf-8防止写出格式错误形成乱码
利用JieBa库制作词云
#打开文件进行文本处理
def read_deal_text():
    with open("text.txt","r",newline='', encoding='utf-8') as f:
        txt=f.read()
    re_move=[",","。","",'\n','\xa0'] #去除文本中所有标点符号和空格
    for i in re_move:
        txt=txt.replace(i,"")
    word=jieba.lcut(txt) #选择分词模式
    #将处理好的文本写入txt文本
    with open("txt_save.txt",'w',newline='', encoding='utf-8')as file:
        for i in word:
            file.write(str(i)+'')
    print("文本处理完成并保存")
#利用WordCloud库制作词云
def img_grearte():
    with open("txt_save.txt","r",newline='', encoding='utf-8')as file:
        txt=file.read()
    mask = np.array(Image.open("background.jpg")) #将目标背景图传入
    word = WordCloud(background_color="white",width=400,height=400,max_words=110, max_font_size=80, mask=mask,contour_color='steelblue', font_path="simhei.ttf"
                          ).generate(txt) #设置词云数量,字体,以及词量等
    word.to_file('test.png') #将写好的词云存入
    print("词云图片以保存")
    plt.imshow(word)
    plt.axis("off")
    plt.show()
Jieba库使用方法
| 方法 | 属性 |
|---|---|
| jieba.cut () | 方法接受三个输入参数: 需要分词的字符串;cut_all 参数用来控制是否采用全模式;HMM 参数用来控制是否使用 HMM 模型 |
| jieba.lcut | 返回list |
| jieba.Tokenizer(dictionary=DEFAULT_DICT) | 新建自定义分词器 |
WordCloud库使用方法
| 方法 | 说明 |
|---|---|
| wordcloud.to_file(filename) | 将词云输出为图像文件 |
| wordcloud.generate() | 向WordCloud对象中加载文本txt |
| wordcloud.WordCloud() | 配置对象参数 |
wordcloud参数设置
| 参数 | 描述 |
|---|---|
| width | 指定词云对象生成图片的宽度,默认400像素 |
| height | 指定词云对象生成图片的高度,默认200像素 |
| min_font_size | 指定词云中字体的最小字号,默认4号 |
| max_font_size | 指定词云中字体的最大字号,根据高度自动调节 |
| font_step | 指定词云中字体字号的步进间隔,默认为1 |
| font_path | 指定文体文件的路径,默认None |
| max_words | 指定词云显示的最大单词数量,默认200 |
| stop_words | 指定词云的排除词列表,即不显示的单词列表 |
| mask | 指定词云形状,默认为长方形,需要引用imread()函数 |
完整代码
import requests
from bs4 import BeautifulSoup
from wordcloud import WordCloud
import matplotlib.pyplot as plt
import jieba
import numpy as np
from PIL import Image

def getHTMLText(url):
    try:
        r = requests.get(url, timeout=30)
        r.raise_for_status()
        #r.encoding = 'utf-8'
        return r.text
    except:
        return ""

def getContent1(url):
    html = getHTMLText(url)
    # print(html)
    soup = BeautifulSoup(html, "html.parser")
    title = soup.select("div.LEFT > h1")
    print(title[0].get_text())
    paras = soup.select("div.content-article > p.one-p")
    for para in paras:
        if len(para) > 0:
            print(para.get_text())
            print()
    fo = open("text.txt", "w+",newline='', encoding='utf-8')
    fo.writelines(title[0].get_text() + "\n")
    for para in paras:
        if len(para) > 0:
            fo.writelines(para.get_text() + "\n")
    fo.close()
    article = {

        'Title': title[0].get_text(),
        'Paragraph': paras,
    }
    print(article)


def getContent2(url):
    html = getHTMLText(url)
    # print(html)
    soup = BeautifulSoup(html, "html.parser")
    title = soup.select("path1")
    print(title[0].get_text())
    paras = soup.select("div.content-article > p.one-p")
    for para in paras:
        if len(para) > 0:
            print(para.get_text())
            print()
    fo = open("text.txt", "w+",newline='', encoding='utf-8')
    fo.writelines(title[0].get_text() + "\n")
    for para in paras:
        if len(para) > 0:
            fo.writelines(para.get_text() + "\n")
    fo.close()
    article = {

        'Title': title[0].get_text(),
        'Paragraph': paras,
    }
    print(article)

def read_deal_text():
    with open("text.txt","r",newline='', encoding='utf-8') as f:
        txt=f.read()
    re_move=[",","。","",'\n','\xa0']
    for i in re_move:
        txt=txt.replace(i,"")
    word=jieba.lcut(txt)
    with open("txt_save.txt",'w',newline='', encoding='utf-8')as file:
        for i in word:
            file.write(str(i)+'')
    print("文本处理完成并保存")

def img_grearte():
    with open("txt_save.txt","r",newline='', encoding='utf-8')as file:
        txt=file.read()
    mask = np.array(Image.open("background.jpg"))
    word = WordCloud(background_color="white",width=400,height=400,max_words=110, max_font_size=80, mask=mask,contour_color='steelblue', font_path="simhei.ttf"
                          ).generate(txt)
    word.to_file('test.png')
    print("词云图片以保存")
    plt.imshow(word)
    plt.axis("off")
    plt.show()

def main():
    url1 = "https://new.qq.com/omn/20210222/20210222A0149000.html"
    getContent1(url1)
    read_deal_text()
    img_grearte()

main()
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容, 请发送邮件至 举报,一经查实,本站将立刻删除。
发布者:全栈程序员-站长,转载请注明出处:https://javaforall.net/193772.html原文链接:https://javaforall.net



