
大家好,又见面了,我是你们的朋友全栈君。如果您正在找激活码,请点击查看最新教程,关注关注公众号 “全栈程序员社区” 获取激活教程,可能之前旧版本教程已经失效.最新Idea2022.1教程亲测有效,一键激活。
Jetbrains全系列IDE使用 1年只要46元 售后保障 童叟无欺
咳咳直接上代码
#!/usr/bin/env python
# -*- coding: utf-8 -*-
# @Time : 2021/01/04 18:10
# @Author : 志伟
# @File : 图库大全1000.py
# @Software: PyCharm
import requests
from lxml import etree
import os

if __name__ == '__main__':
    headers = {

        'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/86.0.4240.183 Safari/537.36'
    }
    m_path = './1000图库'
    if not os.path.exists(m_path):
        os.mkdir(m_path)
    for i in range(1, 2):
        url = f'https://www.1000tuku.com/guoneimeinv/list_5_{i}.html'
        resp = requests.get(url=url, headers=headers).text
        tree = etree.HTML(resp)
        href_list = tree.xpath('/html/body/div[4]/ul//@href')
        for href in href_list:
            resp1 = requests.get(url=href, headers=headers)
            # 处理中文乱码问题
            resp1_text = resp1.text.encode('ISO-8859-1').decode('GB18030')
            tree1 = etree.HTML(resp1_text)
            page_num = int(tree1.xpath('//*[@id="content"]/div[1]/div[2]/ul/li[1]/a/text()')[0][1:3])
            title = tree1.xpath('/html/head/title/text()')[0]
            title_path = m_path + f'/{title}'
            if not os.path.exists(title_path):
                os.mkdir(title_path)
            for j in range(1, page_num + 1):
                if j == 1:
                    every_herf = href
                else:
                    every_herf = href.replace('.html', f'_{j}.html')
                resp2 = requests.get(url=every_herf, headers=headers).text
                tree2 = etree.HTML(resp2)
                src_list = tree2.xpath('//*[@id="content"]/div[1]/div[1]//@src')
                for src in src_list:
                    jpg_data = requests.get(url=src, headers=headers).content
                    jpg_name = src.split('/')[-1]
                    jpg_path = title_path + f'/{jpg_name}'
                    with open(jpg_path, 'wb') as fp:
                        fp.write(jpg_data)
                        print(jpg_name, '下载完成')
咳咳,看看效果
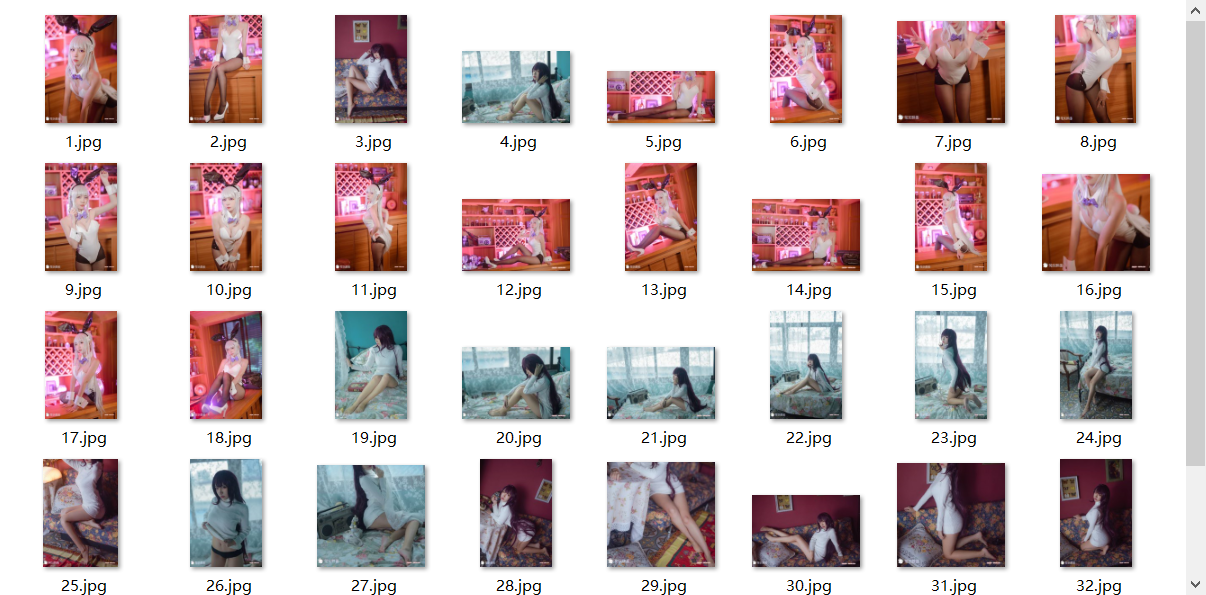

放学啦,回家吃饭去吧
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容, 请发送邮件至 举报,一经查实,本站将立刻删除。
发布者:全栈程序员-站长,转载请注明出处:https://javaforall.net/194038.html原文链接:https://javaforall.net



