
信用风险计量模型可以包括跟个人信用评级,企业信用评级和国家信用评级。人信用评级有一系列评级模型组成,常见是A卡(申请评分卡)、B卡(行为模型)、C卡(催收模型)和F卡(反欺诈模型)。 今天我们展示的是个人信用评级模型的开发过程,数据采用kaggle上知名的give me some credit数据集。
一、建模流程
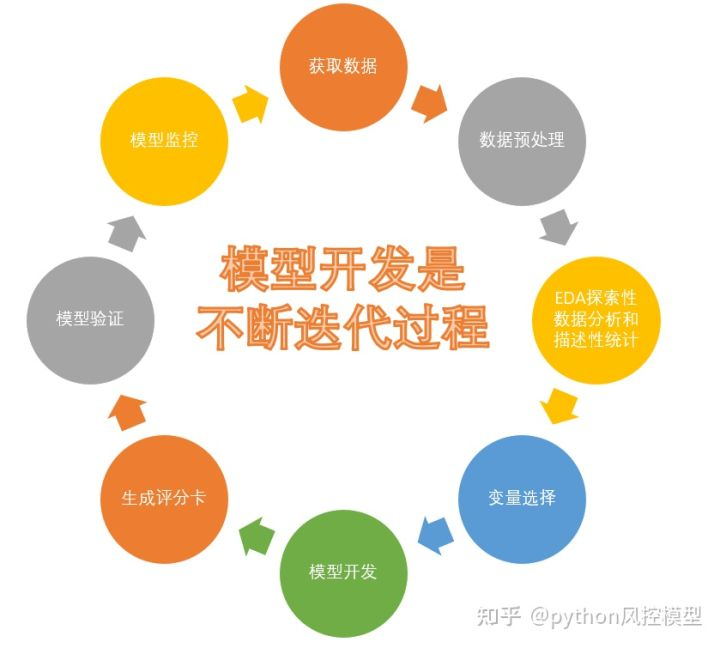
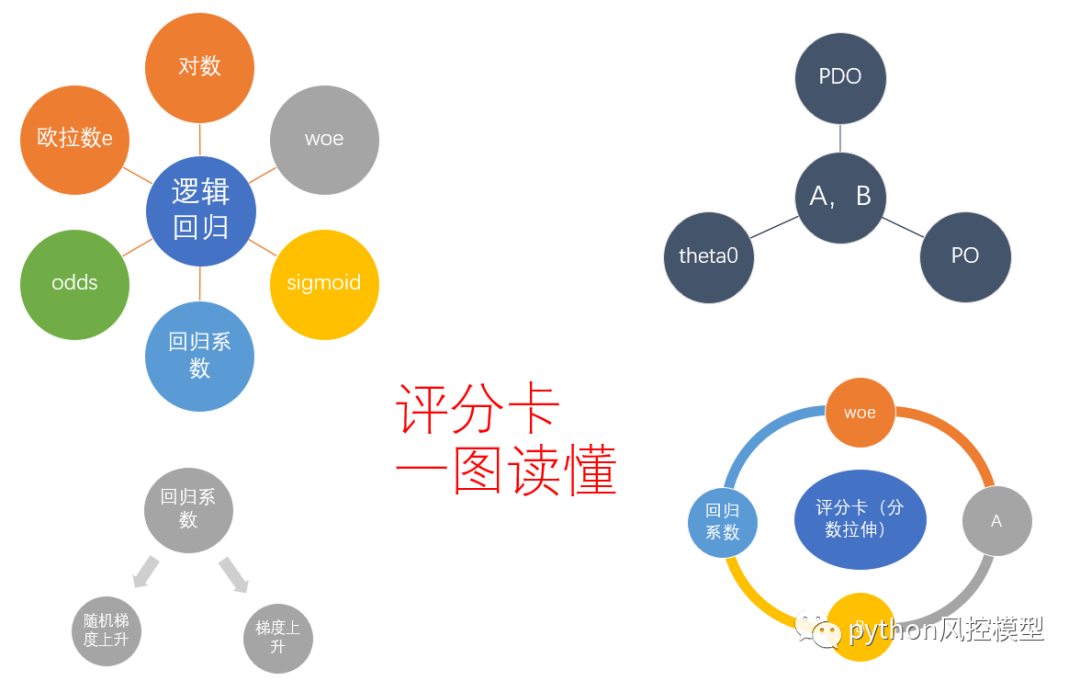
典型的信用评分卡模型如图1-1所示。信用风险评级模型的主要开发流程如下:
(1) 获取数据,包括申请贷款客户的数据。数据包括客户各个维度,包括年龄,性别,收入,职业,家人数量,住房情况,消费情况,债务等等。
(2) 数据预处理,主要工作包括数据清洗、缺失值处理、异常值处理、数据类型转换等等。我们需要把原始数据层层转化为可建模数据。
(3) EDA探索性数据分析和描述性统计,包括统计总体数据量大小,好坏客户占比,数据类型有哪些,变量缺失率,变量频率分析直方图可视化,箱形图可视化,变量相关性可视化等。
(4) 变量选择,通过统计学和机器学习的方法,筛选出对违约状态影响最显著的变量。常见变量选择方法很多,包括iv,feature importance,方差等等 。另外缺失率太高的变量也建议删除。无业务解释性变量且没有价值变量也建议删除。
(5) 模型开发,评分卡建模主要难点是woe分箱,分数拉伸,变量系数计算。其中woe分箱是评分卡中难点中难点,需要丰富统计学知识和业务经验。目前分箱算法多达50多种,没有统一金标准,一般是先机器自动分箱,然后再手动调整分箱,最后反复测试模型最后性能,择优选取最优分箱算法。
(6) 模型验证,核实模型的区分能力、预测能力、稳定性、排序能力等等,并形成模型评估报告,得出模型是否可以使用的结论。模型验证不是一次性完成,而是当建模后,模型上线前,模型上线后定期验证。模型开发和维护是一个循环周期,不是一次完成。
(7) 信用评分卡,根据逻辑回归的变量系数和WOE值来生成评分卡。评分卡方便业务解释,已使用几十年,非常稳定,深受金融行业喜爱。其方法就是将Logistic模型概率分转换为300-900分的标准评分的形式。
(8) 建立评分卡模型系统,根据信用评分卡方法,建立计算机自动信用化评分系统。美国传统产品FICO有类似功能,FICO底层语言是Java。目前流行Java,python或R多种语言构建评分卡自动化模型系统。
(9)模型监控,着时间推移,模型区分能力,例如ks,auc会逐步下降,模型稳定性也会发生偏移。我们需要专业模型监控团队,当监控到模型区分能力下降显著或模型稳定性发生较大偏移时,我们需要重新开发模型,迭代模型。模型监控团队应该每日按时邮件发送模型监控报表给相关团队,特别是开发团队和业务团队。

二. 获取数据
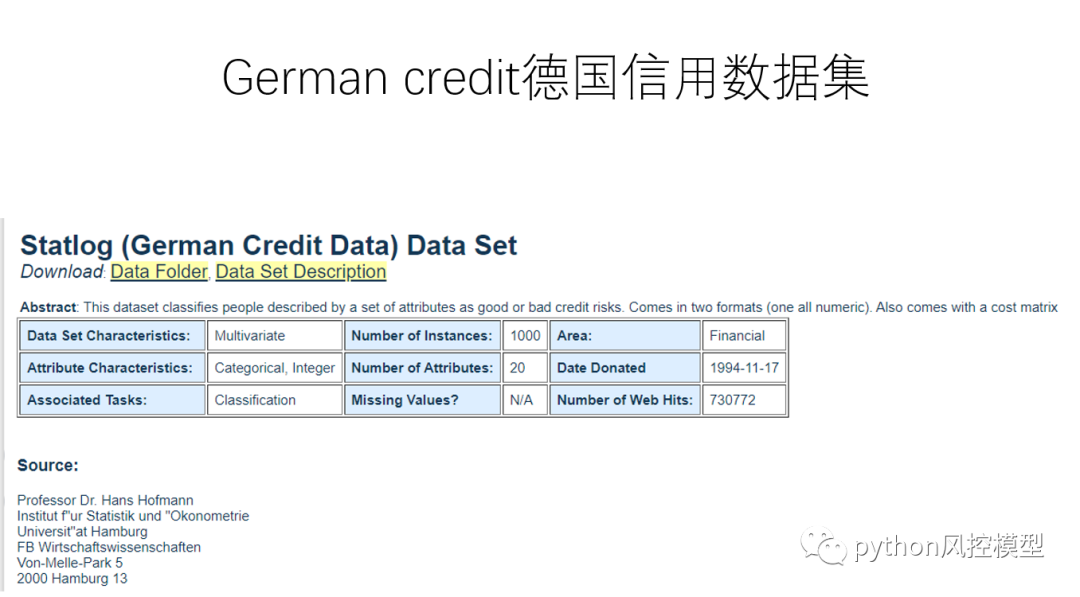
之前我讲过利用German credit德国信用数据集建立python信用评分卡模型,该数据集优势是数据量小,对计算机硬件要求不高,方便各个阶层学员学习和测试。
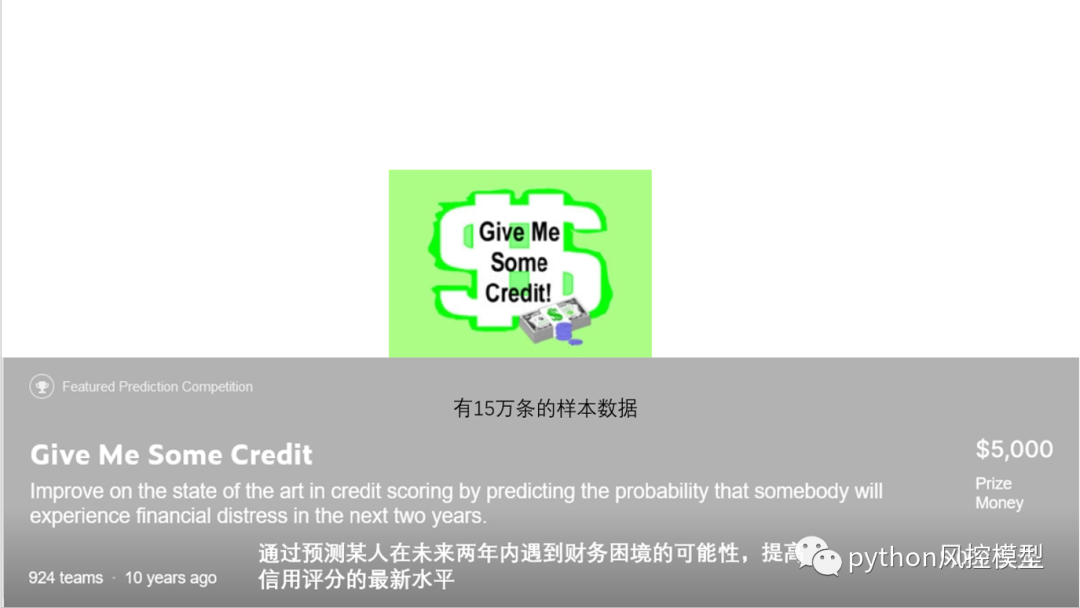
信用评分算法对违约概率进行猜测,是银行用来确定是否应授予贷款的方法。数据属于个人消费类贷款,通过预测某人在未来两年内遇到财务困境的可能性,提高信用评分的最新水平。
银行在市场经济中发挥着至关重要的作用。他们决定谁可以获得资金以及以什么条件获得资金,并且可以做出投资决策或终止投资决定。为了让市场和社会发挥作用,个人和公司需要获得信贷。
give me some credit有15万样本数据,该数据量解决中大型金融机构实战数据,更加接近金融企业项目实战。该数据集通过预测某人在未来两年内遇到财务困难的可能性,提高信用评分的水平。
变量中文释义,变量少而精,可作为建模的参考
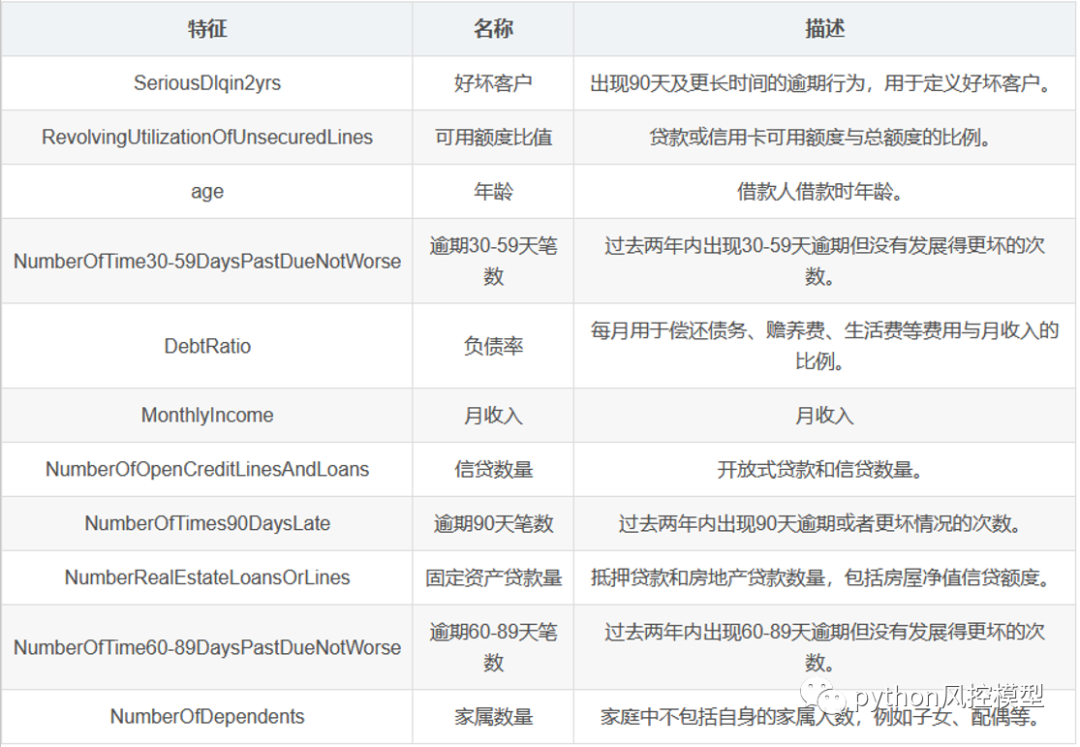
我们对上述变量归类,主要分为:
– 基本属性:包括了借款人当时的年龄。
– 偿债能力:包括了借款人的可用额度比值、月收入、负债比率。
– 信用历史:两年内35-59天逾期次数、两年内60-89天逾期次数、两年内90
天或高于90天逾期的次数。
– 财产状况:包括了开放式信贷和贷款数量、不动产贷款或额度数量。
– 其它因素:借款人的家属数量(不包括本人在内)
kaggle模型竞赛中,奖金5000美金,模型评估指标为AUC。
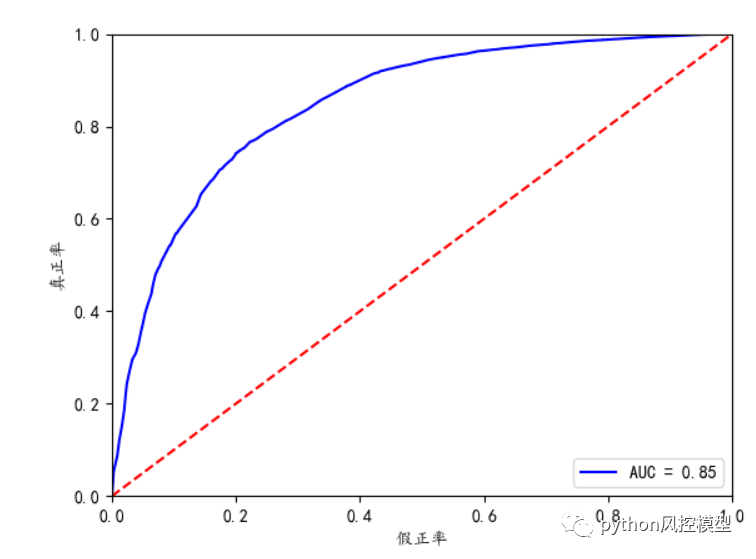
互联网上国内外关于give me some credit数据集AUC得分最佳表现为0.85.
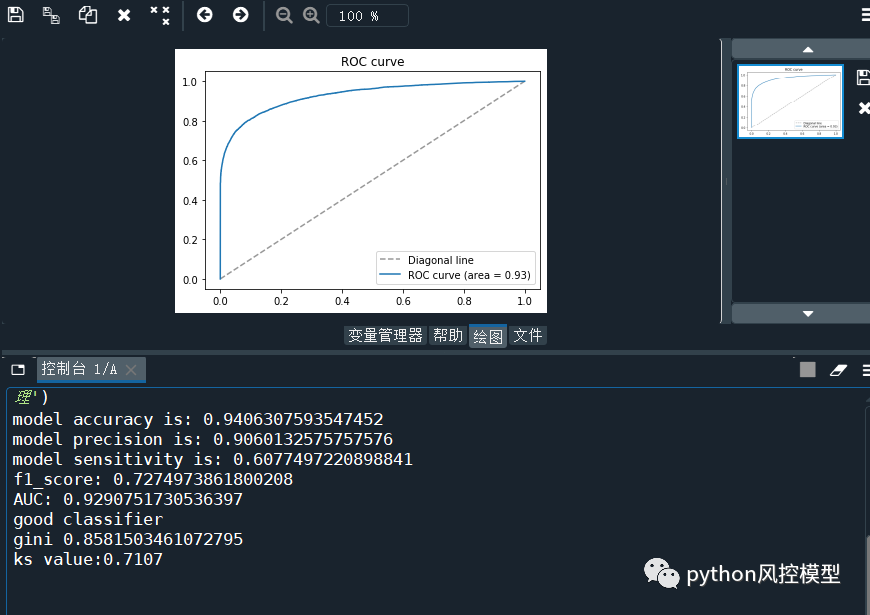
但我方《python信用评分卡建模(附代码)》教程中AUC可以达到0.929,调参后AUC可以更高,远高于互联网上give me some credit论文的模型性能AUC=0.85。互联网论文关于建模步骤有很多看似有理,但实际上不正确的理论。
如果你好奇我方如何将give me some credit数据集AUC达到0.929,可参考教程《python信用评分卡建模(附代码)》
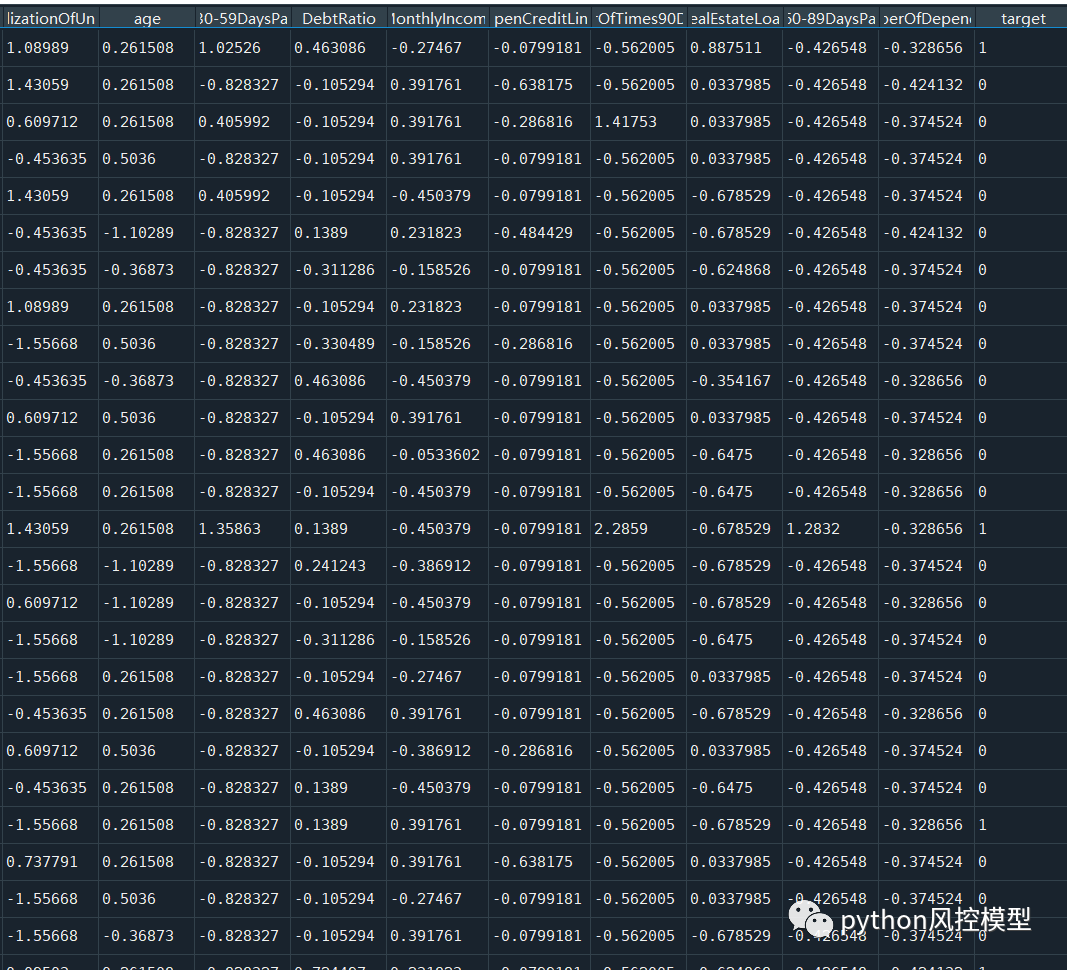
《python信用评分卡建模(附代码)》中give me some credit数据集一览。
三、数据预处理
数据预处理,主要工作包括数据清洗、缺失值处理、异常值处理、数据类型转换等等。我们需要把原始数据层层转化为可建模数据。
3.1 缺失值处理
give me some credit数据集缺失数据并不严重,只有两个变量有缺失值,缺失率为2%和19.8%。
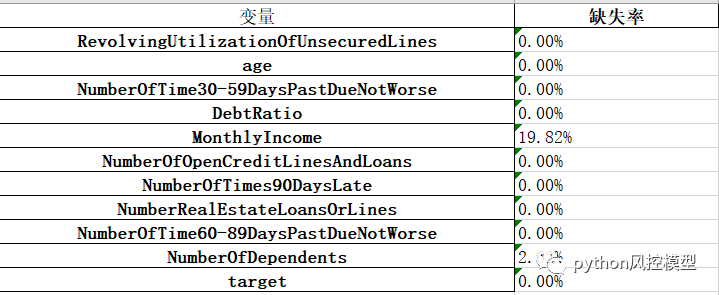
现实中数据存在大量缺失值是非常普遍。央行征信很多变量缺失率可以高达99%。缺失值会导致一些数据分析和建模的问题。通常在信用风险评分卡模型开发的第一步我们就要进行缺失值处理。缺失值处理的方法,包括如下几种。
(1) 直接删除含有缺失值的样本。
(2) 填补缺失值。
(3) 不予理睬。
3.2 异常值处理
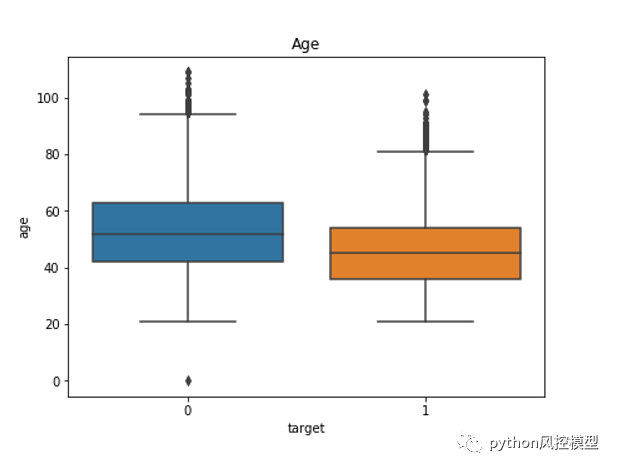
缺失值处理后,我们需要进行异常值检验。异常值分为统计学上异常值和业务上异常值。统计学异常值通常用箱型图来判断,如下图。
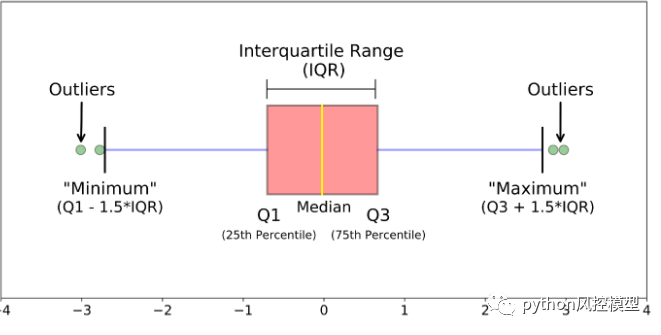
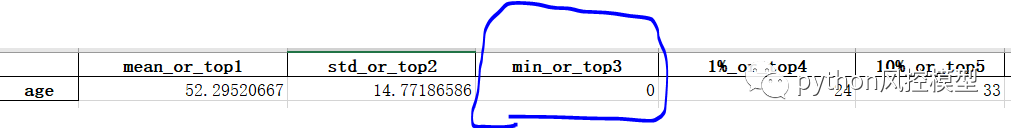
业务上异常值是根据业务线对变量定义和常识来判断该数据是否合理。比如give me some credit数据集中有个人客户的年龄为0,按照常理,我们认为该值为异常值。哪个贷款公司会把钱借给年龄为0的用户?
3.3 数据划分
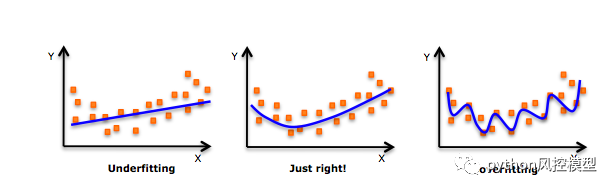
我们建立模型后一般会遇到下面三种情况,underfitting欠拟合,just right拟合合适,overfitting过度拟合。
为了验证模型的性能,我们需要对数据集进行划分。
首先把所有数据分成x数据和y数据(target目标变量)。
然后把x数据和y数据分成训练集和测试集,并生成四个变量train_x,test_x,train_y,test_y.
四、EDA探索性数据分析和描述性统计
由于人大脑的生理结构,大部分人对数字不敏感,但数据可视化对大脑理解更友好。这就是数据可视化重要性,也方便向领导或决策层汇报工作。
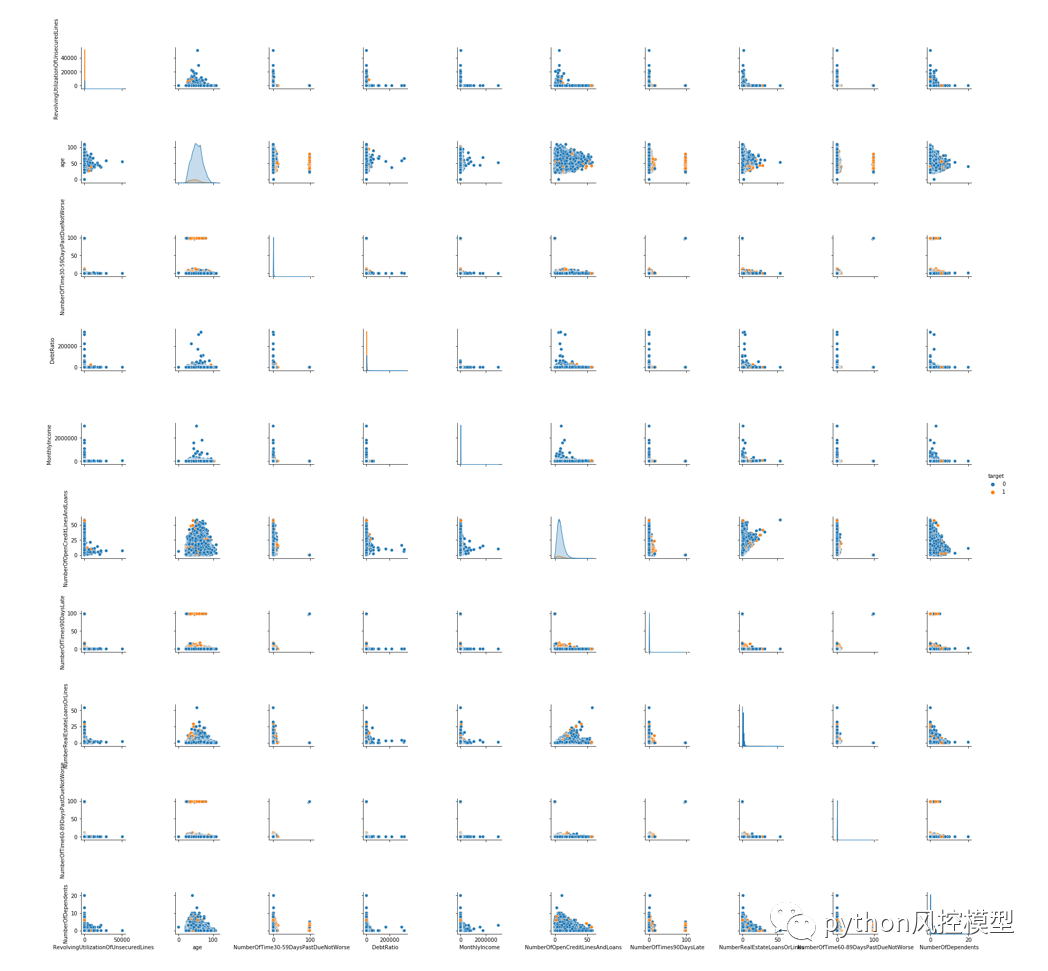
EDA探索性数据分析和描述性统计包括统计总体数据量大小,好坏客户占比,数据类型有哪些,变量缺失率,变量频率分析直方图可视化,箱形图可视化,变量相关性可视化等。EDA是Exploratory Data Analysis缩写,中文释义为探索性数据分析。探索性数据分析方法很多常见的有:hist直方图、scater散点图,boxer箱线图,heat热力图,pairplot配对图。
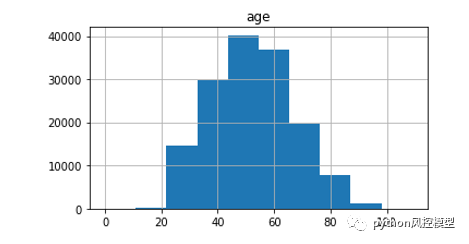
give me some credit数据集的age年龄变量直方图
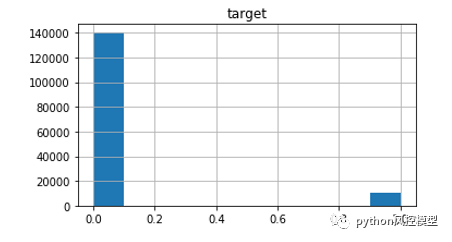
give me some credit数据集的target目标变量直方图,可以发现好坏客户占比非常不平衡。好客户数量大概是坏客户数量15倍左右。
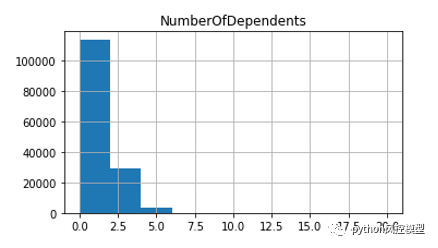
give me some credit数据集的家庭成员数量变量直方图
give me some credit数据集所有变量的pairplot配对图,大量信息一目了然。
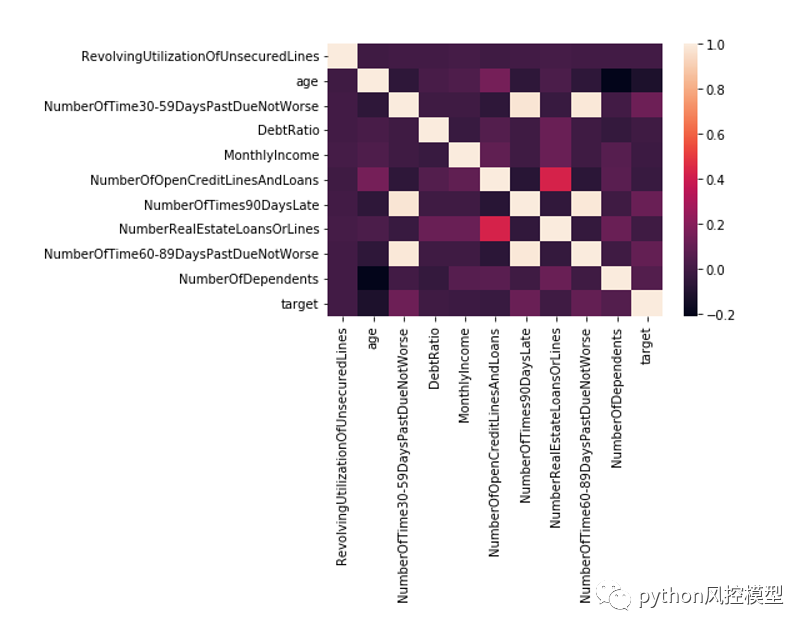
give me some credit数据集所有变量相关性的热力图,可以分析出有6对变量相关性非常高,变量筛选时候需要注意。
give me some credit数据集age年龄变量关于好坏客户的分类箱型图统计。我们可以看到好客户年龄中位数要高于坏客户年龄中位数。
五、变量选择
变量选择,通过统计学和机器学习的方法,筛选出对违约状态影响最显著的变量。常见变量选择方法很多,包括iv,feature importance,方差等等 。另外缺失率太高的变量也建议删除。无业务解释性变量且没有价值变量也建议删除。
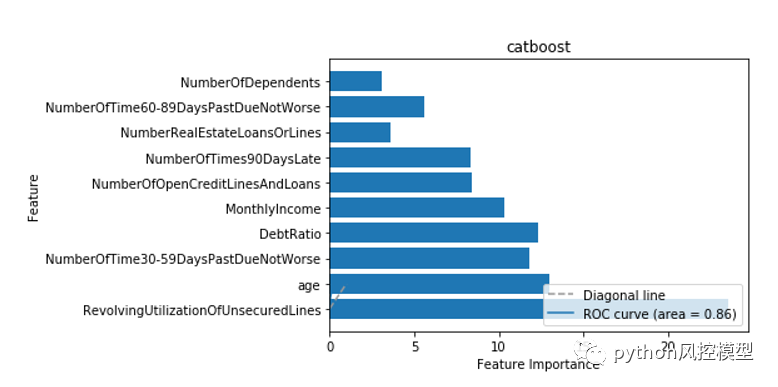
《python信用评分卡建模(附代码)》教程中集成树算法catboost的feature importance可视化图,我们可以明显看出RevolvingUtilizationOfUnsecuredLines可用额度比值变量的重要性最高。图中蓝色柱越长,重要性越大,反之亦然。
《python信用评分卡建模(附代码)》教程中变量iv值计算结果如下,我们清晰看到RevolvingUtilizationOfUnsecuredLines可用额度比值变量的iv最高。
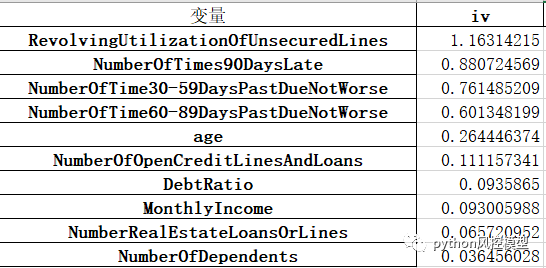
通过feature importance和iv值方法我们都得到同样结论:RevolvingUtilizationOfUnsecuredLines可用额度比值变量是最重要的。
六、模型开发
模型开发,评分卡建模主要难点是woe分箱,分数拉伸,变量系数计算。其中woe分箱是评分卡中难点中难点,需要丰富统计学知识和业务经验。目前分箱算法多达50多种,没有统一金标准,一般是先机器自动分箱,然后再手动调整分箱,最后反复测试模型最后性能,择优选取最优分箱算法。
《python信用评分卡建模(附代码)》讲解Kmeans,等频分箱、等距分箱,卡方分箱,决策树分箱算法原理和python实现分箱代码。《python信用评分卡建模(附代码)》还告诉你如何选择分箱方法?在不同需求下,选择最合适分箱方法。
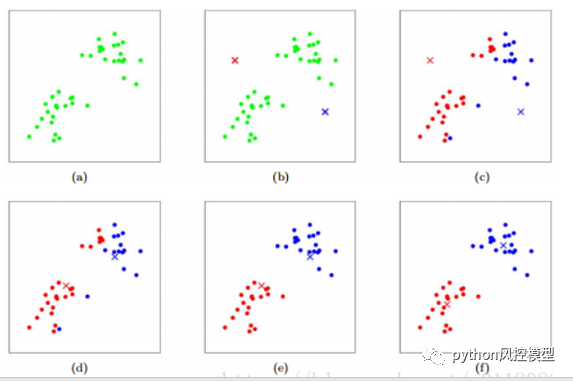
分箱主要分为有监督方法和无监督方法。k均值聚类算法(k-means clustering algorithm)是一种迭代求解的聚类分析算法,其步骤是,预将数据分为K组,则随机选取K个对象作为初始的聚类中心,然后计算每个对象与各个种子聚类中心之间的距离,把每个对象分配给距离它最近的聚类中心。聚类中心以及分配给它们的对象就代表一个聚类。每分配一个样本,聚类的聚类中心会根据聚类中现有的对象被重新计算。这个过程将不断重复直到满足某个终止条件。终止条件可以是没有(或最小数目)对象被重新分配给不同的聚类,没有(或最小数目)聚类中心再发生变化,误差平方和局部最小。下图是Kmeans分箱算法原理。
传说中的最优分箱就是决策树分箱。
决策树分箱算法步骤为:
步骤 1:首先,它使用我们想要离散化的变量来训练一个有限深度(2、3 或 4)的决策树来预测目标。
_第 2 步:_然后将原始变量值替换为树返回的概率。单个 bin 内的所有观测值的概率相同,因此用概率替换相当于将决策树决定的截止值内的观测值分组。
决策树分箱算法好处和缺点是:
好处 :
-
概率预测返回的决策树与目标单调相关。
-
新的 bin 显示出减少的熵,这是每个桶/桶内的观察结果与它们自己的相似度,而不是其他桶/桶的观察结果。
-
树会自动找到垃圾箱。
缺点:
-
可能会导致过拟合
-
更重要的是,可能需要对树参数进行一些调整以获得最佳分割(例如,深度、一个分区中的最小样本数、最大分区数和最小信息增益)。这可能很耗时。
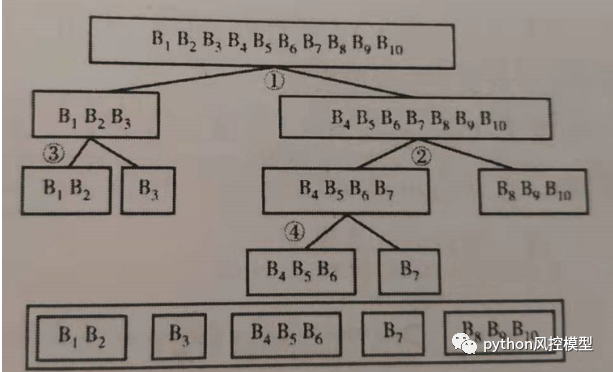
(决策树分箱可视化)
等距分箱可用于类似age年龄的变量。
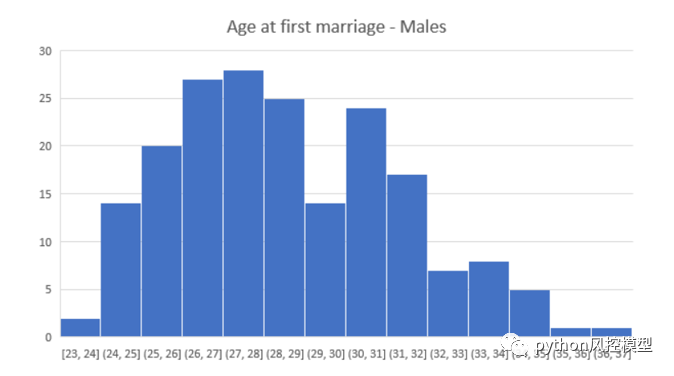
分箱完成后,就把分箱数据转换为woe数据,最后用逻辑回归算法建模。
七、模型验证
逻辑回归算法建模后,我们需要模型验证。模型验证是核实模型的区分能力、预测能力、稳定性、排序能力等指标是否合格,并形成模型评估报告,得出模型是否可以使用的结论。模型验证不是一次性完成,而是当建模后,模型上线前,模型上线后定期验证。模型开发和维护是一个循环周期,不是一次完成。
着时间推移,模型区分能力,例如ks,auc会逐步下降,模型稳定性也会发生偏移。当模型区分能力下降显著或模型稳定性发生较大偏移时,我们需要重新开发模型,迭代模型。
《python信用评分卡建模(附代码)》教程中训练模型AUC为0.929,具体模型性能如下:
model accuracy is: 0.9406307593547452
model precision is: 0.9060132575757576
model sensitivity is: 0.6077497220898841
f1_score: 0.7274973861800208
AUC: 0.9290751730536397
good classifier
gini 0.8581503461072795
ks value:0.7107
远超互联网give me some credit数据集建模论文的模型性能AUC 0.85。
八、评分卡诞生
===
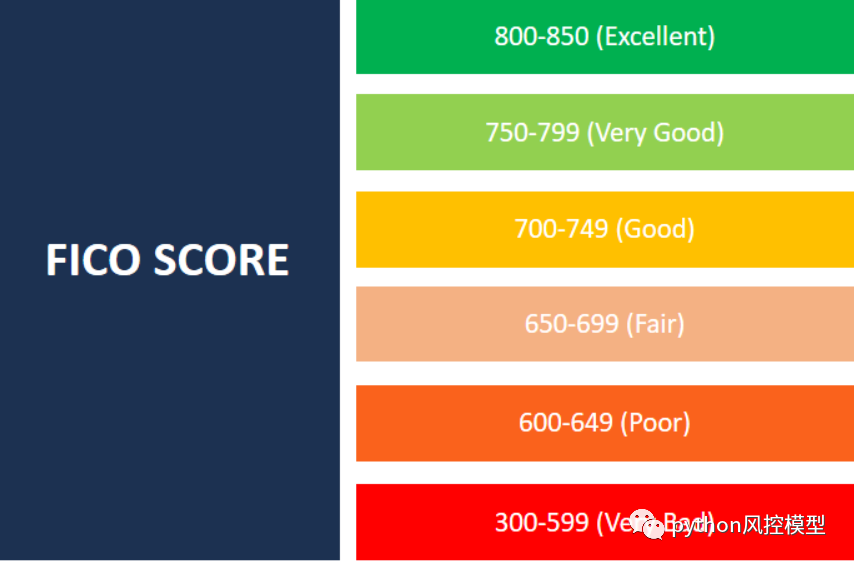
模型根据逻辑回归的变量系数和WOE值来生成评分卡。评分卡方便业务解释,已使用几十年,非常稳定,深受金融行业喜爱。其方法就是将Logistic模型概率分转换为300-900分的标准评分的形式。国内绝大多数信用评分卡都效仿的美国FICO分数。
FICO 分数为 800 或以上的个人具有特殊的信用记录。信用评分高的人很可能多年来拥有多项信用额度。他们没有超过任何信用额度,并及时还清了所有债务。
中高 700 分的 FICO 分数是不错的分数。得分在此范围内的个人明智地借贷和消费并及时付款。这些人,例如 800 岁以上的人,往往更容易获得信贷,并且通常支付的利率要低得多。
最常见的分数介于 650 和 750 之间。虽然分数在此范围内的个人信用相当好,但他们可能会延迟付款。这些人通常不会很难获得贷款。但是,他们可能需要支付略高的利率。
最后一个要考虑的实际范围是 599 或更低的分数。它们被认为信用评分不佳,通常是由于多次延迟付款、未能偿还债务或已转到收款机构的债务所致。拥有此类 FICO 分数的个人通常很难(如果不是不可能的话)获得任何形式的信用。
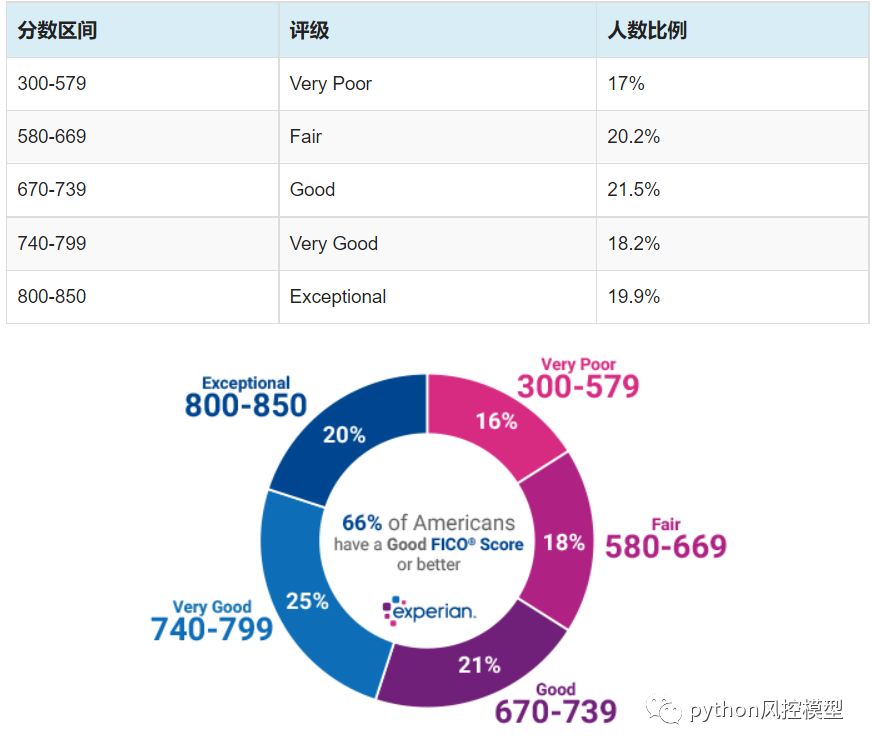
如下图, FICO信用分在very poor300-579分的占比最低,只有17%;good670-739分的占比最高,达到21.5%。
《python信用评分卡建模(附代码)》中评分卡生成有详细章节讲解,包括PDO,theta0,P0,A,B,odds,woe,iv等专业术语有完全解读。
九.评分卡自动评分系统
我们通过上面基础,可以生成自动化评分系统,对每个申请单用户生成好坏客户真实标签,好坏客户预测标签,坏客户概率值,拉伸评分。
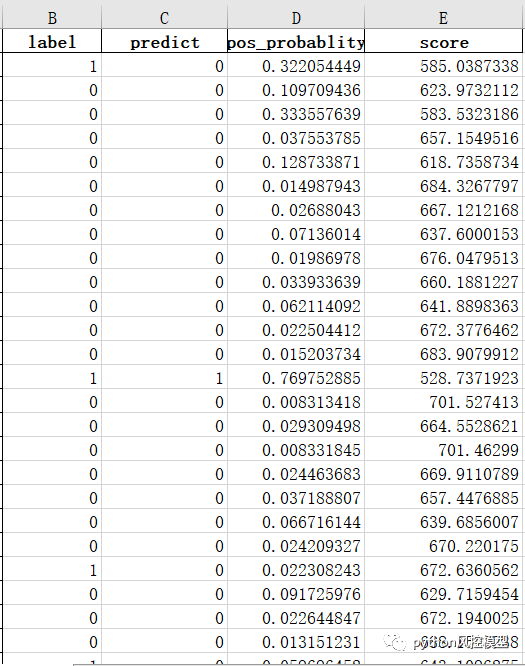
根据信用评分卡方法,我们可以建立计算机自动信用化评分系统。美国传统产品FICO有类似功能,FICO底层语言是Java。目前流行Java,python或R多种语言构建评分卡自动化模型系统。如果数据量大,建立自动信用化评分系统并非易事,需要专业团队不断测试和更新。python或R是开源语言,包定期升级,如果没有专业团队维护,该系统在将来会出现严重问题。
十.模型监控
着时间推移,模型区分能力,例如ks,auc会逐步下降,模型稳定性也会发生偏移。我们需要专业模型监控团队,当监控到模型区分能力下降显著或模型稳定性发生较大偏移时,我们需要重新开发模型,迭代模型。模型监控团队应该每日按时邮件发送模型监控报表给相关团队,特别是开发团队和业务团队。
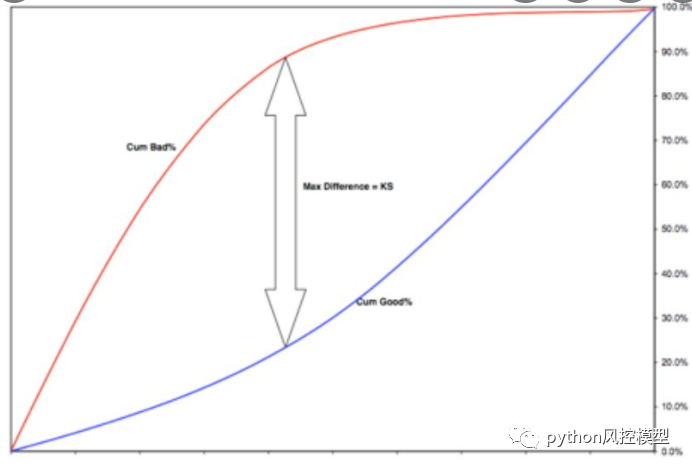
模型监控的ks指标,当模型ks低于0.2时,模型区分好坏客户能力几乎没有作用,需要重新迭代模型。
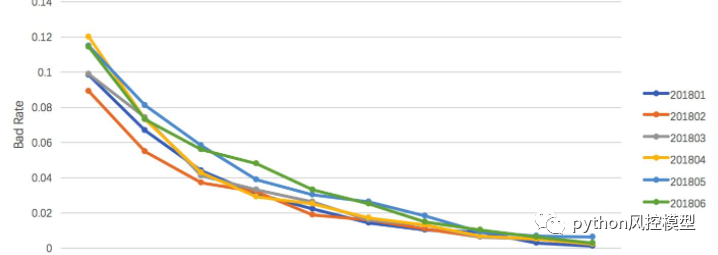
模型监控的bad rate指标,当bad rate突然升高时,领导会非常紧张,这意味着大量贷款收不回成本。
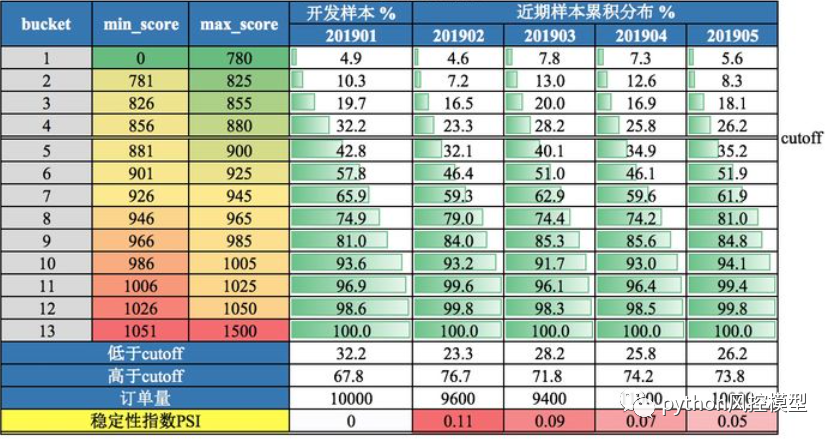
模型监控的PSI指标,当PSI高于0.25时,暗示模型极不稳定,需要重新迭代。
总结
基于Python的信用评分卡模型主要流程就为大家介绍到这里,但实操评分卡建模中有很多细节,互联网上对这些细节描述过于草率甚至不正确。例如变量缺失率达到80%-90%就应该直接删除该变量吗?变量相关性高达0.8就可以去掉吗?经验丰富建模人员需要在数学理论,业务线实际需求,计算机测试结果等多方面找到平衡点,而不是只从一个角度思考问题。这就像经验丰富外科医生并不一定完全遵循教科书的理论。统计学,机器学习,人工智能等领域里有很多争议地方,并非有完全统一共识。各位在学习时要保持独立思考能力,这样才能不断优化数据科学知识。
基于Python的信用评分卡模型-give me some credit就为大家介绍到这里了,
参考资料:<python金融风控评分卡模型和数据分析微专业课(加强版)>
版权声明:文章来自公众号(python风控模型),未经许可,不得抄袭。遵循CC 4.0 BY-SA版权协议,转载请附上原文出处链接及本声明。
发布者:全栈程序员-站长,转载请注明出处:https://javaforall.net/234953.html原文链接:https://javaforall.net


