
出处:https://www.linktimecloud.com/posts/1915
2008年我在我的第一份工作(Ask.com)中开始使用Hadoop。当时是因为昂贵的Oracle集群无法处理不断增加的分析工作量,公司不得不切换到Hadoop。 随后在Twitter担任数据工程师的第二份工作中,我在第一线参与并推动了如何使用数据给几乎所有Twitter的产品赋能(与其称之为“大数据”,我更愿意简单称之为“数据”)。自2008年以来,我亲眼目睹了数据的力量,以及见证了它如何改变世界。 如果你阅读过有关剑桥分析公司如何影响2016年美国大选的文章,那么你会感受到这种改变所带来的非凡意义。
然而,自流行词“大数据”出现10多年后,大数据似乎只对少数公司有用。 在硅谷,几乎所有的独角兽企业都广泛使用大数据来推动他们的成功。 在中国,像BAT这样的公司已经掌握了大数据的艺术,同时我们也有像头条这样主要以大数据技术为基础的超级独角兽公司,但是仍然有很多关于大数据是如何难以使用的笑话。并且令人遗憾的事实是,对于大多数公司来说,大数据要么仍然是流行词,要么的确是难以实现。
幸运的是,一门新学科正在崛起,是解开普通公司数据能力的关键。 它就是DataOps,与DevOps明显相似的名称,以及与DevOps类似的软件开发角色,是数据工程师希望简化数据的使用并真正实现以数据来驱动企业成功的方法。
今天,我们将简要介绍DataOps以及为什么它对每个想要从数据中获取真正价值的公司都很重要。
什么是DataOps
维基百科上DataOps的定义是:
DataOps是一种面向流程的自动化方法,由分析和数据团队使用,旨在提高质量并缩短数据分析的周期时间。
维基百科上的DataOps页面在2017年2月创建,其中详细介绍了这一新学科。 DataOps的定义肯定会随着时间的推移而发展,但其关键目标非常明确:提高数据分析的质量并缩短数据分析的周期。
DataOps可以降低数据分析的门槛,但是它并不会使数据分析变成一项简单的工作。实施成功的数据项目仍然需要大量工作,例如深入了解数据和业务的关系,良好的数据使用规范以及一个公司的数据驱动的文化培养。 不过,DataOps将极大地提高人们使用数据的效率并降低使用数据的门槛,公司可以更快,更早,更好地开始使用数据,并且成本和风险更低。
DataOps解决的问题
大数据的大多数应用可以分类为AI(人工智能)或BI(商业智能)。 此处的AI是指广义的人工智能功能,包括机器学习,数据挖掘以及其他从数据中获取以前未知知识的技术。 BI则是更多地使用统计方法将大量数据汇总到更简单的报告,供人们理解。 简而言之,AI使用各种数据算法来计算新的东西,BI则是统计人们可以理解的数字。
编写AI / BI程序并不难。 你可以在几个小时内设置一个TensorFlow的人脸识别程序。或者使用Matlab绘制一些数据,甚至使用Excel也并不难实现这个目的。 问题在于,要实际使用生产结果来支持面向用户的产品或根据这些神奇的数字来决定公司的命运,你需要的不仅仅是手动工作。
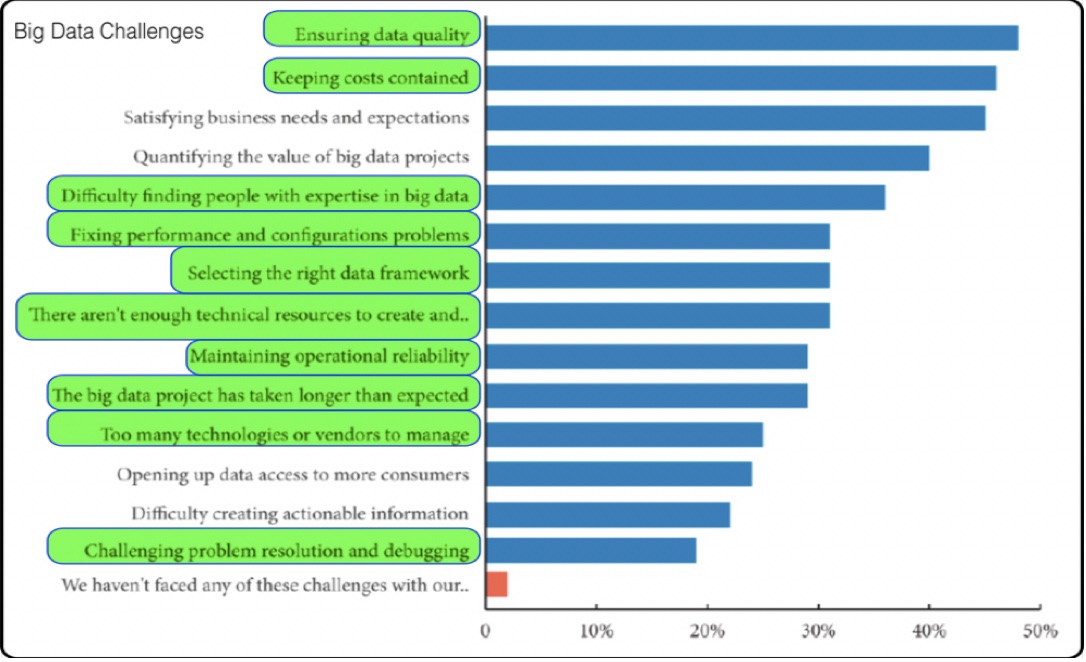
Dimensional Research的一项调查(如上图所示)发现,对于想要实施大数据应用的公司来说,以下问题最为困难:
- 确保数据质量;
- 控制成本;
- 满足业务需求和期望;
- 量化大数据项目的价值;
- 很难找到具有大数据专业知识的人;
- 修复性能和配置问题;
- 选择正确的数据框架;
- 技术资源不足;
- 保持运行可靠性;
- 大数据项目花费的时间比预期的要长;
- 要管理的技术或供应商太多;
- 开放对更多消费者的数据访问;
- 难以创建可操作的信息;
- 复杂问题解决和调试。
谷歌数据分析师的另一项研究发现,对于大多数机器学习项目,只有5%的时间花在编写ML代码上。 另外95%的时间用于设置运行ML代码所需的基础设施。

在这两项研究中,我们可以很容易地看到许多艰苦的工作实际上并不是在编写代码。 整个基础设施的准备工作以及高效运行生产级别的代码是非常费时费力的,而且经常伴随着各种风险。
在谷歌的研究中,他们引用了我的前同事Jimmy Lin和Dmitry Ryaboy(来自Twitter Analytics团队)的话:我们的大部分工作可以被描述为“数据管道工”。 实际上,DataOps使管道工的工作更简单和高效。
DataOps目标功能
DataOps旨在减少整个分析周期时间。 因此,从搭建基础架构到使用数据应用的结果,通常需要实现以下功能:
- 部署:包括基础架构和应用程序。无论底层硬件基础设施如何,配置新系统环境都应该快速而简单。部署新应用程序应该花费几秒而不是几小时或几天;
- 运维:系统和应用程序的可扩展性,可用性,监视,恢复和可靠性。用户不必担心运维,可以专注于业务逻辑;
- 治理:数据的安全性,质量和完整性,包括审计和访问控制。所有数据都在一个支持多租户的安全环境中以连贯和受控的方式进行管理。
- 可用:用户应该能够选择他们想要用于数据的工具,并根据需要轻松运行它们。应将对不同分析/ ML / AI框架的支持整合到系统中;
- 生产:通过调度和数据监控,可以轻松地将分析程序转换为生产应用,构建从数据抽取到数据分析的生产级数据流水线,并且数据的使用应该很容易并由系统管理。
简而言之,它类似于DevOps方法:从编写代码到生产部署的路径,包括调度和监视,应由同一个人完成,并遵循系统管理的标准。 与提供许多标准CI,部署,监控工具以实现快速交付的DevOps类似,通过标准化大量大数据组件,新手可以快速建立生产级的大数据平台并充分利用数据的价值。
DataOps方法论
DataOps的主要方法论仍处于快速发展阶段。 像Facebook和Twitter这样的公司通常会有一个专门的数据平台团队(Data Platform Team)处理数据运营并实现数据项目。 但是,他们的实现方式大多与公司现有的Ops基础设施集成,因此通常不适用于其他人。 我们可以从他们的成功中学习经验,并建立一个可以由每家公司轻松实施的通用大数据平台。
要构建DataOps所需的通用平台,我们认为需要以下技术:
- 云架构:我们必须使用基于云的基础架构来支持资源管理,可扩展性和运营效率;
- 容器:容器在DevOps的实现中至关重要,它在资源隔离和提供一致的dev / test / ops环境中的作用对于实现数据平台仍然至关重要;
- 实时和流处理:实时和流处理现在在数据驱动平台中变得越来越重要,它们应该是现代数据平台的一等公民;
- 多分析引擎:MapReduce是传统的分布式处理框架,但Spark和TensorFlow等框架日常使用越来越广泛,应该进行集成;
- 集成的应用程序和数据管理:应用程序和数据管理,包括生命周期管理,调度,监视,日志记录支持,对于生产数据平台至关重要。 DevOps的常规实践可以应用于应用程序管理,但是数据管理以及应用程序和数据之间的交互需要很多额外的工作;
- 多租户和安全性:数据安全性几乎是数据项目中最重要的问题:如果数据无法保护,则根本无法使用。该平台应为每个人提供一个安全的环境,以便每个人都可以使用这些数据并对每个操作进行授权,验证和审核。
- Dev和Ops工具:该平台应为数据科学家提供有效的工具,以分析数据并生成分析程序,为数据工程师提供大数据流水线的工具,并为其他人提供消费数据和结果的方法。
我们的思考
目前的大数据技术是强大的,但它们对于普通人来说仍然太难使用。部署一个适合生产环境的数据平台仍然是一项艰巨的任务。对于已经开始这一过程的公司来说,他们的数据平台团队大部分时间仍在做相似的事情,就像重新造轮子。
有些公司已经意识到这些问题(Qubole,DataMeer,Bluedata等),并开始采用不同的方法来解决这个问题。其中一些使用基于容器的解决方案,另外一些以Hadoop为中心构建其平台。
我们(Linktime Cloud)也在开发新一代数据平台。我们使用经过验证的分布式操作系统(Apache Mesos)作为底层支持平台,集成了很多常用的大数据组件,并将大多数大数据应用程序容纳在统一的Mesos集群中,而不是对大数据应用程序做特殊处理。 这种方法使我们能够标准化应用程序和数据的管理,从而提供关键技术并实现上述目标。
我们相信,在不久的将来,很多公司将使用集成的大数据平台快速,轻松地构建真正的大数据流水线及应用,而不仅仅是安装Hadoop并运行一些Hive查询。
原作者:彭锋
翻译人:王龙飞
原文链接: http://www.linktimecloud.com/posts/1925
发布者:全栈程序员-站长,转载请注明出处:https://javaforall.net/119541.html原文链接:https://javaforall.net


