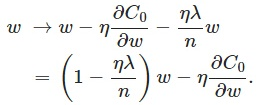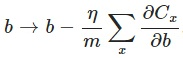权重衰减(weight decay)与学习率衰减(learning rate decay)

权重衰减(weight decay)与学习率衰减(learning rate decay)“微信公众号”1.权重衰减(weightdecay)L2正则化的目的就是为了让权重衰减到更小的值,在一定程度上减少模型过拟合的问题,所以权重衰减也叫L2正则化。1.1L2正则化与权重衰减系数L2正则化就是在代价函数后面再加上一个正则化项:其中C0代表原始的代价函数,后面那一项就是L2正则化项,它是这样来的:所有参数w的平方的和,除以训练集的样本大小n。λ就是正则项系数,权衡正则项与C0项的比…

大家好,又见面了,我是你们的朋友全栈君。

“微信公众号”
权重衰减(weight decay)与学习率衰减(learning rate decay)

1. 权重衰减(weight decay)

L2正则化的目的就是为了让权重衰减到更小的值,在一定程度上减少模型过拟合的问题,所以权重衰减也叫L2正则化。

1.1 L2正则化与权重衰减系数

L2正则化就是在代价函数后面再加上一个正则化项:
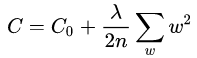
权重衰减(weight decay)与学习率衰减(learning rate decay)

其中C0
代表原始的代价函数,后面那一项就是L2正则化项,它是这样来的:所有参数w的平方的和,除以训练集的样本大小n。λ就是正则项系数,权衡正则项与C0
项的比重。另外还有一个系数1/2
,1/2 1/211
经常会看到,主要是为了后面求导的结果方便,后面那一项求导会产生一个2,与1/2
相乘刚好凑整为1。系数λ
就是
权重衰减系数
。


1.2 为什么可以对权重进行衰减

我们对加入L2正则化后的代价函数进行推导,先求导:
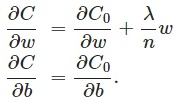
权重衰减(weight decay)与学习率衰减(learning rate decay)

可以发现L2正则化项对b的更新没有影响,但是对于w的更新有影响:

权重衰减(weight decay)与学习率衰减(learning rate decay)

在不使用L2正则化时,求导结果中w前系数为1,现在w前面系数为1-ηλ/n,因为η、λ、n都是正的,所以1-ηλ/n小于1,它的效果是减小w,这也就是权重衰减(weight decay)的由来。当然考虑到后面的导数项,w最终的值可能增大也可能减小。

另外,需要提一下,对于基于mini-batch的随机梯度下降,w和b更新的公式跟上面给出的有点不同:
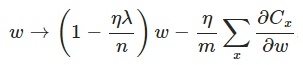
权重衰减(weight decay)与学习率衰减(learning rate decay)

对比上面w的更新公式,可以发现后面那一项变了,变成所有导数加和,乘以η再除以m,m是一个mini-batch中样本的个数。


1.3 权重衰减(L2正则化)的作用

作用: 权重衰减(L2正则化)可以避免模型过拟合问题。

思考: L2正则化项有让w变小的效果,但是为什么w变小可以防止过拟合呢?

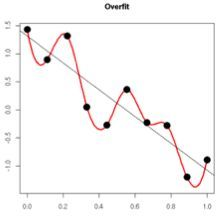
原理: (1)从模型的复杂度上解释:更小的权值w,从某种意义上说,表示网络的复杂度更低,对数据的拟合更好(这个法则也叫做奥卡姆剃刀),而在实际应用中,也验证了这一点,L2正则化的效果往往好于未经正则化的效果。(2)从数学方面的解释:过拟合的时候,拟合函数的系数往往非常大,为什么?如下图所示,过拟合,就是拟合函数需要顾忌每一个点,最终形成的拟合函数波动很大。在某些很小的区间里,函数值的变化很剧烈。这就意味着函数在某些小区间里的导数值(绝对值)非常大,由于自变量值可大可小,所以只有系数足够大,才能保证导数值很大。而正则化是通过约束参数的范数使其不要太大,所以可以在一定程度上减少过拟合情况。
权重衰减(weight decay)与学习率衰减(learning rate decay)

2. 学习率衰减(learning rate decay)

在训练模型的时候,通常会遇到这种情况:我们平衡模型的训练速度和损失(loss)后选择了相对合适的学习率(learning rate),但是训练集的损失下降到一定的程度后就不在下降了,比如training loss一直在0.7和0.9之间来回震荡,不能进一步下降。如下图所示:

权重衰减(weight decay)与学习率衰减(learning rate decay)

遇到这种情况通常可以通过适当降低学习率(learning rate)来实现。但是,降低学习率又会延长训练所需的时间。

学习率衰减(learning rate decay) 就是一种可以平衡这两者之间矛盾的解决方案。学习率衰减的基本思想是:学习率随着训练的进行逐渐衰减。

学习率衰减基本有两种实现方法:

  1. 线性衰减。例如:每过5个epochs学习率减半。
  2. 指数衰减。例如:随着迭代轮数的增加学习率自动发生衰减,每过5个epochs将学习率乘以0.9998。具体算法如下:
decayed_learning_rate=learning_rate*decay_rate^(global_step/decay_steps)

其中decayed_learning_rate为每一轮优化时使用的学习率,learning_rate为事先设定的初始学习率,decay_rate为衰减系数,decay_steps为衰减速度。

Reference:

(1)学习率衰减部分内容和图片来自:
学习率衰减(learning rate decay)

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容, 请发送邮件至 举报,一经查实,本站将立刻删除。

发布者:全栈程序员-站长,转载请注明出处:https://javaforall.net/131135.html原文链接:https://javaforall.net

赞 (0)
全栈程序员-站长的头像全栈程序员-站长

相关推荐

  • Qt获得焦点和失去焦点处理事件 (Focus事件)

    Qt获得焦点和失去焦点处理事件 (Focus事件)方法一:描述:一开始我要实现的目的就是,在一个窗体上有多个可编辑控件(比如QLineEdit、QTextEdit等),当哪个控件获得焦点,哪个控件的背景就高亮用来起提示作用,查了下文档应该用focusInEvent()和focusOutEvent(),在实际过程中,我犯了十分严重的错误,最开始的时候我是这样做的:我重写了窗体QWidget的这两个函数,然后再在函数体中把QFocusEve

    2022年6月15日
  • sql2008r2绿色版免安装_少女都市模拟器中文版激活成功教程版免费

    sql2008r2绿色版免安装_少女都市模拟器中文版激活成功教程版免费中文版本64位免激活成功教程SQLyog-12.5.064位中文激活成功教程版 百度云盘https://pan.baidu.com/s/1yvQ7f0esY8idqc_Ci3Su2Ahttps://pan.baidu.com/s/1mhFLVpm 原文:https://blog.csdn.net/odyssey1816/article/details/78801342…

    2022年9月24日
  • TomCat7安装与配置[通俗易懂]

    TomCat7安装与配置[通俗易懂]首先下载并安装之,然后配置环境变量。安装完成后右击“我的电脑”,然后“属性”—>”高级系统设置”—>”环境变量”,在系统变量中添加以下变量a、TOMCAT_HOME,该变量指向解压文件的路径,该目录下有lib、bin等文件夹。添加方法如下:点击”环境变量”下的“新建”,在“变量名”中填写“TOMCAT_HOME”,在“变量值”中填写解压文件的路径D:\Tomcat\apache-tomcat-9.

    2022年5月18日
  • Coordinator Layout使用

    Coordinator Layout使用

    2021年6月17日
  • fatal error解决方法_游戏fatal error

    fatal error解决方法_游戏fatal error开发环境:VisualStudio2017opencv-4.0.0-vc14_vc15首先区别几个选项:(1)***d.lib和***.lib区别:Release版本选择(通过在x64旁边的下拉栏中可以选择调试的版本)opencv_world400.libDebug版本选择opencv_world400d.lib(2)vc14和vc15区别:VC14构建需要安…

    2022年10月7日
  • 盘点多款国产Linux桌面操作系统[通俗易懂]

    盘点多款国产Linux桌面操作系统[通俗易懂]关注、星标公众号,不错过精彩内容编辑:strongerHuang微信公众号:strongerHuang素材来源:百度百科、网络国产操作系统多为以Linux为基础二次开发的操作系统。2014年4月8日起,美国微软公司停止了对WindowsXPSP3操作系统提供服务支持,这引起了社会和广大用户的广泛关注和对信息安全的担忧。工信部对此表示…

    2022年5月17日

发表回复

您的邮箱地址不会被公开。 必填项已用 * 标注

关注全栈程序员社区公众号