
大家好,又见面了,我是你们的朋友全栈君。
符号说明:
- x 表 示 样 本 特 征 数 据 x表示样本特征数据 x表示样本特征数据
- y 表 示 样 本 目 标 数 据 y表示样本目标数据 y表示样本目标数据
- 第 i 个 训 练 样 本 为 ( x i , y i ) , 为 了 方 便 也 可 以 用 x = x i 表 示 第 i 个 样 本 第i个训练样本为\left( x_{i},y_{i} \right),为了方便也可以用x =x_{i}表示第i个样本 第i个训练样本为(xi,yi),为了方便也可以用x=xi表示第i个样本
1 基于域的分解机模型(FFM)
1.1 线性模型
∅ ( w , x ) = w T x = w 0 + ∑ j ∈ C 1 w j x j − − − − ( 1 ) \varnothing\left( w,x \right) = w^{T}x = w_{0} + \sum_{j \in C_{1}}^{}{w_{j}x_{j}}—-(1) ∅(w,x)=wTx=w0+j∈C1∑wjxj−−−−(1)
C 1 表 示 x 中 非 零 元 素 索 引 的 集 合 C_{1}表示x中非零元素索引的集合 C1表示x中非零元素索引的集合
1.2 二次多项式模型
∅ ( w , x ) = w T x = w 0 + ∑ j 1 , j 2 ∈ C 2 w j 1 , j 2 x j 1 x j 2 − − − − ( 2 ) \varnothing\left( w,x \right) = w^{T}x = w_{0} + \sum_{j1,j2 \in C_{2}}^{}{w_{j1,j2}x_{j1}x_{j2}}—-(2) ∅(w,x)=wTx=w0+j1,j2∈C2∑wj1,j2xj1xj2−−−−(2)
C 2 表 示 x 中 非 零 的 组 合 元 素 索 引 的 集 合 C_{2}表示x中非零的组合元素索引的集合 C2表示x中非零的组合元素索引的集合
1.3 分解机模型
∅ ( w , x ) = w T x = w 0 + ∑ j ∈ C 1 w j x j + ∑ j 1 , j 2 ∈ C 2 ⟨ w j 1 , w j 2 ⟩ x j 1 x j 2 − − − − ( 3 ) \varnothing\left( w,x \right) = w^{T}x = w_{0} + \sum_{j \in C_{1}}^{}{w_{j}x_{j}} + \sum_{j1,j2 \in C_{2}}^{}{\left\langle \mathbf{w}_{j1},\mathbf{w}_{j2} \right\rangle x_{j1}x_{j2}} —-(3) ∅(w,x)=wTx=w0+j∈C1∑wjxj+j1,j2∈C2∑⟨wj1,wj2⟩xj1xj2−−−−(3)
w 是 二 维 矩 阵 , w i 表 示 第 i 行 向 量 , 长 度 为 k , k 是 用 户 自 定 义 的 参 数 , 也 称 之 为 隐 变 量 \mathbf{w}是二维矩阵,\mathbf{w}_{i}表示第i行向量,长度为k,k是用户自定义的参数,也称之为隐变量 w是二维矩阵,wi表示第i行向量,长度为k,k是用户自定义的参数,也称之为隐变量
1.4 域分解机模型
∅ ( w , x ) = w T x = w 0 + ∑ j ∈ C 1 w j x j + ∑ j 1 , j 2 ∈ C 2 ⟨ w j 1 , f j 2 , w j 2 , f j 1 ⟩ x j 1 x j 2 − − − − ( 4 ) \varnothing\left( w,x \right) = w^{T}x = w_{0} + \sum_{j \in C_{1}}^{}{w_{j}x_{j}} + \sum_{j1,j2 \in C_{2}}^{}{\left\langle \mathbf{w}_{j1,f_{j2}},\mathbf{w}_{j2,f_{j1}} \right\rangle x_{j1}x_{j2}}—-(4) ∅(w,x)=wTx=w0+j∈C1∑wjxj+j1,j2∈C2∑⟨wj1,fj2,wj2,fj1⟩xj1xj2−−−−(4)
因为线性项 w 0 + ∑ j ∈ C 1 w j x j w_{0} + \sum_{j \in C_{1}}^{}{w_{j}x_{j}} w0+j∈C1∑wjxj在训练过程中非常容易计算,所以可以先将其忽略,只需要研究 ∑ j 1 , j 2 ∈ C 2 ⟨ w j 1 , f j 2 , w j 2 , f j 1 ⟩ x j 1 x j 2 \sum_{j1,j2 \in C_{2}}^{}{\left\langle \mathbf{w}_{j1,f_{j2}},\mathbf{w}_{j2,f_{j1}} \right\rangle x_{j1}x_{j2}} j1,j2∈C2∑⟨wj1,fj2,wj2,fj1⟩xj1xj2,将其写成另一种形式
∑ i = 1 n ∑ j = i + 1 n ⟨ w i , f j , w j , f i ⟩ x i x j − − − − ( 5 ) \sum_{i = 1}^{n}{\sum_{j = i + 1}^{n}{\left\langle \mathbf{w}_{i,f_{j}},\mathbf{w}_{j,f_{i}} \right\rangle x_{i}x_{j}}}—-(5) i=1∑nj=i+1∑n⟨wi,fj,wj,fi⟩xixj−−−−(5)
1.5 基于FFM的逻辑回归模型
1.5.1 -1,1损失的逻辑回归模型
min w ∑ p = 1 L ( log ( 1 + e x p ( − y p ∅ ( w , x p ) ) ) + λ 2 ∥ w ∥ 2 ) − − − − ( 6 ) \min_{w}\sum_{p = 1}^{L}\left( \log\left( 1 + exp\left( – y_{p}\varnothing\left( \mathbf{w},x_{p} \right) \right) \right) + \frac{\lambda}{2}\left\| \mathbf{w} \right\|^{2} \right)—-(6) wminp=1∑L(log(1+exp(−yp∅(w,xp)))+2λ∥w∥2)−−−−(6)
其中
∅ ( w , x p ) = ∑ i = 1 n ∑ j = i + 1 n ⟨ w i , f p , j , w j , f p , i ⟩ x p , i x p , j − − − − ( 7 ) \varnothing\left( \mathbf{w},x_{p} \right) = \sum_{i = 1}^{n}{\sum_{j = i + 1}^{n}{\left\langle \mathbf{w}_{i,f_{p,j}},\mathbf{w}_{j,f_{p,i}} \right\rangle x_{p,i}x_{p,j}}}—-(7) ∅(w,xp)=i=1∑nj=i+1∑n⟨wi,fp,j,wj,fp,i⟩xp,ixp,j−−−−(7)
令
L ( x p , y p ) = l o g ( 1 + e x p ( − y p ∅ ( w , x p ) ) ) + λ 2 ∥ w ∥ 2 − − − − ( 8 ) L\left( x_{p},y_{p} \right) = log\left( 1 + exp\left( – y_{p}\varnothing\left( \mathbf{w},x_{p} \right) \right) \right) + \frac{\lambda}{2}\left\| \mathbf{w} \right\|^{2}—-(8) L(xp,yp)=log(1+exp(−yp∅(w,xp)))+2λ∥w∥2−−−−(8)
其为每个样本的损失函数。
L ( x p , y p ) 对 参 数 w 的 导 数 为 : L\left( x_{p},y_{p} \right)对参数\mathbf{w}的导数为: L(xp,yp)对参数w的导数为:
∂ L ( x p , y p ) ∂ w = − y p exp ( − y p ∅ ( w , x p ) ) 1 + e x p ( − y p ∅ ( w , x p ) ) ∂ ∅ ( w , x p ) ∂ w + λ w − − − − ( 9 ) \frac{\partial L\left( x_{p},y_{p} \right)}{\partial\mathbf{w}} = \frac{- y_{p}\exp\left( – y_{p}\varnothing\left( \mathbf{w},x_{p} \right) \right)}{1 + exp\left( – y_{p}\varnothing\left( \mathbf{w},x_{p} \right) \right)}\frac{\partial\varnothing\left( \mathbf{w},x_{p} \right)}{\partial\mathbf{w}} + \lambda\mathbf{w}—-(9) ∂w∂L(xp,yp)=1+exp(−yp∅(w,xp))−ypexp(−yp∅(w,xp))∂w∂∅(w,xp)+λw−−−−(9)
在式(8)的导数计算公式中, − y p exp ( − y p ∅ ( w , x p ) ) 1 + e x p ( − y p ∅ ( w , x p ) ) \frac{- y_{p}\exp\left( – y_{p}\varnothing\left( \mathbf{w},x_{p} \right) \right)}{1 + exp\left( – y_{p}\varnothing\left(\mathbf{w},x_{p} \right)\right)} 1+exp(−yp∅(w,xp))−ypexp(−yp∅(w,xp))是标量,对于每个样本只要按照式(7)计算即可,第二项 λ w \lambda\mathbf{w} λw用惩罚参数乘以对应的参数即可,比较麻烦的就是 ∂ ∅ ( w , x p ) ∂ w \frac{\partial\varnothing\left( \mathbf{w},x_{p} \right)}{\partial\mathbf{w}} ∂w∂∅(w,xp)的计算。
1.5.2 ∅ ( w , x p ) \mathbf{\varnothing}\left( \mathbf{w}\mathbf{,}\mathbf{x}_{\mathbf{p}} \right) ∅(w,xp)的求导过程$
为了便于理解首先对 ⟨ w i , f p , j , w j , f p , i ⟩ x p , i x p , j \left\langle \mathbf{w}_{i,f_{p,j}},\mathbf{w}_{j,f_{p,i}} \right\rangle x_{p,i}x_{p,j} ⟨wi,fp,j,wj,fp,i⟩xp,ixp,j中的 w i , f p , j \mathbf{w}_{i,f_{p,j}} wi,fp,j和 w j , f p , i \mathbf{w}_{j,f_{p,i}} wj,fp,i分别的偏导数如下
∂ ⟨ w i , f p , j , w j , f p , i ⟩ x p , i x p , j ∂ w i , f p , j = w j , f p , i x p , i x p , j − − − − ( 10 ) \frac{\partial\left\langle \mathbf{w}_{i,f_{p,j}},\mathbf{w}_{j,f_{p,i}} \right\rangle x_{p,i}x_{p,j}}{\partial\mathbf{w}_{i,f_{p,j}}} = \mathbf{w}_{j,f_{p,i}}x_{p,i}x_{p,j}—-(10) ∂wi,fp,j∂⟨wi,fp,j,wj,fp,i⟩xp,ixp,j=wj,fp,ixp,ixp,j−−−−(10)
∂ ⟨ w i , f p , j , w j , f p , i ⟩ x p , i x p , j w j , f p , i = w i , f p , j x p , i x p , j − − − − ( 11 ) \frac{\partial\left\langle \mathbf{w}_{i,f_{p,j}},\mathbf{w}_{j,f_{p,i}} \right\rangle x_{p,i}x_{p,j}}{\mathbf{w}_{j,f_{p,i}}} = \mathbf{w}_{i,f_{p,j}}x_{p,i}x_{p,j}—-(11) wj,fp,i∂⟨wi,fp,j,wj,fp,i⟩xp,ixp,j=wi,fp,jxp,ixp,j−−−−(11)
所 以 ∅ ( w , x p ) 对 w i , f p , j 和 w j , f p , i 的 偏 导 数 分 别 如 下 所以\varnothing\left( \mathbf{w},x_{p} \right)对\mathbf{w}_{i,f_{p,j}}和\mathbf{w}_{j,f_{p,i}}的偏导数分别如下 所以∅(w,xp)对wi,fp,j和wj,fp,i的偏导数分别如下
∂ ∅ ( w , x p ) ∂ w i , f p , j = ∑ i = 1 n ∑ j = i + 1 n w j , f p , i x p , i x p , j − − − − ( 12 ) \frac{\partial\varnothing\left( \mathbf{w},x_{p} \right)}{\partial\mathbf{w}_{i,f_{p,j}}} = \sum_{i = 1}^{n}{\sum_{j = i +1}^{n}{\mathbf{w}_{j,f_{p,i}}x_{p,i}x_{p,j}}}—-(12) ∂wi,fp,j∂∅(w,xp)=i=1∑nj=i+1∑nwj,fp,ixp,ixp,j−−−−(12)
∂ ∅ ( w , x p ) ∂ w j , f p , i = ∑ i = 1 n ∑ j = i + 1 n w i , f p , j x p , i x p , j − − − − ( 13 ) \frac{\partial\varnothing\left( \mathbf{w},x_{p} \right)}{\partial\mathbf{w}_{j,f_{p,i}}} = \sum_{i = 1}^{n}{\sum_{j = i + 1}^{n}{\mathbf{w}_{i,f_{p,j}}x_{p,i}x_{p,j}}}—-(13) ∂wj,fp,i∂∅(w,xp)=i=1∑nj=i+1∑nwi,fp,jxp,ixp,j−−−−(13)
| **训练模型时需要注意的问题:**在式(12)和式(13)中会存在 w j , f p , i ( x t , i x t , j + x q , i x q , j + ⋯ ) \mathbf{w}_{j,f_{p,i}}\left( x_{t,i}x_{t,j} + x_{q,i}x_{q,j} + \cdots \right) wj,fp,i(xt,ixt,j+xq,ixq,j+⋯)在训练时不需要合并这些项,只要把这些项当成更新参数 w j , f p , i \mathbf{w}_{j,f_{p,i}} wj,fp,i的多个样本即可,这在编程实现中将非常有用。 |
|---|
假设有如下的例子,五个特征,两个域
按 照 式 ( 7 ) , 去 掉 下 标 p , 计 算 图 1 中 所 示 的 分 解 模 型 , 如 下 按照式(7),去掉下标p,计算图1中所示的分解模型,如下 按照式(7),去掉下标p,计算图1中所示的分解模型,如下
∅ ( w , x ) = ∑ i = 1 5 ∑ j = i + 1 5 ⟨ w i , f j , w j , f i ⟩ x i x j \varnothing\left( \mathbf{w},x \right) = \sum_{i = 1}^{5}{\sum_{j = i + 1}^{5}{\left\langle \mathbf{w}_{i,f_{j}},\mathbf{w}_{j,f_{i}} \right\rangle x_{i}x_{j}}} ∅(w,x)=i=1∑5j=i+1∑5⟨wi,fj,wj,fi⟩xixj
= ⟨ w 1 , f 1 , w 2 , f 1 ⟩ x 1 x 2 + ⟨ w 1 , f 1 , w 3 , f 1 ⟩ x 1 x 3 + ⟨ w 1 , f 2 , w 4 , f 1 ⟩ x 1 x 4 + ⟨ w 1 , f 2 , w 5 , f 1 ⟩ x 1 x 5 = \left\langle \mathbf{w}_{1,f_{1}},\mathbf{w}_{2,f_{1}} \right\rangle x_{1}x_{2} + \left\langle \mathbf{w}_{1,f_{1}},\mathbf{w}_{3,f_{1}} \right\rangle x_{1}x_{3} + \left\langle \mathbf{w}_{1,f_{2}},\mathbf{w}_{4,f_{1}} \right\rangle x_{1}x_{4} + \left\langle \mathbf{w}_{1,f_{2}},\mathbf{w}_{5,f_{1}} \right\rangle x_{1}x_{5} =⟨w1,f1,w2,f1⟩x1x2+⟨w1,f1,w3,f1⟩x1x3+⟨w1,f2,w4,f1⟩x1x4+⟨w1,f2,w5,f1⟩x1x5
$$
- \left\langle \mathbf{w}{2,f{1}},\mathbf{w}{3,f{1}} \right\rangle x_{2}x_{3} + \left\langle \mathbf{w}{2,f{2}},\mathbf{w}{4,f{1}} \right\rangle x_{2}x_{4} + \left\langle \mathbf{w}{2,f{2}},\mathbf{w}{5,f{1}} \right\rangle x_{2}x_{5}
$$
$$
- \left\langle \mathbf{w}{3,f{2}},\mathbf{w}{4,f{1}} \right\rangle x_{3}x_{4} + \left\langle \mathbf{w}{3,f{2}},\mathbf{w}{5,f{1}} \right\rangle x_{3}x_{5}
$$
$$
- \left\langle \mathbf{w}{4,f{2}},\mathbf{w}{5,f{2}} \right\rangle x_{4}x_{5}
$$
从 上 式 中 抽 取 i = 1 , f j = 1 和 i = 3 , f j = 2 从上式中抽取i = 1,f_{j} = 1和i = 3,f_{j} = 2 从上式中抽取i=1,fj=1和i=3,fj=2
∂ ∅ ( w , x ) ∂ w 1 , f 1 = w 2 , f 1 x 1 x 2 + w 3 , f 1 x 1 x 3 \frac{\partial\varnothing\left( \mathbf{w},x \right)}{\partial\mathbf{w}_{1,f_{1}}} = \mathbf{w}_{2,f_{1}}x_{1}x_{2} + \mathbf{w}_{3,f_{1}}x_{1}x_{3} ∂w1,f1∂∅(w,x)=w2,f1x1x2+w3,f1x1x3
∂ ∅ ( w , x ) ∂ w 3 , f 2 = w 4 , f 1 x 3 x 4 + w 5 , f 1 x 3 x 5 \frac{\partial\varnothing\left( \mathbf{w},x \right)}{\partial\mathbf{w}_{3,f_{2}}} = \mathbf{w}_{4,f_{1}}x_{3}x_{4} + \mathbf{w}_{5,f_{1}}x_{3}x_{5} ∂w3,f2∂∅(w,x)=w4,f1x3x4+w5,f1x3x5
在模型学习时,需要迭代公式 w = w + η g \mathbf{w = w +}\eta\mathbf{g} w=w+ηg, η , g \eta,\mathbf{g} η,g分别为学习率和梯度向量,则在计算 w 3 , f 2 \mathbf{w}_{3,f_{2}} w3,f2时有两种方式:
方式1:
w 3 , f 2 = w 3 , f 2 + η ( w 4 , f 1 x 3 x 4 + w 5 , f 1 x 3 x 5 ) \mathbf{w}_{3,f_{2}} = \mathbf{w}_{3,f_{2}} + \eta\left( \mathbf{w}_{4,f_{1}}x_{3}x_{4} + \mathbf{w}_{5,f_{1}}x_{3}x_{5} \right) w3,f2=w3,f2+η(w4,f1x3x4+w5,f1x3x5)
方式2:
w 3 , f 2 = w 3 , f 2 + η 1 ( w 4 , f 1 x 3 x 4 ) \mathbf{w}_{3,f_{2}} = \mathbf{w}_{3,f_{2}} + \eta_{1}\left( \mathbf{w}_{4,f_{1}}x_{3}x_{4} \right) w3,f2=w3,f2+η1(w4,f1x3x4)
w 3 , f 2 = w 3 , f 2 + η 2 ( w 5 , f 1 x 3 x 5 ) \mathbf{w}_{3,f_{2}} = \mathbf{w}_{3,f_{2}} + \eta_{2}\left( \mathbf{w}_{5,f_{1}}x_{3}x_{5} \right) w3,f2=w3,f2+η2(w5,f1x3x5)
因 为 采 用 的 是 A d a G r a d 所 以 学 习 率 η 在 方 式 二 中 是 变 化 的 。 因为采用的是AdaGrad所以学习率\eta在方式二中是变化的。 因为采用的是AdaGrad所以学习率η在方式二中是变化的。
在学习过程中是采用方式1还是方式2哪。答案是方式2。因为在计算实际问题时可能特征分布在多个域中,如果按照方式1则需要把每个域中的信息累加起来,结果是编程上非常麻烦,如果按照方式2,非常符合SGD的思想,把 w 4 , f 1 x 3 x 4 \mathbf{w}_{4,f_{1}}x_{3}x_{4} w4,f1x3x4和 w 5 , f 1 x 3 x 5 \mathbf{w}_{5,f_{1}}x_{3}x_{5} w5,f1x3x5看成两个样本,再带回到 x 3 x 4 x_{3}x_{4} x3x4组合时更新下 w 3 , f 2 \mathbf{w}_{3,f_{2}} w3,f2,当访问到 x 3 x 5 x_{3}x_{5} x3x5组合时再次更新下 w 3 , f 2 \mathbf{w}_{3,f_{2}} w3,f2,在实际编程中,具体更新哪些参数可以通过相应的索引进行访问,非常方便。
2 libFFM介绍
2.1 使用介绍
1)编译
下载libffm-1.13.tar.gz,解压,在libffm-1.13下直接make,会产生两个可执行的文件ffm-train和ffm-predict分别用于训练和预测结果。
2)输入数据格式
<label>\t<field1>:<index1>:<value1>\t<field2>:<index2>:<value2>\t...
fieldi表示域的id,indexi表示特征的id,它们都是非负值。
0 1:7759:0.3651 2:7921:0.3651 3:8661:0.3651 4:9619:0.3651
1 1:7633:0.3651 2:8195:0.3651 3:9952:0.3651 4:9619:0.3651
**注意:**libFFM中使用的是“-1,1”损失函数,所以label只能取-1或者1,而这里的样例数据中目标是0、1。因为在libFFM中读取数据时将大于0的目标当成1,小于等于0的当成-1。所以数据中的0、1并不表示损失是0,1。 |
3)命令行调用方式
训练:ffm-train [options] training_set_file [model_file]
options控制参数如下表
表 1 o p t i o n s 控 制 参 数 解 释 表1 options控制参数解释 表1options控制参数解释
| -l | 惩罚参数,缺省值0.00002 |
|---|---|
| -k | 隐变量的个数,缺省值4 |
| -t | 模型训练时的迭代次数,缺省值15 |
| -r | 初始学习率,缺省值0.2 |
| -s <nr_threads> | OpenMP的线程数,缺省值1 |
| -p
|
Validation数据的路径 |
| -v | 交叉验证中的折数 |
| –quiet | 控制是否输出运行时信息 |
| –no-norm | 关闭归一化功能,缺省是对样本进行归一化处理 |
| –no-rand | 关闭随机更新功能 |
| –on-disk | 当有这个参数时,不会将数据全部读入内存,而是将训练数据存储在磁盘,此时产生一个临时文件<training_set_file>.bin |
| –auto-stop: | 当达到最优的validation损失时自动停止,必须与-p参数一同使用 |
说明:
- –no-norm:缺省状态时用每个样本向量的2范数对样本中的每个元素进行归一化,如果设置了这个参数,则不进行归一化处理。
- –no-rand:缺省状态训练时随机从数据中选取训练样本,如果不想随机的抽取训练样本,而是想按照数据集中的样本顺序训练,则可以使用此参数,同时还要配合参数”-s
1”使用。 - –on-disk:如果训练数据较大内存无法加载全量数据,则可以使用此参数。需要注意的是,这种训练模式下不支持随机的抽取训练数据,所以此时需要设置参数“—no-rand”,同时这种模式下不支持交叉验证。同时还会在磁盘上产生临时的二进制文件[training_set_file].bin。
**预测**:
**ffm-predict** test\_file model\_file output\_file
作者给的几个例子
- 使用缺省参数训练模型
- ffm-train bigdata.tr.txt model
- 使用如下参数训练模型
- regularization cost = 0.001
- latent factors = 16
- iterations = 30
- learning rate = 0.05
- threads = 4
- ffm-train -l 0.001 -k 16 -t 30 -r 0.05 -s 4 bigdata.tr.txt model
- 使用bigdata.te.txt作为validation数据
- ffm-train -p bigdata.te.txt bigdata.tr.txt model
- 使用5折交叉验证
- ffm-train -v 5 bigdata.tr.txt
- 用--quiet参数训练时不打印训练信息
- ffm-train --quiet bigdata.tr.txt
- 预测
-ffm-predict bigdata.te.txt model output
- 基于磁盘的训练
ffm-train --no-rand --on-disk bigdata.tr.txt
- 使用--auto-stop参数,当达到最优的validation损失时停止训练
ffm-train -p bigdata.te.txt -t 100 bigdata.tr.txt
### 2.2 源码分析
#### 2.2.1 存储模型用到的数据结构
- 存储特征的结构体如下
$$f表示域id,j表示特征id,v表示特征的值$$
<div align=center>

图2
- 存储整个训练数据集的结构体如下
$m表示特征个数;l表示样本可是,即训练数据的行数;m表示域的个数;X存储训练数据中非零特征;P用来记录X中每个样本数据的起始位置和结束位置;Y存储样本数据的标签值$
<div align=center>
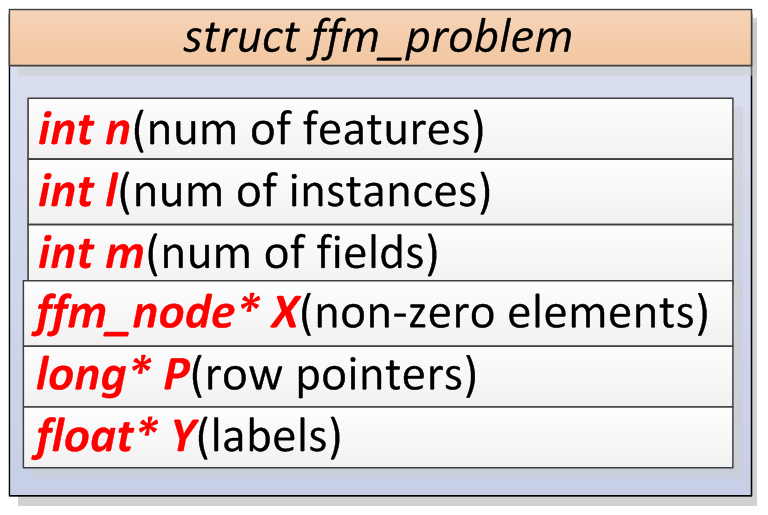
图3
- $下面介绍X和Y的存储格式$
<div align=center>
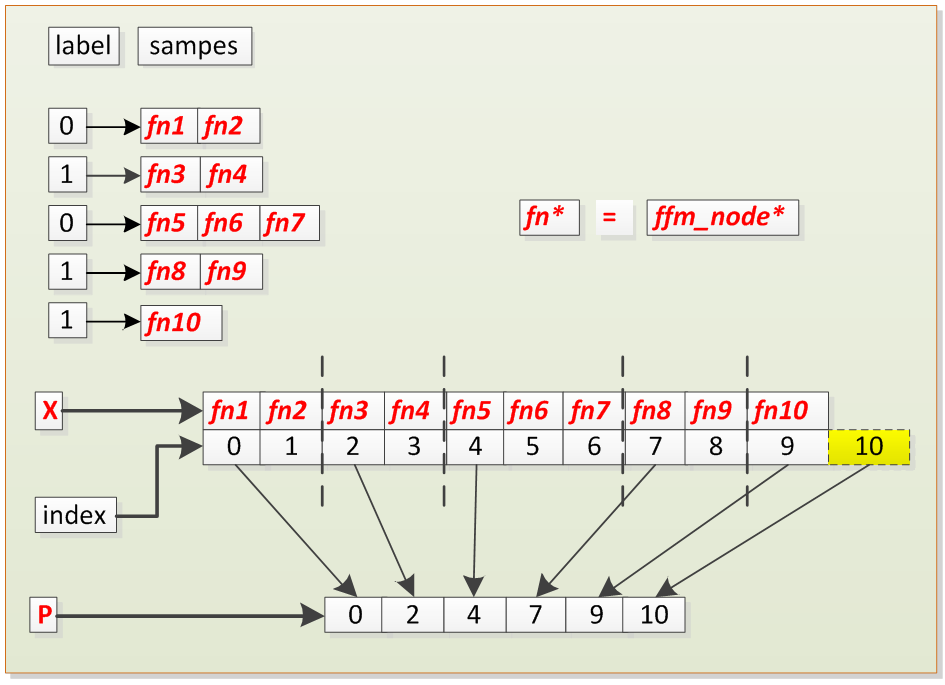
图4
- 存储模型结构体如下:下面会主要介绍W的结构
<div align=center>

图5
- $W的存储格式如下$
<div align=center>
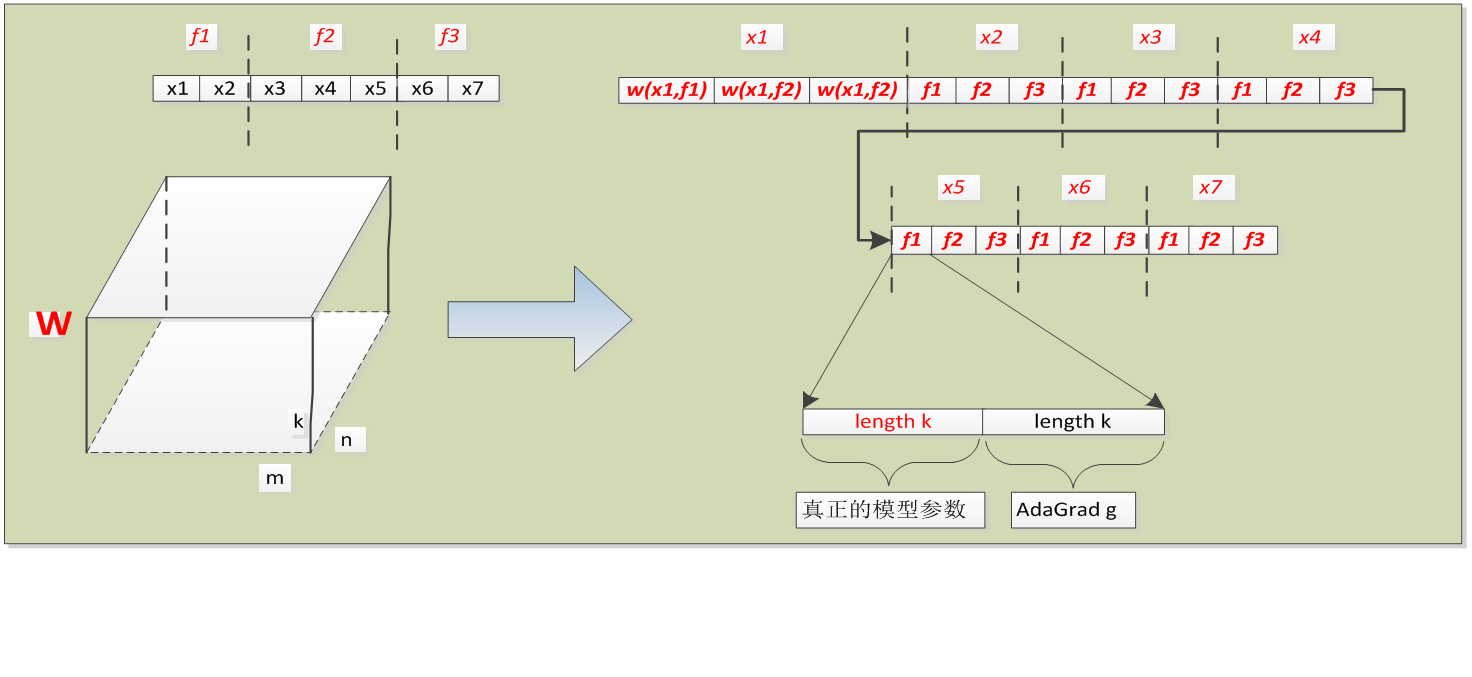
图6
-----
#### 2.2.2 训练
- 主要的训练方法为
shared_ptr<ffm_model> train(ffm_problem *tr,vector<ffm_int> &order, ffm_parameter param, ffm_problem *va=nullptr)
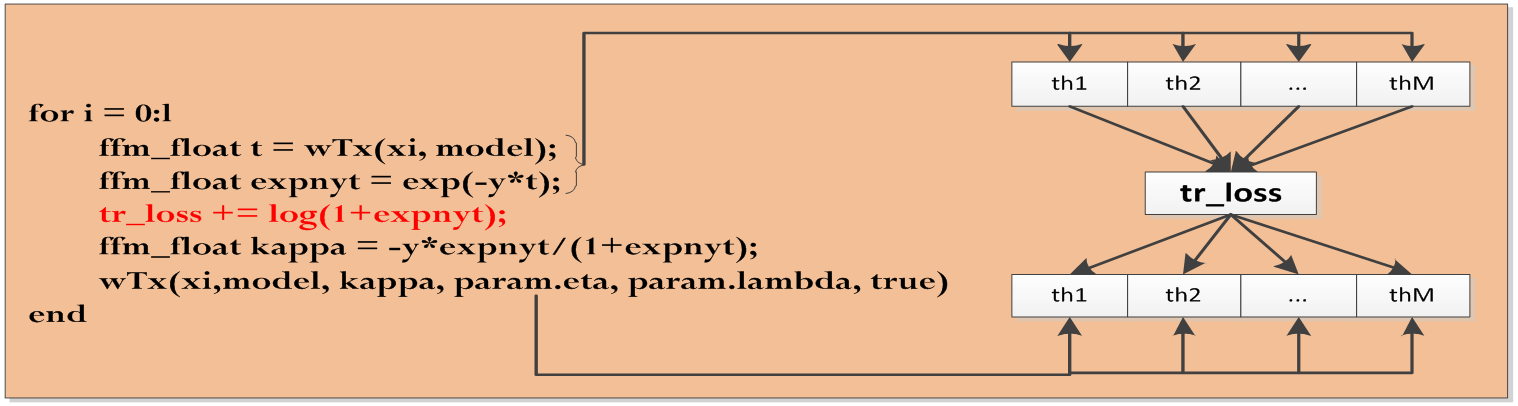
在该方法中采用AdaGrad对每个样本进行训练。值得一提的是该方法中采用OpenMP和SSE进行加速,为了理解加速的位置,下面将伪码写出
for i = 0:l //l为特征个数
ffm_float t = wTx(xi, model);
ffm_float expnyt = exp(-y*t);
tr_loss += log(1+expnyt);
ffm_float kappa = -y*expnyt/(1+expnyt);
wTx(begin, end, r, *model, kappa, param.eta, param.lambda, true);
end
- 下面两条获得进程数
ffm_int old_nr_threads = omp_get_num_threads();
omp_set_num_threads(param.nr_threads);
下面的指令使多线程中的ffm_float t = wTx(xi, model);
ffm_float expnyt = exp(-y*t);结果,在tr_loss += log(1+expnyt);出合并然后继续下面的过线程
**#pragma omp parallel for schedule(static) reduction(+: tr_loss)**
<div align=center>
- libFFM中加速技术概述
<div align=center>
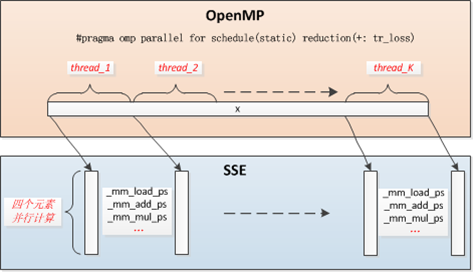
图7
**OpenMP**
代码被多个线程并行执行
<div align=center>
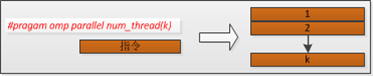
图8
for循环被发送到多个线程执行
<div align=center>
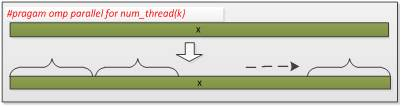
图9
for循环先被发送到多个线程,接着合并,然后再次被分发
<div align=center>

图10
对比加速图
<div align=center>

图11
**SSE**
SSE(Streaming SIMD Extensions)/AVX(Advanced Vector Extensions)是Intel公司设计,对其X86体系的SIMD扩展指令集,它基于SIMD向量化技术,增强X86多核处理器的图像和视频处理能力
常用指令如下
_mm_load_ps 从数组中读取向量到寄存器
_mm_store_ps 将寄存器中的向量存储到数组
_mm_add_ps 寄存器中的向量相加
_mm_sub_ps 寄存器中的向量相减
_mm_mul_ps 寄存器中的向量相乘
_mm_rsqrt_ps 寄存器中的向量开方倒数
<div align=center>

图12
发布者:全栈程序员-站长,转载请注明出处:https://javaforall.net/132189.html原文链接:https://javaforall.net



