
大数据建模流程之数据处理[通俗易懂]

大数据建模流程之数据处理[通俗易懂]原文链接数据是建模的基础,也是研究事物发展规律的材料。数据本身的可信度和处理的方式将直接决定模型的天花板在何处。一个太过杂乱的数据,无论用多么精炼的模型都无法解决数据的本质问题,也就造成了模型的效果不理想的效果。这也是我们目前所要攻克的壁垒。但是,目前我们市场对的数据或者科研的数据并不是完全杂乱无章的,基本都是有规律可循的,因此,用模型算法去进行科学的分析,可以主观情绪对决策的影响。所以数据是非常重要的一部分。那么,接下来我们就详细说一下数据的处理与分析。一.数据的基本特征当看到数据的时候,首要做的并

大家好,又见面了,我是你们的朋友全栈君。

原文链接
数据是建模的基础,也是研究事物发展规律的材料。数据本身的可信度和处理的方式将直接决定模型的天花板在何处。一个太过杂乱的数据,无论用多么精炼的模型都无法解决数据的本质问题,也就造成了模型的效果不理想的效果。这也是我们目前所要攻克的壁垒。但是,目前我们市场对的数据或者科研的数据并不是完全杂乱无章的,基本都是有规律可循的,因此,用模型算法去进行科学的分析,可以主观情绪对决策的影响。所以数据是非常重要的一部分。那么,接下来我们就详细说一下数据的处理与分析。
一.数据的基本特征
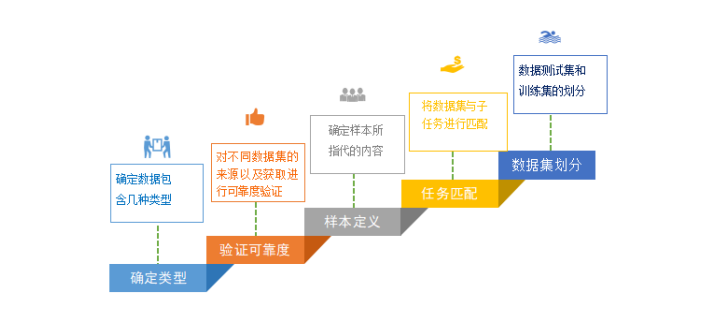
当看到数据的时候,首要做的并不是进行清洗或者特征工程,而是要观察数据所呈现的基本状态,以及进行数据与任务的匹配,这就需要我们之前所提到的业务常识与数据敏感度的能力了,只有数据完整的分析完整,才能够更为精准的做符合需求的特征工程(数据处理)的工作。数据的基本特征分析主要从以下几个方面进行:
在这里插入图片描述
1.确定类型:数据集的类型包括文本,音频,视频,图像,数值等多种形式交织而成,但是传入模型中的都是以数值形式呈现的,所以确定数据的类型,才可以确定用什么方法进行量化处理。
2.验证可靠度:由于数据的收集的方式不尽相同,数据来源的途径多种多样。所以数据的可信度判断也显得尤为重要。而数据可靠性校验得方法非常多。例如:根据收集途径判断,如果调查问卷也可根据问卷设计得可靠度进行判断,当然转化为数值后也可辅助一些模型进行精细校验等。采用何种方式,取决于获取数据得方式,数据类型以及项目得需求。
3.样本定义:需要确定样本得对应得每一个特征属性的内容是什么。例如:样本的容量,样本的具体内容,样本所包含的基本信息等。
4.任务匹配:在任务分析中我们把项目拆分成了小的子问题,这些问题有分类,回归,关联关系等。也就是每个问题的所达成的目标是不一样的,那么我们要从数据集中筛选出符合子问题的数据,也就是选好解决问题的原料,很多情况下是靠你的数据敏感度和业务常识进行判断的。
5.数据集的划分:由于模型搭建完成之后有一个训练与验证评估的过程,而目前最为简单的一种验证手段就是就是交叉验证,因此我们需要将数据集拆分成训练集和测试集,这一步仅仅确定训练集和测试集的比例关系,例如:70%的数据用于训练,30%的数据用于测试。

二. 数据的清洗与处理
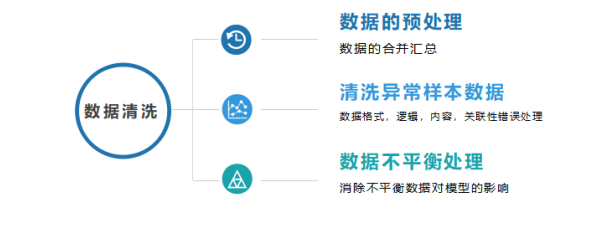
数据的清洗是一件非常繁琐且耗费时间的事情,基本可以占到一个工程的30%到50%的时间。并且数据的清洗很难有规律可循,基本上依托于你对数据的基本分析与数据敏感度。当然,当你看的数据够多,数据的清洗的经验也就越多,会为你今后哦搭建模型提供很多遍历,我们这里提供一些常见的清洗的点。
在这里插入图片描述
A. 数据的预处理:
1.由于数据的来源大多数是来源于多个途径,因此需要对数据进行合并;
2.选择数据处理工具:数据库或者python,spss等。
3.通过人工的方式去观察数据可能出现的问题。
B.清洗异常样本数据
清洗异常数据样本需要考虑到方方面面,通常情况下我们从以下方面:
1.处理格式或者内容错误:
首先,观察时间,日期,数值等是否出现格式不一致,进行修改整理;其次,注意开头,或者中间部分是否存在异常值;最后,看字段和内容是否一致。例如,姓名的内容是男,女。
2.逻辑错误清洗:
去重:通常我们收集的数据集中有一些数据是重复的,重复的数据会直接影响我们模型的结果,因此需要进行去重操作;
去除或者替换不合理的值:例如年龄突然某一个值是-1,这就属于不合理值,可用正常值进行替换或者去除;
修改矛盾内容:例如身份证号是91年的,年龄35岁,显然不合理,进行修改或者删除。
3.去除不要的数据:根据业务需求和业务常识去掉不需要的字段
4.关联性错误验证:由于数据来源是多个途径,所以存在一个id,进行不同的数据收集,可通过,id或者姓名进行匹配合并。

C.数据不平衡处理:改问题主要出现在分类模型中,由于正例与负例之间样本数量差别较大,造成分类结果样本量比较少的类别会大部分分错。因此需要进行数据不平衡处理。常用的方法有:上采样,下采样,数据权重复制,异常点检测等。不在一一阐述了。
在这里插入图片描述

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容, 请发送邮件至 举报,一经查实,本站将立刻删除。

发布者:全栈程序员-站长,转载请注明出处:https://javaforall.net/133439.html原文链接:https://javaforall.net

赞 (0)
全栈程序员-站长的头像全栈程序员-站长


相关推荐

  • Task2 计算电梯运行时间线程

    Task2 计算电梯运行时间线程Task2 计算电梯运行时间线程

    2022年4月24日
  • ebpf_ebpf需要修改内核吗

    ebpf_ebpf需要修改内核吗eBPF简史BPFBPF的全称是BerkeleyPacketFilter,顾名思义,这是一个用于过滤(filter)网络报文(packet)的架构。过滤(Filter):根据外界输入的规则过滤报文;复制(Copy):将符合条件的报文由内核空间复制到用户空间;?packet报文buffer百度百科在计算机领域,缓冲器指的是缓冲寄存器,它分输入缓冲器和输出缓冲器两种。前者的作用是将外设送来的数据暂时存放,以便处理器将它取走;后者的作用是用来暂时存放处理器送往外设的数据。有了数控缓冲器,

    2022年9月21日
  • 国产ARM核心工控主板介绍

    国产ARM核心板有哪些型号和作用?专业工控机品牌承诺,高性能,低功耗,提供专业定制。工控机箱的抗震:工控机箱在工作的时候,由于机箱内部的光驱、硬盘在高速运转的时候都会产生震动,而震动很容易导致光盘读错和硬盘磁道损坏以至丢失数据,所以工控机箱的抗震性也是我们机箱关键的一个结构设计方案。因为考虑到工控机箱的抗腐蚀、导电、导热等的内部要求,我们的工控机箱减震系统全部采用金属材料制成,这比起用橡胶材料做…

    2022年4月9日
  • Brocade 光纤交换机下zone划分 — 基础篇

    Brocade 光纤交换机下zone划分 — 基础篇###Brocade光纤交换机下zone划分—基础篇#Brocade5320/SAN交换机/zone划分/>>INTRO:zone的配置,在逻辑上将连接在SAN网络中的设备划分为不同区域,隔离网络中主机和设备。要实现这种SAN划分,可用在NameServer中隔离(Softwarezoning)或在数据转发时过滤数据包(Hardwarezonin

    2022年5月21日
  • linux配置jdk的环境变量(linux环境安装jdk)

    首先下载jdk在Linux中的安装包如rpm格式或tar.gz、tar.bz2格式(我用的是jdk-7u40-linux-i586.rpm即rpm格式)下载后进入Linux中jdk的下载目录然后安装jdk:rpm-ivhjdk-7u40-linux-i586.rpm如图:即安装成功此时查看java和javac命令的版本会出现如下情况java命令的版本和javac命令

    2022年4月17日
  • java打印数组常用的几种方法[通俗易懂]

    java打印数组常用的几种方法[通俗易懂]java打印数组常用的几种方法1、使用for循环最”朴实无华“的方法,却也是屡试不爽的方法,直接打印变量名不成,逐个遍历打印一定是可以的!int[]intArray={1,2,3};for(inti=0;i<intArray.length;i++)System.out.println(intArray[i]);如果是多维数组的话,使用多层for循环嵌套就可以了。2、使用Arrays.toString()或Arrays.deepToString()对

    2022年6月11日

发表回复

您的邮箱地址不会被公开。 必填项已用 * 标注

关注全栈程序员社区公众号



