
(深度学习)Pytorch之dropout训练

(深度学习)Pytorch之dropout训练(深度学习)Pytorch学习笔记之dropout训练Dropout训练实现快速通道:点我直接看代码实现Dropout训练简介在深度学习中,dropout训练时我们常常会用到的一个方法——通过使用它,我们可以可以避免过拟合,并增强模型的泛化能力。通过下图可以看出,dropout训练训练阶段所有模型共享参数,测试阶段直接组装成一个整体的大网络:那么,我们在深度学习的有力工具——Pytor…

大家好,又见面了,我是你们的朋友全栈君。

(深度学习)Pytorch学习笔记之dropout训练

Dropout训练实现快速通道:点我直接看代码实现

Dropout训练简介

在深度学习中,dropout训练时我们常常会用到的一个方法——通过使用它,我们可以可以避免过拟合,并增强模型的泛化能力。

通过下图可以看出,dropout训练训练阶段所有模型共享参数,测试阶段直接组装成一个整体的大网络:
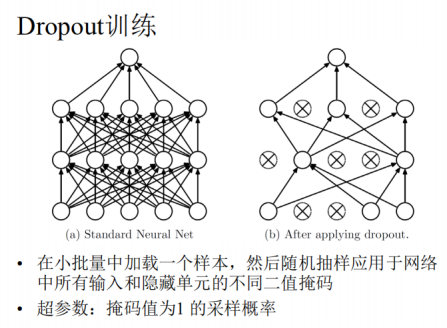
在这里插入图片描述

那么,我们在深度学习的有力工具——Pytorch中如何实现dropout训练呢?

易错大坑

网上查找到的很多实现都是这种形式的:

        out = F.dropout(out, p=0.5)

这种形式的代码非常容易误导初学者,给人带来很大的困扰:

  • 首先,这里的F.dropout实际上是torch.nn.functional.dropout的简写(很多文章都没说清这一点,就直接给个代码),我尝试了一下我的Pytorch貌似无法使用,可能是因为版本的原因。
  • 其次,torch.nn.functional.dropout()还有个大坑:F.dropout()相当于引用的一个外部函数,模型整体的training状态变化也不会引起F.dropout这个函数的training状态发生变化。因此,上面的代码实质上就相当于out = out

因此,如果你非要使用torch.nn.functional.dropout的话,推荐的正确方法如下(这里默认你已经import torch.nn as nn了):

       out = nn.functional.dropout(out, p=0.5, training=self.training)

推荐代码实现方法

这里更推荐的方法是:nn.Dropout(p),其中p是采样概率。nn.Dropout实际上是对torch.nn.functional.dropout的一个包装, 也将self.training传入了其中,可以有效避免前面所说的大坑。

下面给出一个三层神经网络的例子:

import torch.nn as nn


input_size = 28 * 28   
hidden_size = 500   
num_classes = 10    


# 三层神经网络
class NeuralNet(nn.Module):
    def __init__(self, input_size, hidden_size, num_classes):
        super(NeuralNet, self).__init__()
        self.fc1 = nn.Linear(input_size, hidden_size)  # 输入层到影藏层
        self.relu = nn.ReLU()
        self.fc2 = nn.Linear(hidden_size, num_classes)  # 影藏层到输出层
        self.dropout = nn.Dropout(p=0.5)  # dropout训练

    def forward(self, x):
        out = self.fc1(x)
        out = self.dropout(out)
        out = self.relu(out)
        out = self.fc2(out)
        return out
   

model = NeuralNet(input_size, hidden_size, num_classes)
model.train()
model.eval()

另外还有一点需要说明的是,训练阶段随机采样时需要用model.train(),而测试阶段直接组装成一个整体的大网络时需要使用model.eval():

  • 如果你二者都没使用的话,默认情况下实际上是相当于使用了model.train(),也就是开启dropout随机采样了——这样你如果你是在测试的话,准确率可能会受到影响。
  • 如果你不希望开启dropout训练,想直接以一个整体的大网络来训练,不需要重写一个网络结果,而只需要在训练阶段开启model.eval()即可。
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容, 请发送邮件至 举报,一经查实,本站将立刻删除。

发布者:全栈程序员-站长,转载请注明出处:https://javaforall.net/133466.html原文链接:https://javaforall.net

赞 (0)
全栈程序员-站长的头像全栈程序员-站长

相关推荐

  • python中字符串转成数字的几种方法[通俗易懂]

    python中字符串转成数字的几种方法[通俗易懂]在python列表操作中,面对需要把列表中的字符串转为礼拜的操作,无需强转,通过简单的几步就可以实现,本文介绍python中字符串转成数字的三种方法:1、使用join的方法;2、使用int函数将16进制字符串转化为10进制整数;3、使用列表生成式进行转换。方法一:使用join的方法num_list=[‘1′,’2′,’3’]str_list=”.join(num_str)#把列表中的元素连起来print(int(str_list))输出123方法二:使用int函数将16进制

    2022年10月22日
  • 虚拟机怎么安装vmware tools

    虚拟机怎么安装vmware tools这篇文章主要为大家详细介绍了VMwareWorkstation12安装Ubuntu和VMwareTools教程,具有一定的参考价值,感兴趣的小伙伴们可以参考一下之前我通过百度经验上的过程来安装Ubuntu16,但是每次安装的时候没有什么问题,就是安装好了Tools,也设置好了共享文件夹,但是在路径:/mnt/hgfs下每次都找不到共享文件夹。后来我研究了好久,应该是安装的时候…

    2022年5月25日
  • glusterfs分布式文件存储搭建和使用[通俗易懂]

    glusterfs分布式文件存储搭建和使用[通俗易懂]Glusterfs简介GlusterFS是Scale-Out存储解决方案Gluster的核心,它是一个开源的分布式文件系统,具有强大的横向扩展能力,通过扩展能够支持数PB存储容量和处理数千客户端。GlusterFS借助TCP/IP或InfiniBandRDMA网络将物理分布的存储资源聚集在一起,使用单一全局命名空间来管理数据。说起glusterfs可能比较陌生,可能大家更多的听说和使用的是NFS,GFS,HDFS之类的,这之中的NFS应该是使用最为广泛的,简单易于管理,但是NFS以及后边会说到..

    2022年5月30日
  • Android源码在线查看网站

    Android源码在线查看网站安卓社区https://www.androidos.net.cn/sourcecode(推荐)AndroidXRefhttp://androidxref.com/安卓特性(包括历史版本):https://developer.android.google.cn/

    2022年7月20日
  • 搭建邮件服务器 dns,搭建DNS服务器+邮件服务器[通俗易懂]

    一·搭建DNS服务器试验要求:完成DNS的正反向解析试验前准备:服务器192.168.203.201server1.example.com客户机192.168.203.202server2.example.com192.168.203.203database.example.com修改DNSnmclicmodifyeno16777736ipv4.dns8.8.8.8system…

    2022年4月9日
  • 2019 Python接口自动化测试框架实战开发(一)

    2019 Python接口自动化测试框架实战开发(一)说明:该篇博客是博主一字一码编写的,实属不易,请尊重原创,谢谢大家!目录一丶叙述二丶接口基础知识三丶接口测试工具四丶Fiddler的使用五丶unittest使用六丶mock服务入门到实战七丶接口自动化框架设计到开发一丶叙述1.项目介绍整个项目分为四个部分:接口基础丶接口开发丶Unittest与接口测试结合以及接口自动化框架从设计到开发接口基础包括:H…

    2022年4月30日

发表回复

您的邮箱地址不会被公开。 必填项已用 * 标注

关注全栈程序员社区公众号


