
大家好,又见面了,我是你们的朋友全栈君。
作者:張張張張
github地址:https://github.com/zhanghekai
【转载请注明出处,谢谢!】
【机器学习系列】之SVM硬间隔和软间隔
【机器学习系列】之SVM核函数和SMO算法
【机器学习系列】之支持向量回归SVR
【机器学习系列】之sklearn实现SVM代码
一、SVM回归模型概述
对于SVM回归模型:给定样本 D = { ( x 1 , y 1 ) , ( x 2 , y 2 ) , ⋯   , ( x m , y m ) } , y ∈ R D=\{(x_1,y_1),(x_2,y_2),\cdots ,(x_m,y_m)\}, y\in R D={
(x1,y1),(x2,y2),⋯,(xm,ym)},y∈R(由于是回归模型, y y y没有类别),我们的目标是让训练集中的每个点 ( x i , y i ) (x_i,y_i) (xi,yi)尽量拟合到一个线性模型 y i = w ⋅ ϕ ( x i ) + b y_i=w\cdot\phi(x_i)+b yi=w⋅ϕ(xi)+b。
对于一般的回归模型: 通常采用均方差作为损失函数。传统回归模型通常直接基于“模型输出”与“真实输出”之间的差别来计算损失,当切仅当二者完全相同时,损失才为 0 0 0。
对于SVM回归模型: “支持向量回归(Support Vector Regression)”需要定义一个常量 ϵ > 0 \epsilon>0 ϵ>0, ϵ \epsilon ϵ为能容忍“模型输出”与“真实输出”之间最多有 ϵ \epsilon ϵ的偏差。
- 如果 ∣ y i − w ⋅ ϕ ( x i ) − b ∣ ≤ ϵ |y_i-w\cdot\phi(x_i)-b|\leq\epsilon ∣yi−w⋅ϕ(xi)−b∣≤ϵ,则完全没有损失;
- 如果 ∣ y i − w ⋅ ϕ ( x i ) − b ∣ ≥ ϵ |y_i-w\cdot\phi(x_i)-b|\geq\epsilon ∣yi−w⋅ϕ(xi)−b∣≥ϵ,则对应的损失为 ∣ y i − w ⋅ ϕ ( x i ) − b ∣ − ϵ |y_i-w\cdot\phi(x_i)-b|-\epsilon ∣yi−w⋅ϕ(xi)−b∣−ϵ
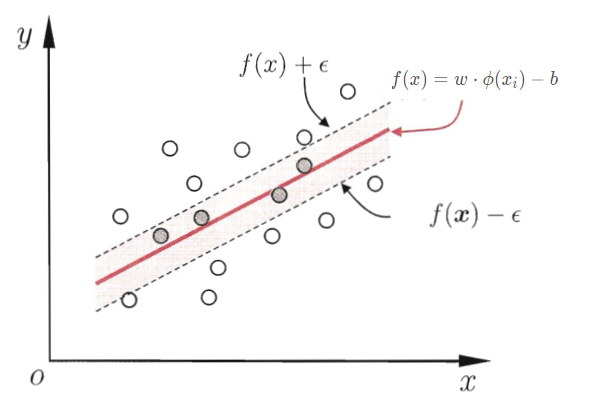
即: 仅当 f ( x ) = w ⋅ ϕ ( x i ) − b f(x)=w\cdot\phi(x_i)-b f(x)=w⋅ϕ(xi)−b与 y y y之间的差别绝对值大于 ϵ \epsilon ϵ时才计算损失。
如下图所示,这相当于以 f ( x ) f(x) f(x)为中心,构建了一个宽度为 2 ϵ 2\epsilon 2ϵ的间隔带,若训练样本落入此间隔带,则认为是被预测正确的。

综上所述,SVM回归模型的损失函数度量为:
e r r ( x i , y i ) = { 0 , ∣ y i − w ⋅ ϕ ( x i ) − b ∣ ≤ ϵ ∣ y i − w ⋅ ϕ ( x i ) − b ∣ − ϵ , ∣ y i − w ⋅ ϕ ( x i ) − b ∣ > ϵ err(x_i,y_i)=\begin{cases}0,\qquad\qquad\qquad\qquad\qquad\qquad |y_i-w\cdot\phi(x_i)-b|\leq\epsilon\\ |y_i-w\cdot\phi(x_i)-b|-\epsilon,\qquad\quad|y_i-w\cdot\phi(x_i)-b|>\epsilon \end{cases} err(xi,yi)={
0,∣yi−w⋅ϕ(xi)−b∣≤ϵ∣yi−w⋅ϕ(xi)−b∣−ϵ,∣yi−w⋅ϕ(xi)−b∣>ϵ
二、SVM回归模型目标函数
定义SVM回归模型目标函数为:
m i n ⎵ w , b    1 2 ∣ ∣ w ∣ ∣ 2 s . t . ∣ y i − w ⋅ ϕ ( x i ) − b ∣ ≤ ϵ    ( i = 1 , 2 , ⋯   , m ) \underbrace{min}_{w,b}\;\frac{1}{2}||w||^2\\ s.t. \quad|y_i-w\cdot\phi(x_i)-b|\leq\epsilon\;(i = 1,2,\cdots,m) w,b
min21∣∣w∣∣2s.t.∣yi−w⋅ϕ(xi)−b∣≤ϵ(i=1,2,⋯,m)
回归模型也可以对每个样本加入松弛变量,但由于这里 s . t . s.t. s.t.处用的是绝对值,实际上是两个不等式,即两边都需要松弛变量,定义松弛变量为 ξ ˇ 、 ξ ^ \check{\xi}、\hat{\xi} ξˇ、ξ^,加入松弛变量后的SVM回归模型的损失函数为:
m i n ⎵ w , b , ξ ˇ i , ξ ^ i    1 2 ∣ ∣ w ∣ ∣ 2 + C ∑ i = 1 m ( ξ ˇ i + ξ ^ i ) s . t . − ϵ − ξ ˇ i ≤ y i − w ⋅ ϕ ( x i ) − b ≤ ϵ + ξ ^ i ξ ˇ i ≥ 0 , ξ ^ i ≥ 0 ( i = 1 , 2 , ⋯   , m ) \underbrace{min}_{w,b,\check{\xi}_i,\hat{\xi}_i}\;\frac{1}{2}||w||^2+C\sum_{i=1}^{m}(\check{\xi}_i+\hat{\xi}_i)\\ s.t.\quad -\epsilon-\check{\xi}_i\leq y_i-w\cdot \phi(x_i)-b\leq\epsilon+\hat{\xi}_i\\ \check{\xi}_i\geq 0,\hat{\xi}_i\geq0\quad(i=1,2,\cdots,m) w,b,ξˇi,ξ^i
min21∣∣w∣∣2+Ci=1∑m(ξˇi+ξ^i)s.t.−ϵ−ξˇi≤yi−w⋅ϕ(xi)−b≤ϵ+ξ^iξˇi≥0,ξ^i≥0(i=1,2,⋯,m)
间隔带两侧的松弛程度可有所不同。
同SVM分类模型相似,可以用拉格朗日函数将目标优化哈数变成无约束的形式:
- 带求目标 f ( x ) = m i n ⎵ w , b , ξ ˇ i , ξ ^ i    1 2 ∣ ∣ w ∣ ∣ 2 + C ∑ i = 1 m ( ξ ˇ i + ξ ^ i ) f(x)=\underbrace{min}_{w,b,\check{\xi}_i,\hat{\xi}_i}\;\frac{1}{2}||w||^2+C\sum_{i=1}^{m}(\check{\xi}_i+\hat{\xi}_i) f(x)=w,b,ξˇi,ξ^i
min21∣∣w∣∣2+C∑i=1m(ξˇi+ξ^i) - 不等式约束:
- h 1 ( x ) = y i − w ⋅ ϕ ( x i ) − b − ϵ − ξ ^ i ≤ 0 h_1(x)=y_i-w\cdot\phi(x_i)-b- \epsilon-\hat{\xi}_i\leq0 h1(x)=yi−w⋅ϕ(xi)−b−ϵ−ξ^i≤0
- h 2 ( x ) = w ⋅ ϕ ( x i ) + b − y i − ϵ − ξ ˇ i ≤ 0 h_2(x)=w\cdot\phi(x_i)+b-y_i- \epsilon-\check{\xi}_i\leq0 h2(x)=w⋅ϕ(xi)+b−yi−ϵ−ξˇi≤0
- g 1 ( x ) = − ξ ˇ i ≤ 0 g_1(x)=-\check{\xi}_i\leq0 g1(x)=−ξˇi≤0
- g 2 ( x ) = − ξ ^ i ≤ 0 g_2(x)=-\hat{\xi}_i\leq0 g2(x)=−ξ^i≤0
- 拉格朗日乘子:
- α ^ i = ( α ^ 1 , α ^ 2 , ⋯   , α ^ m ) \hat{\alpha}_i = (\hat{\alpha}_1,\hat{\alpha}_2,\cdots,\hat{\alpha}_m) α^i=(α^1,α^2,⋯,α^m)
- α ˇ i = ( α ˇ 1 , α ˇ 2 , ⋯   , α ˇ m ) \check{\alpha}_i = (\check{\alpha}_1,\check{\alpha}_2,\cdots,\check{\alpha}_m) αˇi=(αˇ1,αˇ2,⋯,αˇm)
- μ ^ i = ( μ ^ 1 , μ ^ 2 , ⋯   , μ ^ m ) \hat{\mu}_i=(\hat{\mu}_1,\hat{\mu}_2,\cdots,\hat{\mu}_m) μ^i=(μ^1,μ^2,⋯,μ^m)
- μ ˇ i = ( μ ˇ 1 , μ ˇ 2 , ⋯   , μ ˇ m ) \check{\mu}_i=(\check{\mu}_1,\check{\mu}_2,\cdots,\check{\mu}_m) μˇi=(μˇ1,μˇ2,⋯,μˇm)
- 拉格朗日函数:
L ( w , b , ξ ˇ i , ξ ^ i , α ˇ i , α ^ i , μ ˇ i , μ ^ i ) = f ( x ) + α ^ i h 1 ( x ) + α ˇ i h 2 ( x ) + μ ˇ i g 1 ( x ) + μ ^ i g 2 ( x ) = 1 2 ∣ ∣ w ∣ ∣ 2 + C ∑ i = 1 m ( ξ ˇ i + ξ ^ i ) + ∑ i = 1 m α ^ i ( y i − w ⋅ ϕ ( x i ) − b − ϵ − ξ ^ i ) + ∑ i = 1 m α ˇ i ( x ⋅ ϕ ( x i ) + b − y i − ϵ − ξ ˇ ) − ∑ i = 1 m μ ˇ i ξ ˇ i − ∑ i = 1 m μ ^ i ξ ^ i L(w,b,\check{\xi}_i,\hat{\xi}_i,\check{\alpha}_i,\hat{\alpha}_i,\check{\mu}_i,\hat{\mu}_i)=f(x)+\hat{\alpha}_ih_1(x)+\check{\alpha}_ih_2(x)+\check{\mu}_ig_1(x)+\hat{\mu}_ig_2(x)\\ =\frac{1}{2}||w||^2+C\sum_{i=1}^{m}(\check{\xi}_i+\hat{\xi}_i)+\sum_{i=1}^{m}\hat{\alpha}_i(y_i-w\cdot\phi(x_i)-b-\epsilon-\hat{\xi}_i)\\ +\sum_{i=1}^{m}\check{\alpha}_i(x\cdot\phi(x_i)+b-y_i-\epsilon-\check{\xi})-\sum_{i=1}^{m}\check{\mu}_i\check{\xi}_i-\sum_{i=1}^{m}\hat{\mu}_i\hat{\xi}_i L(w,b,ξˇi,ξ^i,αˇi,α^i,μˇi,μ^i)=f(x)+α^ih1(x)+αˇih2(x)+μˇig1(x)+μ^ig2(x)=21∣∣w∣∣2+Ci=1∑m(ξˇi+ξ^i)+i=1∑mα^i(yi−w⋅ϕ(xi)−b−ϵ−ξ^i)+i=1∑mαˇi(x⋅ϕ(xi)+b−yi−ϵ−ξˇ)−i=1∑mμˇiξˇi−i=1∑mμ^iξ^i
SVM回归模型原始形式:
m i n ⎵ w , b , ξ ˇ i , ξ ^ i m a x ⎵ α ^ i ≥ 0 , α ˇ i ≥ 0 , μ ^ i ≥ 0 , μ ˇ i ≥ 0 L ( w , b , ξ ˇ i , ξ ^ i , α ˇ i , α ^ i , μ ˇ i , μ ^ i ) \underbrace{min}_{w,b,\check{\xi}_i,\hat{\xi}_i}\quad \underbrace{max}_{\hat{\alpha}_i\geq0,\check{\alpha}_i\geq0,\hat{\mu}_i\geq0,\check{\mu}_i\geq0}L(w,b,\check{\xi}_i,\hat{\xi}_i,\check{\alpha}_i,\hat{\alpha}_i,\check{\mu}_i,\hat{\mu}_i) w,b,ξˇi,ξ^i
minα^i≥0,αˇi≥0,μ^i≥0,μˇi≥0
maxL(w,b,ξˇi,ξ^i,αˇi,α^i,μˇi,μ^i)
和SVM分类模型一样,这个优目标也满足KKT条件,可以通过拉格朗日对偶将优化问题转化为等价的对偶问题来求解:
m a x ⎵ α ^ i ≥ 0 , α ˇ i ≥ 0 , μ ^ i ≥ 0 , μ ˇ i ≥ 0 m i n ⎵ w , b , ξ ˇ i , ξ ^ i L ( w , b , ξ ˇ i , ξ ^ i , α ˇ i , α ^ i , μ ˇ i , μ ^ i ) \underbrace{max}_{\hat{\alpha}_i\geq0,\check{\alpha}_i\geq0,\hat{\mu}_i\geq0,\check{\mu}_i\geq0}\quad \underbrace{min}_{w,b,\check{\xi}_i,\hat{\xi}_i}L(w,b,\check{\xi}_i,\hat{\xi}_i,\check{\alpha}_i,\hat{\alpha}_i,\check{\mu}_i,\hat{\mu}_i) α^i≥0,αˇi≥0,μ^i≥0,μˇi≥0
maxw,b,ξˇi,ξ^i
minL(w,b,ξˇi,ξ^i,αˇi,α^i,μˇi,μ^i)
可以先求优化函数对于 w , b , ξ ˇ i , ξ ^ i w,b,\check{\xi}_i,\hat{\xi}_i w,b,ξˇi,ξ^i的极小值,接着再求拉格朗日乘子 α ^ i , α ˇ i , μ ^ i , μ ˇ i \hat{\alpha}_i,\check{\alpha}_i,\hat{\mu}_i,\check{\mu}_i α^i,αˇi,μ^i,μˇi的极大值。
三、SVM回归模型目标函数求解
首先来求优化函数对于 w , b , ξ ˇ i , ξ ^ i w,b,\check{\xi}_i,\hat{\xi}_i w,b,ξˇi,ξ^i的极小值,这个可以通过对 L L L求偏导数求得:
∂ L ∂ w = 0    ⟹    w = ∑ i = 1 m ( α ^ i − α ˇ i ) ϕ ( x i ) ∂ L ∂ b = 0    ⟹    ∑ i = 1 m ( α ^ i − α ˇ i ) = 0 ∂ L ∂ ξ ˇ i = 0    ⟹    C = α ˇ i + μ ˇ i ∂ L ∂ ξ ^ i = 0    ⟹    C = α ^ i + μ ^ i \frac{\partial L}{\partial w}=0\implies w=\sum_{i=1}^{m}(\hat{\alpha}_i-\check{\alpha}_i)\phi(x_i)\\[1ex] \frac{\partial L}{\partial b}=0\implies\sum_{i=1}^{m}(\hat{\alpha}_i-\check{\alpha}_i)=0\\[1ex] \frac{\partial L}{\partial \check{\xi}_i}=0\implies C=\check{\alpha}_i+\check{\mu}_i\\[1ex] \frac{\partial L}{\partial \hat{\xi}_i}=0\implies C=\hat{\alpha}_i+\hat{\mu}_i ∂w∂L=0⟹w=i=1∑m(α^i−αˇi)ϕ(xi)∂b∂L=0⟹i=1∑m(α^i−αˇi)=0∂ξˇi∂L=0⟹C=αˇi+μˇi∂ξ^i∂L=0⟹C=α^i+μ^i
将上述4个式子带入 L ( w , b , ξ ˇ i , ξ ^ i , α ˇ i , α ^ i , μ ˇ i , μ ^ i ) L(w,b,\check{\xi}_i,\hat{\xi}_i,\check{\alpha}_i,\hat{\alpha}_i,\check{\mu}_i,\hat{\mu}_i) L(w,b,ξˇi,ξ^i,αˇi,α^i,μˇi,μ^i),消去 w , b , ξ ˇ i , ξ ^ i w,b,\check{\xi}_i,\hat{\xi}_i w,b,ξˇi,ξ^i。
m a x ⎵ α ˇ i , α ^ i ∑ i = 1 m ( y i ( α ^ i − α ˇ i ) − ϵ ( α ^ i + α ˇ i ) ) − 1 2 ∑ i = 1 m ∑ j = 1 m ( α ^ i − α ˇ i ) ( α ^ j − α ˇ j ) κ i j s . t . ∑ i = 1 m ( α ^ i − α ˇ i ) = 0 0 < α i ˇ < C ( i = 1 , 2 , ⋯   , m ) 0 < α ^ i < C ( i = 1 , 2 , ⋯   , m ) \underbrace{max}_{\check{\alpha}_i,\hat{\alpha}_i}\quad\sum_{i=1}^{m}(y_i(\hat{\alpha}_i-\check{\alpha}_i)-\epsilon(\hat{\alpha}_i+\check{\alpha}_i))-\frac{1}{2}\sum_{i=1}^{m}\sum_{j=1}^{m}(\hat{\alpha}_i-\check{\alpha}_i)(\hat{\alpha}_j-\check{\alpha}_j)\kappa_{ij}\\ s.t. \quad \sum_{i=1}^{m}(\hat{\alpha}_i-\check{\alpha}_i)=0\\ 0<\check{\alpha_i}<C\quad(i=1,2,\cdots,m)\\ 0<\hat{\alpha}_i<C \quad(i=1,2,\cdots,m) αˇi,α^i
maxi=1∑m(yi(α^i−αˇi)−ϵ(α^i+αˇi))−21i=1∑mj=1∑m(α^i−αˇi)(α^j−αˇj)κijs.t.i=1∑m(α^i−αˇi)=00<αiˇ<C(i=1,2,⋯,m)0<α^i<C(i=1,2,⋯,m)
对目标函数取负号,得到求极小值的目标函数如下:
m i n ⎵ α ^ i , α ˇ i 1 2 ∑ i = 1 m ∑ j = 1 m ( α ^ i − α ˇ i ) ( α ^ j − α ˇ j ) κ i j − ∑ i = 1 m ( y i ( α ^ i − α ˇ i ) − ϵ ( α ^ i + α ˇ i ) ) s . t . ∑ i = 1 m ( α ^ i − α ˇ i ) = 0 0 < α i ˇ < C ( i = 1 , 2 , ⋯   , m ) 0 < α ^ i < C ( i = 1 , 2 , ⋯   , m ) \underbrace{min}_{\hat{\alpha}_i,\check{\alpha}_i}\quad\frac{1}{2}\sum_{i=1}^{m}\sum_{j=1}^{m}(\hat{\alpha}_i-\check{\alpha}_i)(\hat{\alpha}_j-\check{\alpha}_j)\kappa_{ij}-\sum_{i=1}^{m}(y_i(\hat{\alpha}_i-\check{\alpha}_i)-\epsilon(\hat{\alpha}_i+\check{\alpha}_i))\\ s.t. \quad \sum_{i=1}^{m}(\hat{\alpha}_i-\check{\alpha}_i)=0\\ 0<\check{\alpha_i}<C\quad(i=1,2,\cdots,m)\\ 0<\hat{\alpha}_i<C \quad(i=1,2,\cdots,m) α^i,αˇi
min21i=1∑mj=1∑m(α^i−αˇi)(α^j−αˇj)κij−i=1∑m(yi(α^i−αˇi)−ϵ(α^i+αˇi))s.t.i=1∑m(α^i−αˇi)=00<αiˇ<C(i=1,2,⋯,m)0<α^i<C(i=1,2,⋯,m)
对于这个目标函数,依然可以用SMO算法来求出对应的 α i ˇ , α i ^ \check{\alpha_i},\hat{\alpha_i} αiˇ,αi^,进而求出回归模型系数 w , b w,b w,b。
四、SVM回归模型系数的系数的稀疏性
上述过程需满足KKT条件,即要求:
{ α ^ i ( y i − w ⋅ ϕ ( x i ) − b − ϵ − ξ ^ i ) = 0 α ˇ i ( x ⋅ ϕ ( x i ) + b − y i − ϵ − ξ ˇ i ) = 0 α ˇ i α ^ i = 0 , ξ ˇ i ξ ^ i = 0 ( C − α ˇ i ) ξ ˇ i = 0 , ( C − α ^ i ) ξ ^ i = 0 \begin{cases}\hat{\alpha}_i(y_i-w\cdot\phi(x_i)-b-\epsilon-\hat{\xi}_i)=0\\ \check{\alpha}_i(x\cdot\phi(x_i)+b-y_i-\epsilon-\check{\xi}_i)=0\\ \check{\alpha}_i\hat{\alpha}_i=0,\quad\check{\xi}_i\hat{\xi}_i=0\\ (C-\check{\alpha}_i)\check{\xi}_i=0,\quad (C-\hat{\alpha}_i)\hat{\xi}_i=0 \end{cases} ⎩⎪⎪⎪⎨⎪⎪⎪⎧α^i(yi−w⋅ϕ(xi)−b−ϵ−ξ^i)=0αˇi(x⋅ϕ(xi)+b−yi−ϵ−ξˇi)=0αˇiα^i=0,ξˇiξ^i=0(C−αˇi)ξˇi=0,(C−α^i)ξ^i=0
由KKT条件知:
- 当且仅当 y i − w ⋅ ϕ ( x i ) − b − ϵ − ξ ^ i = 0 y_i-w\cdot\phi(x_i)-b-\epsilon-\hat{\xi}_i=0 yi−w⋅ϕ(xi)−b−ϵ−ξ^i=0时, α ^ i \hat{\alpha}_i α^i能取非零值;
- 当且仅当 x ⋅ ϕ ( x i ) + b − y i − ϵ − ξ ˇ i = 0 x\cdot\phi(x_i)+b-y_i-\epsilon-\check{\xi}_i=0 x⋅ϕ(xi)+b−yi−ϵ−ξˇi=0时, α ˇ i \check{\alpha}_i αˇi能取非零值;
- 总结: 仅当样本 ( x i , y i ) (x_i,y_i) (xi,yi)不落入 ϵ − \epsilon- ϵ−间隔带中,相应的 α ˇ i \check{\alpha}_i αˇi和 α ^ i \hat{\alpha}_i α^i才能取非零值。
- 约束 y i − w ⋅ ϕ ( x i ) − b − ϵ − ξ ^ i = 0 y_i-w\cdot\phi(x_i)-b-\epsilon-\hat{\xi}_i=0 yi−w⋅ϕ(xi)−b−ϵ−ξ^i=0和 x ⋅ ϕ ( x i ) + b − y i − ϵ − ξ ˇ i = 0 x\cdot\phi(x_i)+b-y_i-\epsilon-\check{\xi}_i=0 x⋅ϕ(xi)+b−yi−ϵ−ξˇi=0不能同时成立,因此 α ˇ i \check{\alpha}_i αˇi和 α ^ i \hat{\alpha}_i α^i中至少有一个为 0 0 0。
- 落在 ϵ − \epsilon- ϵ−间隔带中的样本都满足 α ˇ i = 0 \check{\alpha}_i=0 αˇi=0且 α ^ i = 0 \hat{\alpha}_i=0 α^i=0。
最终SVM线性回归的解形式如下:
f ( x ) = ∑ i = 1 m ( α ^ i − α ˇ i ) κ ( x , x i ) + b f(x)=\sum_{i=1}^{m}(\hat{\alpha}_i-\check{\alpha}_i)\kappa(x,x_i)+b f(x)=i=1∑m(α^i−αˇi)κ(x,xi)+b
其中 κ ( x i , x j ) = ϕ ( x i ) T ϕ ( x j ) \kappa(x_i,x_j)=\phi(x_i)^T\phi(x_j) κ(xi,xj)=ϕ(xi)Tϕ(xj)为核函数。
能使 f ( x ) f(x) f(x)中的 ( α ^ i − α ˇ i ) (\hat{\alpha}_i-\check{\alpha}_i) (α^i−αˇi)不等于 0 0 0的样本即为SVR的支持向量,它们必落在 ϵ − \epsilon- ϵ−间隔带之外。 显然,SVR的支持向量仅是训练样本的一部分。
由KKT条件可以看出,对每个样本 ( x i , y i ) (x_i,y_i) (xi,yi)都有: ( C − α ˇ i ) ξ ˇ i = 0 (C-\check{\alpha}_i)\check{\xi}_i=0 (C−αˇi)ξˇi=0且 α ˇ i ( x ⋅ ϕ ( x i ) + b − y i − ϵ − ξ ˇ i ) = 0 \check{\alpha}_i(x\cdot\phi(x_i)+b-y_i-\epsilon-\check{\xi}_i)=0 αˇi(x⋅ϕ(xi)+b−yi−ϵ−ξˇi)=0。于是,在得到 α ˇ i \check{\alpha}_i αˇi后,若 0 < α ˇ i < C 0<\check{\alpha}_i<C 0<αˇi<C,必有 ξ i ˇ = 0 \check{\xi_i}=0 ξiˇ=0,则 x ⋅ ϕ ( x i ) + b − y i − ϵ = 0 x\cdot\phi(x_i)+b-y_i-\epsilon=0 x⋅ϕ(xi)+b−yi−ϵ=0,进而有:
b = y i + ϵ − ∑ j = 1 m ( α ^ j − α ˇ j ) x j T x i b=y_i+\epsilon-\sum_{j=1}^{m}(\hat{\alpha}_j-\check{\alpha}_j)x_j^Tx_i b=yi+ϵ−j=1∑m(α^j−αˇj)xjTxi
因此,通过SMO算法得到 α ˇ i \check{\alpha}_i αˇi后,可任意选取满足 0 < α ˇ i < C 0<\check{\alpha}_i<C 0<αˇi<C的样本通过上式求得 b b b。实践中常采用一种更鲁棒的办法:选取多个(或所有)满足条件 0 < α ˇ i < C 0<\check{\alpha}_i<C 0<αˇi<C的样本求解b后取平均值。
【参考文献】
- 刘建平 博客园:https://www.cnblogs.com/pinard/
- 周志华 《机器学习》
发布者:全栈程序员-站长,转载请注明出处:https://javaforall.net/137537.html原文链接:https://javaforall.net



