
python实现简单爬虫功能[通俗易懂]

python实现简单爬虫功能[通俗易懂]python实现简单爬虫功能,抓取百度贴吧页面中的图片,下载到本地。

大家好,又见面了,我是你们的朋友全栈君。


  在我们日常上网浏览网页的时候,经常会看到一些好看的图片,我们就希望把这些图片保存下载,或者用户用来做桌面壁纸,或者用来做设计的素材。

  我们最常规的做法就是通过鼠标右键,选择另存为。但有些图片鼠标右键的时候并没有另存为选项,还有办法就通过就是通过截图工具截取下来,但这样就降低图片的清晰度。好吧~!其实你很厉害的,右键查看页面源代码。

  我们可以通过python 来实现这样一个简单的爬虫功能,把我们想要的代码爬取到本地。下面就看看如何使用python来实现这样一个功能。


一,获取整个页面数据


首先我们可以先获取要下载图片的整个页面信息。

getjpg.py

#coding=utf-8
import urllib def getHtml(url): page = urllib.urlopen(url) html = page.read() return html html = getHtml("http://tieba.baidu.com/p/2738151262") print html

  Urllib 模块提供了读取web页面数据的接口,我们可以像读取本地文件一样读取www和ftp上的数据。首先,我们定义了一个getHtml()函数:

  urllib.urlopen()方法用于打开一个URL地址。

  read()方法用于读取URL上的数据,向getHtml()函数传递一个网址,并把整个页面下载下来。执行程序就会把整个网页打印输出。


二,筛选页面中想要的数据


  Python 提供了非常强大的正则表达式,我们需要先要了解一点python 正则表达式的知识才行。

http://www.cnblogs.com/fnng/archive/2013/05/20/3089816.html


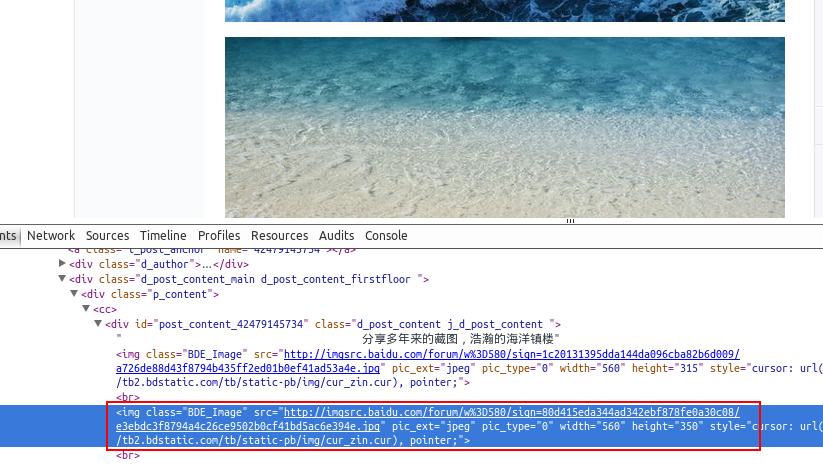
假如我们百度贴吧找到了几张漂亮的壁纸,通过到前段查看工具。找到了图片的地址,如:src=”http://imgsrc.baidu.com/forum……jpg”pic_ext=”jpeg”
python实现简单爬虫功能[通俗易懂]

修改代码如下:

import re import urllib def getHtml(url): page = urllib.urlopen(url) html = page.read() return html def getImg(html): reg = r'src="(.+?\.jpg)" pic_ext' imgre = re.compile(reg) imglist = re.findall(imgre,html) return imglist html = getHtml("http://tieba.baidu.com/p/2460150866") print getImg(html)

  我们又创建了getImg()函数,用于在获取的整个页面中筛选需要的图片连接。re模块主要包含了正则表达式:

  re.compile() 可以把正则表达式编译成一个正则表达式对象.

  re.findall() 方法读取html 中包含 imgre(正则表达式)的数据。

    运行脚本将得到整个页面中包含图片的URL地址。


三,将页面筛选的数据保存到本地


把筛选的图片地址通过for循环遍历并保存到本地,代码如下:


#coding=utf-8
import urllib import re def getHtml(url): page = urllib.urlopen(url) html = page.read() return html def getImg(html): reg = r'src="(.+?\.jpg)" pic_ext' imgre = re.compile(reg) imglist = re.findall(imgre,html) x = 0 for imgurl in imglist: urllib.urlretrieve(imgurl,'%s.jpg' % x) x+=1 html = getHtml("http://tieba.baidu.com/p/2460150866") print getImg(html)


  这里的核心是用到了urllib.urlretrieve()方法,直接将远程数据下载到本地。

  通过一个for循环对获取的图片连接进行遍历,为了使图片的文件名看上去更规范,对其进行重命名,命名规则通过x变量加1。保存的位置默认为程序的存放目录。

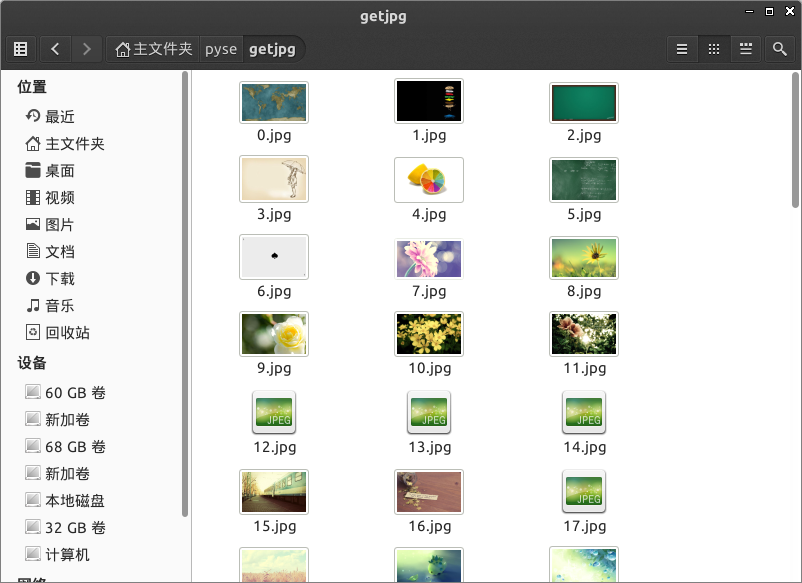
程序运行完成,将在目录下看到下载到本地的文件。
 

python实现简单爬虫功能[通俗易懂]


版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容, 请发送邮件至 举报,一经查实,本站将立刻删除。

发布者:全栈程序员-站长,转载请注明出处:https://javaforall.net/155846.html原文链接:https://javaforall.net

赞 (0)
全栈程序员-站长的头像全栈程序员-站长

相关推荐

  • pythonwhile冒泡排序_python冒泡排序

    pythonwhile冒泡排序_python冒泡排序#冒泡法排序ListBubbleSort.pyfish_records=[18,8,7,2,3,6,1,1]#原始排序i=0#循环控制变量compare=0#比较元素初始值fish_len=len(fish_records)#获取列表长度whileij=1…

    2022年10月16日
  • eclipse怎么导入一个Java项目(莫要错过,最详细教程!)

    eclipse怎么导入一个Java项目(莫要错过,最详细教程!)对于eclipse软件,常规的打开文件方法是无法打开一个项目的,那么怎样导入一个java项目呢?方法如下第一步在电脑打开eclipse软件,点击file->Import,如下图所示:第二步选择General->ExistingProjectsintoworkspace,点击next,如下图所示:第三步点击选择要导入的项目路径,选好,点击finish,如下图所示:到此为止,已经导入成功了如果对你产生了帮助,那么请给博主一个小小的赞哦。…

    2022年7月7日
  • 防欺诈盗号,请勿支付或输入qq密码

    防欺诈盗号,请勿支付或输入qq密码不知道读者是否留意过这种情况:通过微信内置浏览器打开带有表单的页面,点击其中任何一个表单项都会在窗口顶部显示红色背景的防欺诈警告信息“防欺诈盗号,请勿支付或输入qq密码”,如下图所示  1)申请书下载地址:https://mp.weixin.qq.com/htmledition/res/urlrequest.doc。2)申请人主体材料包括:申请人的姓名(…

    2022年7月15日
  • Linux futex_centos8 pip

    Linux futex_centos8 pipPriorityInheritance,优先级继承,是解决优先级反转的一种办法。一个经典的例子:A/B/C三个实时进程,优先级A>B>C。C持有a锁,而A等待a锁被挂起。原本C释放a锁之后,A进程就可以继续执行的,但是偏偏有个比C优先级高的B进程存在,导致C得不到运行,也就没法释放a锁,从而导致A进程一直挂起。从整体上看,进程B虽然比A优…

    2022年9月16日
  • java取整四舍五入_java取整和四舍五入

    java取整四舍五入_java取整和四舍五入Contents12345Math类里的两个方法:staticdouble(doublea)返回最大的(最接近正无穷大)double值,该值小于等于参数,并等于某个整数。staticdoubleceil(doublea)返回最小的(最接近负无穷大)double值,该值大于等于参数,并等于某个整数。123456789101112131415161718192021222324252627…

    2022年5月21日
  • 什么是MVC三层架构?「建议收藏」

    什么是MVC三层架构?「建议收藏」1.1、什么是MVC MVC是模型(Model)、视图(View)、控制器(Controller)的简写,是一种软件设计规范。 是将业务逻辑、数据、显示分离的方法来组织代码。 MVC主要作用是降低了视图与业务逻辑间的双向偶合。 MVC不是一种设计模式,MVC是一种架构模式。当然不同的MVC存在差异。 Model(模型):数据模型,提供要展示的数据,因此包含数据和行为,可以认为是领域模型或JavaBean组件(包含数据和行为),不过现在一般都分离开来:ValueObj

    2022年6月25日

发表回复

您的邮箱地址不会被公开。 必填项已用 * 标注

关注全栈程序员社区公众号


