
大家好,又见面了,我是你们的朋友全栈君。
R语言doParallel+foreach 并行计算初试牛刀
前言
因为我学习的需要,要做模拟,需要用到前人写好的函数,然后又需要大量的循环(模拟一百次,每次生成500条曲线,450条训练,50条做预测)。每次做个运算要半个小时左右,实在是受不了了之后,找了很多的博客和也下载了cran的帮助文档来看。最后终于一遍遍的试出来了。
包的安装
首先需要将doParallel的包安装带上去,而doParallel的包基于foreach,iterators和parallel,parallel是R语言内置的包,所以要实际安装的包总共有三个。
正文
首先还是检测电脑的核心数,既然要搞并行计算,肯定要利用多核心;要检测电脑核心数,就需要用到detecCores()函数,对于Windows系统下的intel I5和intel I7处理器,一般要用detecCores(logical = F)来获得实际的物理核心。我用的是学校配备的8700,所以检测出来的就是6个。
library(doParallel)
library(foreach)
cl.cores = detecCores(logical = F)
cl <- makeCluster(cl.cores)
registerDoparallel(cl)  # 我调用了所有的核心,也可以(cl-1),少调用一个核心
以上是前期设置,下面是我自己模拟代码的部分展示,其中要注意的是我的ffunopare.knn.gcv函数调用了内存中另外两个函数,分别是semmimetric.pca 和quadratic,这个很重要。
func <- function(ii){
    result.pred <- ffunopare.knn.gcv(a,b,v,5,kind.of.kernel="quadratic",semimetric="pca")
    Response.predicted <- result.pred$Predicted.values
    ase.reg[i] <- round(sum((pi/3)*(1/100)*(abs(Response2-Response.predicted))),8)
    }
  RE<-mean(ase.reg)
  return(RE)
}
参数解读(参考链接1 )
-
%do%: 严格按照顺序执行任务(所以,也就非并行计算),%dopar%并行执行任务,%do%时候就像sapply或lapply,%dopar%就是并行启动器 -
.combine:运算之后结果的显示方式,default是list,“c”返回vector, cbind和rbind返回矩阵,”+“和”“可以返回rbind之后的“+”或者“”,帮你把数据整合起来,太良心了!!
–.init:.combine函数的第一个变量 -
.final:返回最后结果 -
.inorder:TRUE则返回和原始输入相同顺序的结果(对结果的顺序要求严格的时候),FALSE返回没有顺序的结果(可以提高运算效率)。这个参数适合于设定对结果顺序没有需求的情况。 -
.muticombine:设定.combine函数的传递参数,default是FALSE表示其参数是2,TRUE可以设定多个参数 -
.maxcombine:设定.combine的最大参数 -
.errorhandling:如果循环中出现错误,对错误的处理方法 -
.packages:指定在%dopar%运算过程中依赖的package(%do%会忽略这个选项),用于并行一些机器学习算法。 -
.export:在编译函数的时候需要预先加载一些内容进去,类似parallel的clusterExport
下面就是并行计算的主函数部分,也就是调用foreach的部分。#因为ffunopare.knn.gcv要加载内存中的semimetric.pca和quadratic两个函数,所以要在.export参数中设置一下,有文章说要用list,笔者没有用,不过下面参考链接[1]中会给出。要注意,参数要使用%dopar%而不能使用%do%,后者就不是并行计算了。
x <- foreach(ii=1:100,.combine = "c",.export = c("semimetric.pca","quadratic"))%dopar% func(ii)
最后要做的就是关闭集群
stopCluster(cl)
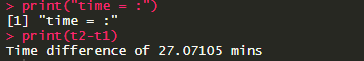
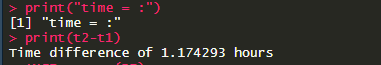
最后奉上结果,如下图,左图为并行计算,右图为非并行计算,也就是使用最基础的for循环的结果。请不要吐槽我的print(time)
| 并行计算 | for循环 |
|---|---|
  |
 |
参考链接
- R︱foreach+doParallel并行+联用迭代器优化内存+并行机器学习算法.
- R︱并行计算以及提高运算效率的方式(parallel包、clusterExport函数、SupR包简介)
- R语言的并行运算(CPU多核)
发布者:全栈程序员-站长,转载请注明出处:https://javaforall.net/161821.html原文链接:https://javaforall.net



