
背景:
在“批量导入数据到Redis” 中已经介绍了将得到的itema item1:score1,item2:score2…批量导入到Redis数据库中。本文的工作是运用机器学习LR技术,抽取相应的特征,进行点击率的估计。
点击率(Click-Through-Rate, CTR) 预估点击率 (predict CTR, pCTR) 是指对某个系统将要在某个情形下展现前, 系统预估其可能的点击概率
步骤一:
学习、训练sklearn中自带的LR模型,参考这里
代码如下:(lr.py)
import sys
import numpy as np

from sklearn import datasets
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression

def load_data():
       input_data = datasets.load_iris()
       x_train, x_test, y_train, y_test = train_test_split(input_data.data, input_data.target, test_size = 0.2, random_state = 0)
       return x_train, x_test, y_train, y_test


def main():
        print("---------")
        x_train, x_test, y_train, y_test = load_data()
        model = LogisticRegression()
        model.fit(x_train, y_train)

        print("w: ", model.coef_)
        print("b: ", model.intercept_)
        print("precision: ", model.score(x_test, y_test))
        print("MSE: ", np.mean((model.predict(x_test) - y_test) ** 2))

if __name__ == '__main__':
        main()
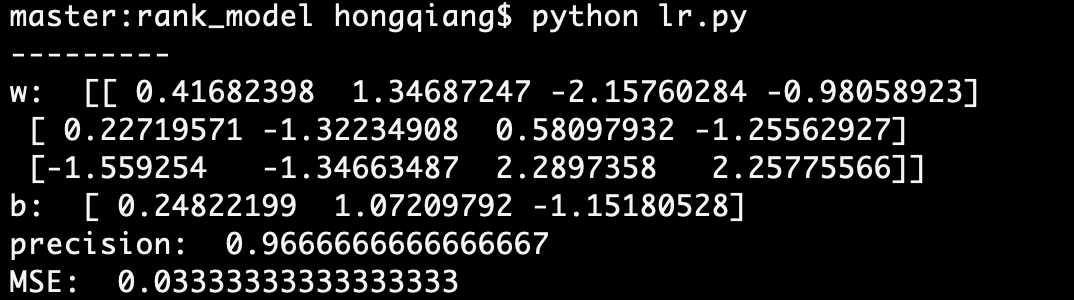
执行结果如图1所示:

上文用到的训练数据集也是sklearn中自带的iris数据集。
该数据集测量了所有150个样本的4个特征,分别是:
- sepal length(花萼长度)
- sepal width(花萼宽度)
- petal length(花瓣长度)
- petal width(花瓣宽度)
下图2为iris数据集部分数据示意图:
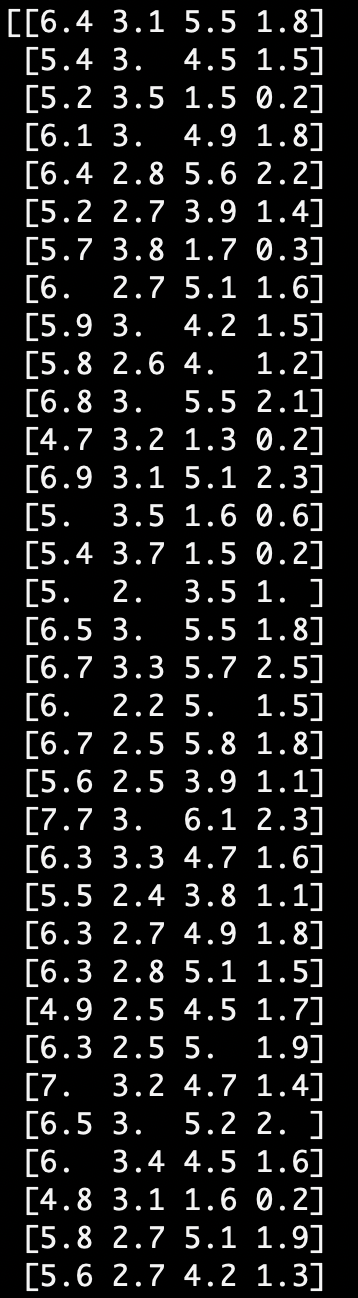
通过分析iris数据集可得,iris数据集中的特征矩阵为稠密矩阵,由此可见,如果想直接运用sklearn自带的LR算法进行模型训练,则首先要保证输入的数据集的特征为稠密矩阵的形式。不幸的是,现实中很多情况下的数据集的特征一般为稀疏矩阵形式,如下图3所示:(a8a)
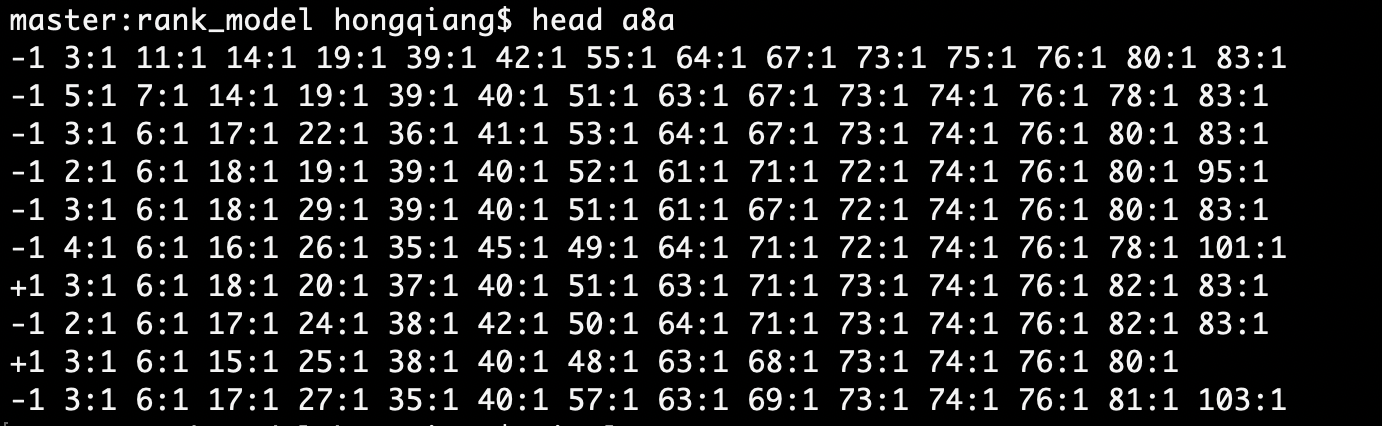
说明: 上图3中数据集的第一列代表数据的分类标签,之后的为特征和对应的评分
步骤二:
将图3所示数据集转化为适合sklearn中LR输入的稠密矩阵形式
代码如下:(lr.py)
import sys
import numpy as np

from scipy.sparse import csr_matrix
from sklearn import datasets
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression

#外部输入数据集
data_in = sys.argv[1]

#重写数据集加载函数
def load_data():
		#特征的行号
        fea_row_list = []
        #特征的列号
        fea_col_list = []
        #标签列表
        target_list = []
        #特征对应的评分
        data_list = []

		#行索引
        row_index = 0
        #最大的特征编号
        max_col = 0

		#一行行读数据并解析
        with open(data_in, 'r') as fd:
                for line in fd:
                        ss = line.strip().split(' ')
                        label = ss[0]
                        fea = ss[1:]

                        target_list.append(int(label))

                        for fea_score in fea:
                                sss = fea_score.strip().split(':')
                                if len(sss) != 2:
                                        continue
                                feature, score = sss

                                fea_row_list.append(row_index)
                                fea_col_list.append(int(feature))
                                data_list.append(float(score))

                                if int(feature) > max_col:
                                        max_col = int(feature)
                        row_index += 1

        row = np.array(fea_row_list)
        col = np.array(fea_col_list)
        data = np.array(data_list)

        fea_datasets = csr_matrix((data, (row, col)), shape=(row_index, max_col+1)).toarray()
        #当特征维度过大时,选下面这种方式(加toarray()和不加都是对的),内存不容易爆掉
        #fea_datasets = csr_matrix((data, (row, col)), shape=(row_index, max_col+1))

        x_train, x_test, y_train, y_test = train_test_split(fea_datasets, target_list, test_size = 0.2, random_state = 0)
        return x_train, x_test, y_train, y_test

#自带iris数据集加载函数
#def load_data():
#       input_data = datasets.load_iris()
#
#       x_train, x_test, y_train, y_test = train_test_split(input_data.data, input_data.target, test_size = 0.2, random_state = 0)
#
#       return x_train, x_test, y_train, y_test


def main():
        print("---------")
        x_train, x_test, y_train, y_test = load_data()

        model = LogisticRegression()
        model.fit(x_train, y_train)

        print("w: ", model.coef_)
        print("b: ", model.intercept_)
        print("precision: ", model.score(x_test, y_test))
        print("MSE: ", np.mean((model.predict(x_test) - y_test) ** 2))

if __name__ == '__main__':
        main()
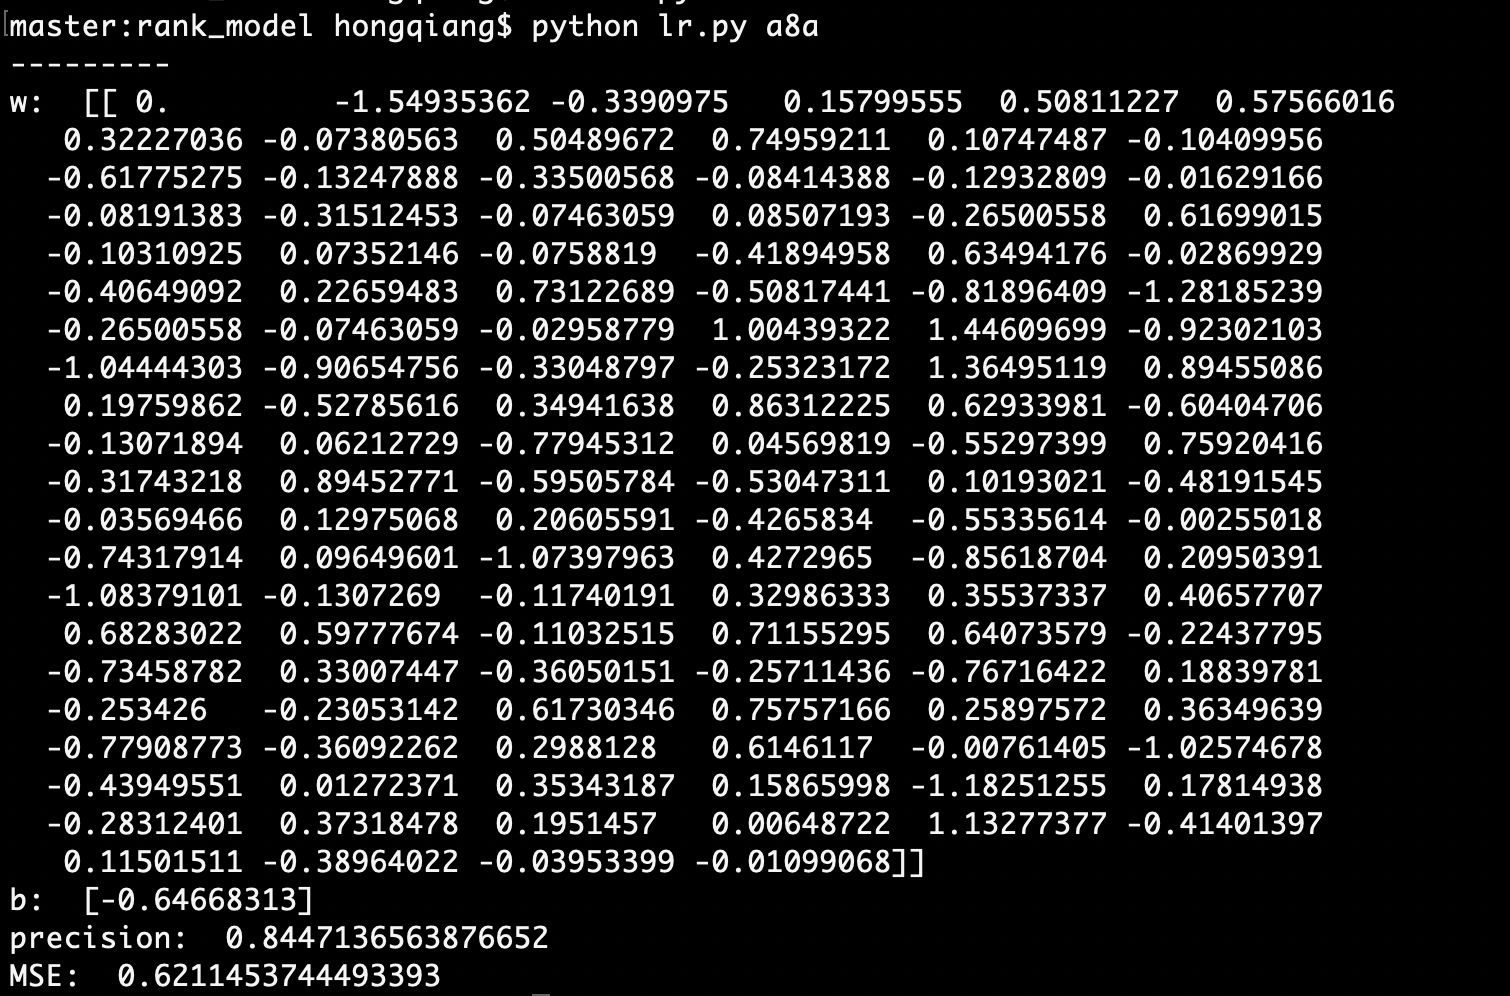
上文代码将稀疏矩阵转换为稠密矩阵,满足了sklearn中LR模型数据集输入格式要求。代码运行结果如图4所示:
步骤一和步骤二完成了模型训练的代码部分,今天的文章先写到这里,下一篇中将讲到如何将文本数据数字化为本文图3的稀疏矩阵格式。
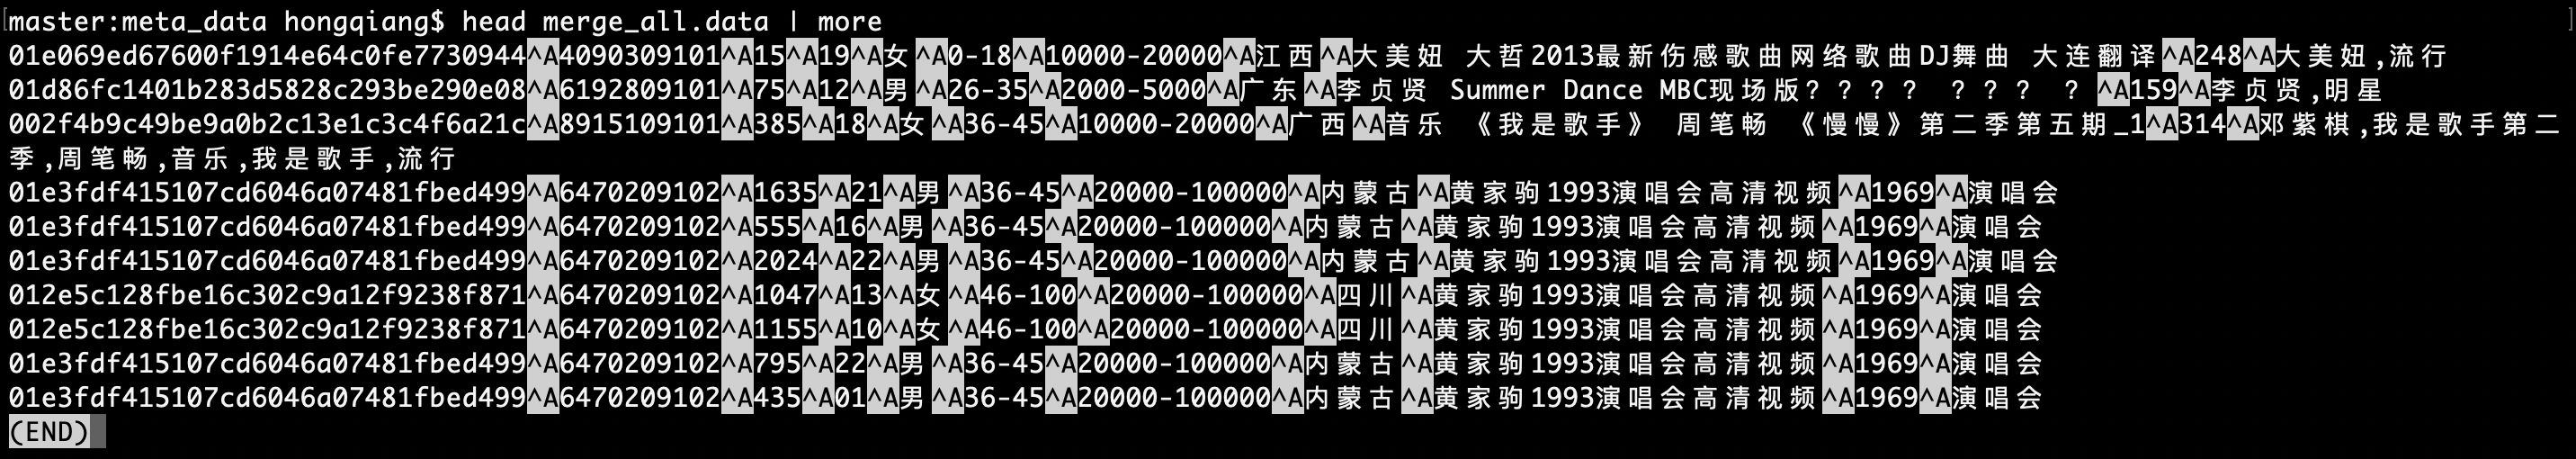
原始文本数据为:
用户ID / 物品ID / 收听时长 / 收听的时间点 / 性别 / 年龄段 / 收入 / 籍贯 / 物品名称 / 物品总时长 / 物品标签
发布者:全栈程序员-站长,转载请注明出处:https://javaforall.net/182487.html原文链接:https://javaforall.net


