
GBDT基本思想
GBDT的基本结构是决策树组成的森林,学习方式是梯度提升。
具体的讲,GBDT作为集成模型,预测的方式是把所有子树的结果加起来。GBDT通过逐一生成决策子树的方式生成整个森林,生成新子树的过程是利用样本标签值与当前树林预测值之间的残差,构建新的子树。
例如,当前已经生成了3课子树了,则当前的预测值为D(x)=d1(x)+d2(x)+d3(x),此时我们得到的当前的预测值为D(x)效果并不好,与真正的拟合函数f(x)还有一定的差距。GBDT希望的是构建第四棵子树,使当前树林的预测结果D(x)与第四棵树的预测结果d4(x)的之和,能在理论上逼近拟合函数f(x)。
所以,我们第四棵树的预测结果应该以拟合函数f(x)与当前树林的预测结果D(x)之差为目标,即d4(x)=f(x)-D(x)。在GBDT中,我们将r(x)=f(x)-D(x)叫做残差。理论上,如果我们能生成足够多的子树去拟合这个残差,那么我们得到的结果就可以无限接近于真实的结果。
在讲解GBDT算法之前,我们需要补充一些其他的知识,方便我们后续的理解。
补充知识
1前向分步算法
前向分布算法考虑这样一个问题:“给定一个训练数据集和损失函数,并且弱模型通过权重之和的方式组合成强模型,那么我们怎么来求这些弱模型以及最终的强模型?”
我们用数学化的语言描述一下上面的问题:
给定训练数据集T={(x1, y1),(x2, y2),…,(xN, yN)}和损失函数L(y, f(x)),f(x)是最终的强学习模型,因为弱模型通过权重之和的方式组合成强模型,所以f(x)可以如下表示:
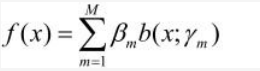

其中b(x;γm)是弱学习模型,βm是弱学习模型的权重系数,γm是弱学习模型的参数。
所以前向分布算法考虑的问题是,如何求出所有的βm和γm,即优化如下目标表达式:
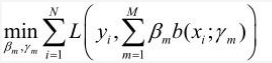
按照以往的思路,这里我们可以使用梯度下降法来对目标函数进行求解,但是对于这个式子而言,梯度下降法会变得十分困难,不易于计算。所以我们使用一种新的方法——前向分步算法来替代梯度下降法进行求解。前向分布算法给出的解决办法是:“利用贪心算法,每一步只学习一个弱模型及其系数,使得当前弱模型和之前所有的弱模型组合后目标表达式取得最优值,最终就可以使得所有弱模型组合后目标表达式取得最优值”
算法步骤
输入:训练数据集T={(x1, y1),(x2, y2),…,(xN, yN)};损失函数L(y, f(x))
输出:强学习模型f(x)
(1)初始化f0(x)=0
(2)对m=1, 2 ,…, M
(a)极小化损失函数
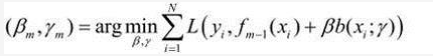
(b)更新
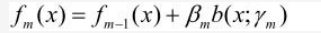
(3)最终得到强学习模型f(x)
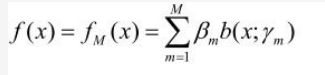
总之,提升方法告诉我们如何来求一个效果更好模型,那就是将多个弱模型组合起来,这仅仅是一个思路,而前向分布算法就具体告诉我们应该如何来做。
2提升树算法
如果前向分布算法中的基函数取决策树(一般默认使用CART树,因为它即可做回归也可以做分类),那么该前向分布算法就可以称为提升树算法。针对不同的损失函数和树的类型,提升树有不同的用途,对于前向分布算法来说,当损失函数取指数损失,基函数取二叉分类树,前向分布算法就变成了用于分类的提升树算法; 当损失函数取平方损失,基函数取二叉回归树,前向分布算法就变成了用于回归的提升树算法;
用于分类的提升树算法
这里我就不再啰嗦了,就是将Adaboost算法中的基函数取二叉分类树,算法具体流程和Adaboost一样。
用于回归的提升树算法
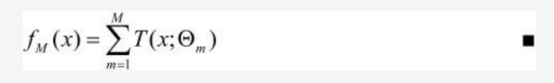
前向分步算法中的基函数采用二叉回归树,损失函数采用平方损失,就得到了解决回归问题的提升树。
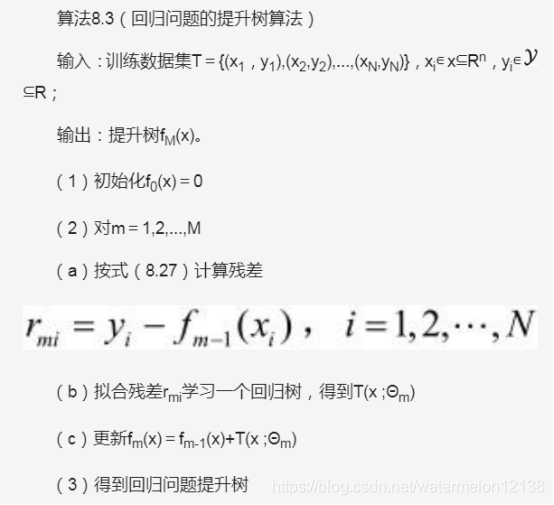
假设现在是前向分布算法的第 m 次迭代,当前模型为 fm-1(x),此时的弱模型未知,我们记为T(x;θ),第m次迭代的目标是找到使得损失函数 L(yi, fm-1(xi) + T(xi;θ))取最小值的 T*(x;θ),然后更新当前模型 fm(x) = fm-1(x) + T*(x;θ)。
因为损失函数采用的是平方损失,所以有:
L(yi, fm-1(xi) + T(xi;θ)) = (yi – fm-1(xi) -T(xi;θ))2 = ( r – T(xi;θ))2
其中 r = yi – fm-1(xi) ,这是当前模型拟合数据的残差。从上面的表达式可以看出弱模型T(xi;θ)的预测值越是接近r,损失L的值就越小,所以说每一次迭代过程的弱模型 T(xi;θ) 只需拟合当前模型的残差就可以了,但这只限于损失函数取平方损失的时候。
算法步骤
关于拟合残差,举个简单的栗子
举个栗子:
A、B、C、D四个人的真实年龄分别为14、16、24、26,现在利用提升算法对这四个人的年龄做预测。
第一轮:
初始模型F0(x)取值为常数,这个常数为样本的均值时目标函数能取最小值。
所以F0(x) = 20,即A、B、C、D的预测年龄为20、20、20 、20。
所以得到每个人的年龄预测残差为 -6、-4、4、6,然后用残差数据去拟合一个基函数f1(x),我们就可以得到一个新的模型F1(x) = F0(x) + f1(x),假设这个基函数 f1(x) 对于残差数据的预测值为 -5、-4、3、6。
第二轮:
模型 F1(x) 的预测值为15(20-5)、16(20-4)、23(20+3)、26(20+6),
所以得到每个人的年龄预测残差为 -1、0、1、0,然后用残差数据去拟合一个基函数f2(x),我们就可以得到一个新的模型F2(x) = F0(x) + f1(x) + f2(x) ,其中这个基函数 f2(x) 对于残差数据的预测值为 -1、0、1、0。
此时,F2(x)已经可以完全预测准确了,它的预测结果是 14(20-5-1)、16(20-4-0)、24(20+3+1)、26(20+6+0)。
3梯度提升算法
当前向分布算法中的损失函数取平方损失或者指数损失,我们都有比好的优化方法,其中指数损失我们可以采用Adaboost算法,平方损失我们采用拟合当前模型残差的方法,那如果损失函数是其它类型的函数呢?针对这个问题,freidman提出了梯度提升,其关键是用损失函数L( yi, fm-1(xi)) 对 当前模型 fm-1(xi) 的 负梯度值作为残差的近似值,所以可以将该负梯度值称为伪残差。
可以这样来想,假设目前损失函数取平方损失函数,即
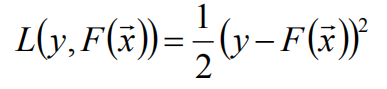
该平方损失函数L( yi, fm-1(xi)) 对 当前模型 fm-1(xi) 的梯度值为:
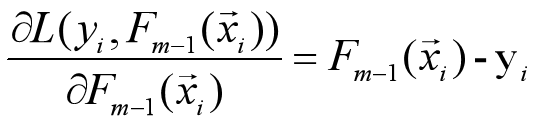
也就是说,损失函数取平方损失的时候,负的梯度值就是当前模型的残差,所以当损失函数取其它函数的时候,我可以用负梯度值作为当前模型残差的近似值。
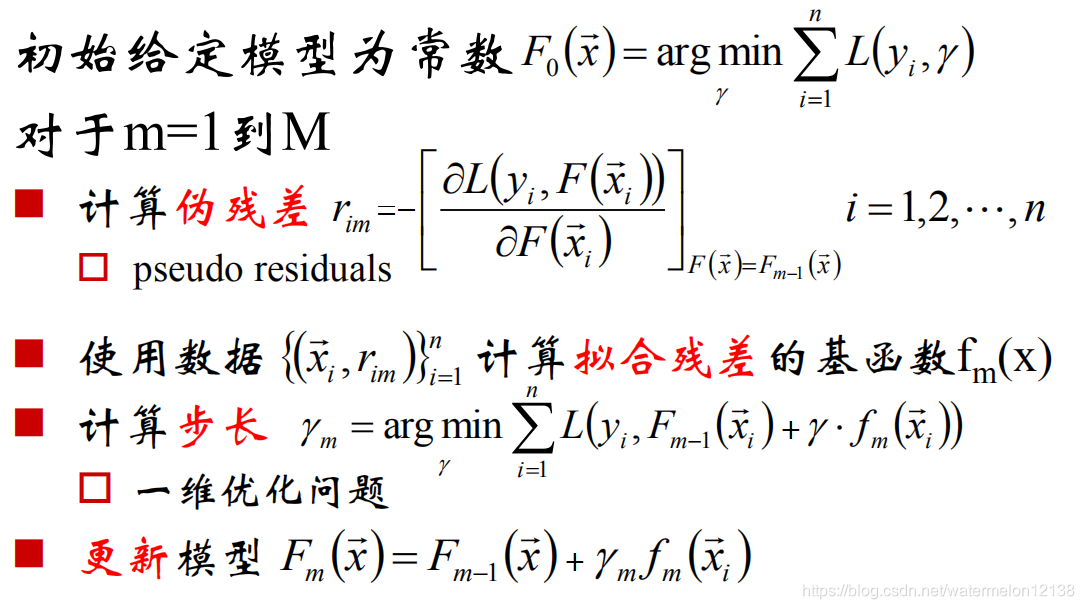
GBDT算法流程
现在我们将梯度提升算法和回归问题的提升树算法进行一个融合,就可以得到GBDT的算法了。
GBDT既可以用来处理回归问题,也可以用来处理分类问题,当梯度提升算法的基函数取二叉回归树,该梯度提升算法就可以称之为GBDT,注意不管GBDT是做回归还是做分类,它的基函数一直都是二叉回归树(默认采用CART回归树)。
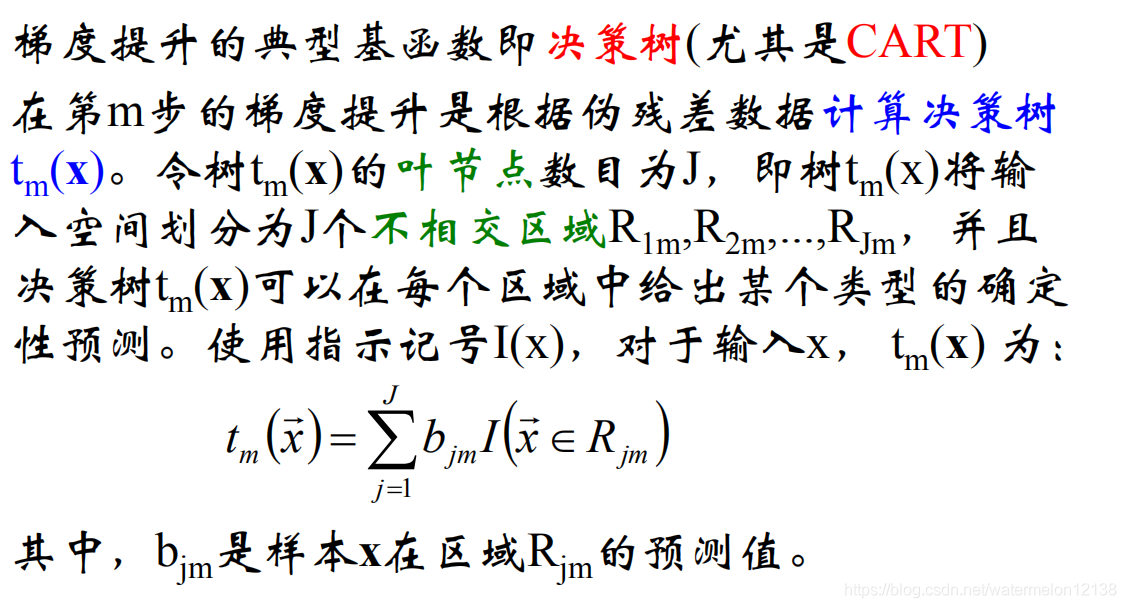
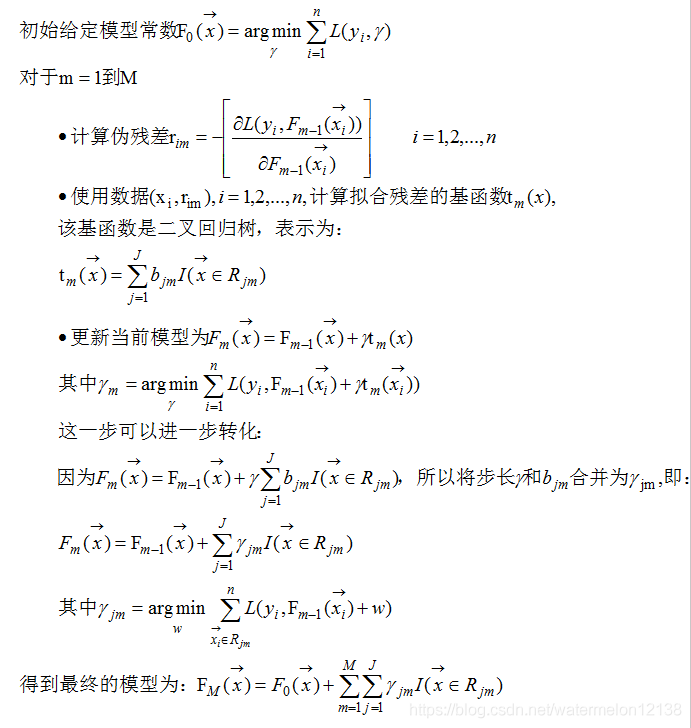
如上所述,GBDT之所以分类和回归都取二叉回归树,大概是因为二叉回归树叶子结点的权值比较好求出来吧(上述算法流程的倒数第二步),只要叶子节点的权值求出来,该二叉回归树(误差率最小)就算是求出来了。
发布者:全栈程序员-站长,转载请注明出处:https://javaforall.net/182665.html原文链接:https://javaforall.net



