
Jetbrains全系列IDE使用 1年只要46元 售后保障 童叟无欺
支持向量机svm也是一种机器学习算法,采用空间超平面进行数据分割,在这篇博客中我们将使用svm进行手写数字的识别,使用该算法,识别率可以达到96.72%。
环境准备:
vs2015
OpenCV4.5.0
下面的代码为svm模型训练代码:
#include<iostream>
#include<opencv.hpp>
#include <string>
#include <fstream>
using namespace std;
using namespace cv;


//小端存储转换
int reverseInt(int i);
//读取image数据集信息
Mat read_mnist_image(const string fileName);
//读取label数据集信息
Mat read_mnist_label(const string fileName);

string train_images_path = "G:/vs2015_opencv_ml/mnist/train-images.idx3-ubyte";
string train_labels_path = "G:/vs2015_opencv_ml/mnist/train-labels.idx1-ubyte";
string test_images_path = "G:/vs2015_opencv_ml/mnist/t10k-images.idx3-ubyte";
string test_labels_path = "G:/vs2015_opencv_ml/mnist/t10k-labels.idx1-ubyte";

int main()
{

	/* ---------第一部分:训练数据准备----------- */
	//读取训练标签数据 (60000,1) 类型为int32
	Mat train_labels = read_mnist_label(train_labels_path);

	//读取训练图像数据 (60000,784) 类型为float32 数据未归一化
	Mat train_images = read_mnist_image(train_images_path);
	//将图像数据归一化
	train_images = train_images / 255.0;

	//读取测试数据标签(10000,1) 类型为int32
	Mat test_labels = read_mnist_label(test_labels_path);

	//读取测试数据图像 (10000,784) 类型为float32 数据未归一化
	Mat test_images = read_mnist_image(test_images_path);
	//归一化
	test_images = test_images / 255.0;

	/* ---------第二部分:构建svm训练模型并进行训练----------- */
	cv::Ptr<cv::ml::SVM> svm = cv::ml::SVM::create();
	//设置类型为C_SVC代表分类
	svm->setType(cv::ml::SVM::C_SVC);
	//设置核函数
	svm->setKernel(cv::ml::SVM::POLY);
	//设置其它属性
	svm->setGamma(3.0);
	svm->setDegree(3.0);
	//设置迭代终止条件
	svm->setTermCriteria(cv::TermCriteria(cv::TermCriteria::MAX_ITER | cv::TermCriteria::EPS, 300, 0.0001));

	//开始训练
	cv::Ptr<cv::ml::TrainData> train_data = cv::ml::TrainData::create(train_images, cv::ml::ROW_SAMPLE, train_labels);
	cout << "开始进行训练..." << endl;
	svm->train(train_data);
	cout << "训练完成" << endl;

	/* ---------第三部分:在测试数据集上预测计算准确率----------- */
	Mat pre_out;
	//返回值为第一个图像的预测值 pre_out为整个batch的预测值集合
	cout << "开始进行预测..." << endl;
	float ret = svm->predict(test_images, pre_out);
	cout << "预测完成" << endl;

	//计算准确率必须将两种标签化为同一数据类型
	pre_out.convertTo(pre_out, CV_8UC1);
	test_labels.convertTo(test_labels, CV_8UC1);

	int equal_nums = 0;
	for (int i = 0; i <pre_out.rows; i++)
	{

		if (pre_out.at<uchar>(i, 0) == test_labels.at<uchar>(i, 0))
		{

			equal_nums++;
		}
	}
	float acc = float(equal_nums) / float(pre_out.rows);
	cout << "测试数据集上的准确率为:" << acc * 100 << "%" << endl;

	//保存模型
	svm->save("mnist_svm.xml");


	getchar();
	return 0;
}


;

int reverseInt(int i) {

	unsigned char c1, c2, c3, c4;

	c1 = i & 255;
	c2 = (i >> 8) & 255;
	c3 = (i >> 16) & 255;
	c4 = (i >> 24) & 255;

	return ((int)c1 << 24) + ((int)c2 << 16) + ((int)c3 << 8) + c4;
}

Mat read_mnist_image(const string fileName) {

	int magic_number = 0;
	int number_of_images = 0;
	int n_rows = 0;
	int n_cols = 0;

	Mat DataMat;

	ifstream file(fileName, ios::binary);
	if (file.is_open())
	{

		cout << "成功打开图像集 ..." << endl;

		file.read((char*)&magic_number, sizeof(magic_number));//幻数(文件格式)
		file.read((char*)&number_of_images, sizeof(number_of_images));//图像总数
		file.read((char*)&n_rows, sizeof(n_rows));//每个图像的行数
		file.read((char*)&n_cols, sizeof(n_cols));//每个图像的列数

		magic_number = reverseInt(magic_number);
		number_of_images = reverseInt(number_of_images);
		n_rows = reverseInt(n_rows);
		n_cols = reverseInt(n_cols);
		cout << "幻数(文件格式):" << magic_number
			<< " 图像总数:" << number_of_images
			<< " 每个图像的行数:" << n_rows
			<< " 每个图像的列数:" << n_cols << endl;

		cout << "开始读取Image数据......" << endl;

		DataMat = Mat::zeros(number_of_images, n_rows * n_cols, CV_32FC1);
		for (int i = 0; i < number_of_images; i++) {

			for (int j = 0; j < n_rows * n_cols; j++) {

				unsigned char temp = 0;
				file.read((char*)&temp, sizeof(temp));
				//可以在下面这一步将每个像素值归一化
				float pixel_value = float(temp);
				//按照行将像素值一个个写入Mat中
				DataMat.at<float>(i, j) = pixel_value;
			}
		}

		cout << "读取Image数据完毕......" << endl;

	}
	file.close();
	return DataMat;
}

Mat read_mnist_label(const string fileName) {

	int magic_number;
	int number_of_items;

	Mat LabelMat;

	ifstream file(fileName, ios::binary);
	if (file.is_open())
	{

		cout << "成功打开标签集 ... " << endl;

		file.read((char*)&magic_number, sizeof(magic_number));
		file.read((char*)&number_of_items, sizeof(number_of_items));
		magic_number = reverseInt(magic_number);
		number_of_items = reverseInt(number_of_items);

		cout << "幻数(文件格式):" << magic_number << " ;标签总数:" << number_of_items << endl;

		cout << "开始读取Label数据......" << endl;
		//CV_32SC1代表32位有符号整型 通道数为1
		LabelMat = Mat::zeros(number_of_items, 1, CV_32SC1);
		for (int i = 0; i < number_of_items; i++) {

			unsigned char temp = 0;
			file.read((char*)&temp, sizeof(temp));
			LabelMat.at<unsigned int>(i, 0) = (unsigned int)temp;
		}
		cout << "读取Label数据完毕......" << endl;

	}
	file.close();
	return LabelMat;
}
执行上述代码,运行结果如下:
成功打开标签集 ...
幻数(文件格式):2049  ;标签总数:60000
开始读取Label数据......
读取Label数据完毕......
成功打开图像集 ...
幻数(文件格式):2051 图像总数:60000 每个图像的行数:28 每个图像的列数:28
开始读取Image数据......
读取Image数据完毕......
成功打开标签集 ...
幻数(文件格式):2049  ;标签总数:10000
开始读取Label数据......
读取Label数据完毕......
成功打开图像集 ...
幻数(文件格式):2051 图像总数:10000 每个图像的行数:28 每个图像的列数:28
开始读取Image数据......
读取Image数据完毕......
开始进行训练...
训练完成
开始进行预测...
预测完成
测试数据集上的准确率为:96.72%
可见svm模型对手写数字的准确率高达96.72%,下面调用该模型进行图片读取的识别。
#include<iostream>
#include<opencv.hpp>
using namespace std;
using namespace cv;

int main()
{

	//读取一张手写数字图片(28,28)
	Mat image = cv::imread("shuzi1.jpg", 0);
	Mat img_show = image.clone();
	//更换数据类型有uchar->float32
	image.convertTo(image, CV_32F);
	//归一化
	image = image / 255.0;
	//(1,784)
	image = image.reshape(1, 1);

	//加载svm模型
	cv::Ptr<cv::ml::SVM> svm = cv::ml::StatModel::load<cv::ml::SVM>("mnist_svm.xml");
	//预测图片
	float ret = svm->predict(image);
	cout << ret << endl;

	cv::imshow("img", img_show);
	cv::waitKey(0);
	getchar();
	return 0;
}
执行程序,运行结果如下:
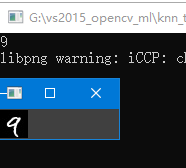

由图所示,数字9能够正确识别。
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容, 请发送邮件至 举报,一经查实,本站将立刻删除。
发布者:全栈程序员-站长,转载请注明出处:https://javaforall.net/193947.html原文链接:https://javaforall.net


