
Jetbrains全系列IDE使用 1年只要46元 售后保障 童叟无欺
一个神经元即一个感知机模型,由多个神经元相互连接形成的网络,即神经网络。
这里我们只讨论单隐层前馈神经网络,其连接形式入下:
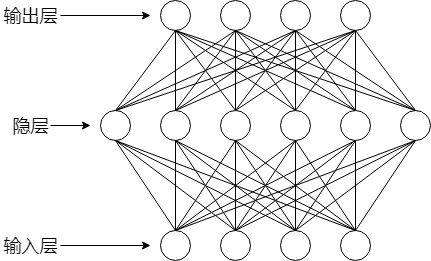

神经网络模型的待估参数即,每个神经元的阈值,以及神经元之间的连接权重。
对于该模型有如下定义:
训练集:D={(x1, y1), (x2, y2), ……, (xm, ym)},x具有d个属性值,y具有k个可能取值
则我们的神经网络(单隐层前馈神经网络)应该是具有d个输入神经元,q个隐层神经元,k个输出层神经元的神经网络 ,我们默认输入层只是数据的输入,不对数据做处理,即输入层没有阈值。
阈值函数使用对数几率函数:

有如下定义:
输出层第j个神经元的阈值为:θj
隐层第h个神经元的阈值为:γh(γ是Gamma)
输入层第i个神经元与隐层第h个神经元的连接权重为:vih
隐层第h个神经元与输出层第j个神经元的连接权重为:ωhj
由上述定义我们可以得到:
隐层第h个神经元接收到输入:

隐层第h个神经元的输出:
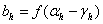
输出层第j个神经元接收到的输入:
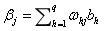
现在我们定义好了所有的参数,接下来我们要求这些模型。
对参数进行估计,需要有优化方向,我们继续使用欧式距离,或者均方误差来作为优化目标:
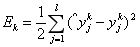
我们使用梯度下降的策略对参数进行迭代优化,所以任意一个参数的变化大小为(θ代表任意参数):

下面根据这个更新公式,我们来求各个参数的更新公式:
对数几率函数的导数如下:
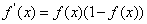
输出层第j个神经元的阈值θj:

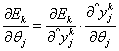

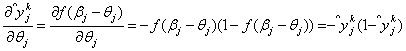
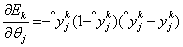
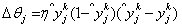
隐层第h个神经元的阈值γh:

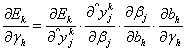
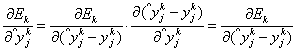
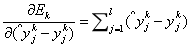
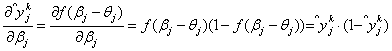

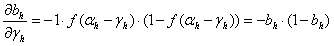
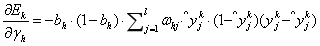
输入层第i个神经元与隐层第h个神经元的连接权重vih :

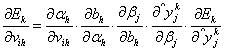

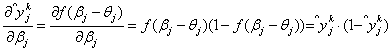
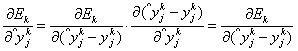
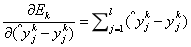
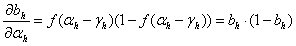
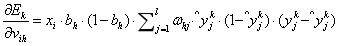
隐层第h个神经元与输出层第j个神经元的连接权重ωhj:
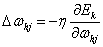
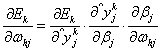

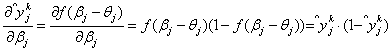

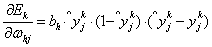
现在四个参数的更新规则都计算出来了,我们可以开始编码实现了。
现在有一个问题:在二分类任务中,输出层神经元有几个?
一个:如果只有1个,那么输出0表示反例,1表示正例
二个:那么输出(1,0)表示反例,(0,1)表示正例
一下实例我们使用第一种:
我们使用一个二分类数据集:马疝病数据集
UCI下载地址为:http://archive.ics.uci.edu/ml/datasets/Horse+Colic
代码和数据集,我已经上传到我的资源:https://download.csdn.net/download/qq_41398808/11231315
数据读取:
def loaddataset(filename):
	fp = open(filename)

	#存放数据
	dataset = []

	#存放标签
	labelset = []
	for i in fp.readlines():
		a = i.strip().split()

		#每个数据行的最后一个是标签
		dataset.append([float(j) for j in a[:len(a)-1]])
		labelset.append(int(float(a[-1])))
	return dataset, labelset
初始化各个参数:
#x为输入层神经元个数,y为隐层神经元个数,z输出层神经元个数
def parameter_initialization(x, y, z):

	#隐层阈值
	value1 = np.random.randint(-5, 5, (1, y)).astype(np.float64)

	#输出层阈值
	value2 = np.random.randint(-5, 5, (1, z)).astype(np.float64)

	#输入层与隐层的连接权重
	weight1 = np.random.randint(-5, 5, (x, y)).astype(np.float64)

	#隐层与输出层的连接权重
	weight2 = np.random.randint(-5, 5, (y, z)).astype(np.float64)

return weight1, weight2, value1, value2初始化的各参数数值不能一样,否则无法进行学习。
对数几率函数(sigmoid函数):
def sigmoid(z):
	return 1 / (1 + np.exp(-z))
训练过程(参数调整过程):
'''
weight1:输入层与隐层的连接权重
weight2:隐层与输出层的连接权重
value1:隐层阈值
value2:输出层阈值
'''
def trainning(dataset, labelset, weight1, weight2, value1, value2):
	#x为步长
	x = 0.01
	for i in range(len(dataset)):
		#输入数据
		inputset = np.mat(dataset[i]).astype(np.float64)
		#数据标签
		outputset = np.mat(labelset[i]).astype(np.float64)
		#隐层输入
		input1 = np.dot(inputset, weight1).astype(np.float64)
		#隐层输出
		output2 = sigmoid(input1 - value1).astype(np.float64)
		#输出层输入
		input2 = np.dot(output2, weight2).astype(np.float64)
		#输出层输出
		output3 = sigmoid(input2 - value2).astype(np.float64)

		#更新公式由矩阵运算表示
		a = np.multiply(output3, 1 - output3)
		g = np.multiply(a, outputset - output3)
		b = np.dot(g, np.transpose(weight2))
		c = np.multiply(output2, 1 - output2)
		e = np.multiply(b, c)

		value1_change = -x * e
		value2_change = -x * g
		weight1_change = x * np.dot(np.transpose(inputset), e)
		weight2_change = x * np.dot(np.transpose(output2), g)

		#更新参数
		value1 += value1_change
		value2 += value2_change
		weight1 += weight1_change
		weight2 += weight2_change
	return weight1, weight2, value1, value2
测试:
def testing(dataset, labelset, weight1, weight2, value1, value2):
	#记录预测正确的个数
	rightcount = 0
	for i in range(len(dataset)):
		#计算每一个样例通过该神经网路后的预测值
		inputset = np.mat(dataset[i]).astype(np.float64)
		outputset = np.mat(labelset[i]).astype(np.float64)
		output2 = sigmoid(np.dot(inputset, weight1) - value1)
		output3 = sigmoid(np.dot(output2, weight2) - value2)

		#确定其预测标签
		if output3 > 0.5:
			flag = 1
		else:
			flag = 0
		if labelset[i] == flag:
			rightcount += 1
		#输出预测结果
		print("预测为%d   实际为%d"%(flag, labelset[i]))
	#返回正确率
	return rightcount / len(dataset)
主函数:
if __name__ == '__main__':
	dataset, labelset = loaddataset('基于神经网络的马疝病死亡预测/horseColicTraining.txt')
	weight1, weight2, value1, value2 = parameter_initialization(len(dataset[0]), len(dataset[0]), 1)
	for i in range(1500):
		weight1, weight2, value1, value2 = trainning(dataset, labelset, weight1, weight2, value1, value2)
	rate = testing(dataset, labelset, weight1, weight2, value1, value2)
	print("正确率为%f"%(rate))
结果:
正确率为0.769231
[Finished in 68.2s]
上述实例只是一个测试我们模型是否推导正确的实例,在数据集上的学习效果并不好,有许多的细节没有考虑。
完整代码如下:
import numpy as np

def loaddataset(filename):
	fp = open(filename)

	#存放数据
	dataset = []

	#存放标签
	labelset = []
	for i in fp.readlines():
		a = i.strip().split()

		#每个数据行的最后一个是标签
		dataset.append([float(j) for j in a[:len(a)-1]])
		labelset.append(int(float(a[-1])))
	return dataset, labelset


#x为输入层神经元个数,y为隐层神经元个数,z输出层神经元个数
def parameter_initialization(x, y, z):

	#隐层阈值
	value1 = np.random.randint(-5, 5, (1, y)).astype(np.float64)

	#输出层阈值
	value2 = np.random.randint(-5, 5, (1, z)).astype(np.float64)

	#输入层与隐层的连接权重
	weight1 = np.random.randint(-5, 5, (x, y)).astype(np.float64)

	#隐层与输出层的连接权重
	weight2 = np.random.randint(-5, 5, (y, z)).astype(np.float64)

	return weight1, weight2, value1, value2

def sigmoid(z):
	return 1 / (1 + np.exp(-z))

'''
weight1:输入层与隐层的连接权重
weight2:隐层与输出层的连接权重
value1:隐层阈值
value2:输出层阈值
'''
def trainning(dataset, labelset, weight1, weight2, value1, value2):
	#x为步长
	x = 0.01
	for i in range(len(dataset)):
		#输入数据
		inputset = np.mat(dataset[i]).astype(np.float64)
		#数据标签
		outputset = np.mat(labelset[i]).astype(np.float64)
		#隐层输入
		input1 = np.dot(inputset, weight1).astype(np.float64)
		#隐层输出
		output2 = sigmoid(input1 - value1).astype(np.float64)
		#输出层输入
		input2 = np.dot(output2, weight2).astype(np.float64)
		#输出层输出
		output3 = sigmoid(input2 - value2).astype(np.float64)

		#更新公式由矩阵运算表示
		a = np.multiply(output3, 1 - output3)
		g = np.multiply(a, outputset - output3)
		b = np.dot(g, np.transpose(weight2))
		c = np.multiply(output2, 1 - output2)
		e = np.multiply(b, c)

		value1_change = -x * e
		value2_change = -x * g
		weight1_change = x * np.dot(np.transpose(inputset), e)
		weight2_change = x * np.dot(np.transpose(output2), g)

		#更新参数
		value1 += value1_change
		value2 += value2_change
		weight1 += weight1_change
		weight2 += weight2_change
	return weight1, weight2, value1, value2

def testing(dataset, labelset, weight1, weight2, value1, value2):
	#记录预测正确的个数
	rightcount = 0
	for i in range(len(dataset)):
		#计算每一个样例通过该神经网路后的预测值
		inputset = np.mat(dataset[i]).astype(np.float64)
		outputset = np.mat(labelset[i]).astype(np.float64)
		output2 = sigmoid(np.dot(inputset, weight1) - value1)
		output3 = sigmoid(np.dot(output2, weight2) - value2)

		#确定其预测标签
		if output3 > 0.5:
			flag = 1
		else:
			flag = 0
		if labelset[i] == flag:
			rightcount += 1
		#输出预测结果
		print("预测为%d   实际为%d"%(flag, labelset[i]))
	#返回正确率
	return rightcount / len(dataset)

if __name__ == '__main__':
	dataset, labelset = loaddataset('基于神经网络的马疝病死亡预测/horseColicTraining.txt')
	weight1, weight2, value1, value2 = parameter_initialization(len(dataset[0]), len(dataset[0]), 1)
	for i in range(1500):
		weight1, weight2, value1, value2 = trainning(dataset, labelset, weight1, weight2, value1, value2)
	rate = testing(dataset, labelset, weight1, weight2, value1, value2)
	print("正确率为%f"%(rate))
发布者:全栈程序员-站长,转载请注明出处:https://javaforall.net/194987.html原文链接:https://javaforall.net



