
hashmap的底层实现原理_hashtable底层数据结构

hashmap的底层实现原理_hashtable底层数据结构一:HashMap底层实现原理解析我们常见的有数据结构有三种结构:1、数组结构2、链表结构3、哈希表结构下面我们来看看各自的数据结构的特点:1、数组结构:存储区间连续、内存占用严重、空间复杂度大优点:随机读取和修改效率高,原因是数组是连续的(随机访问性强,查找速度快)缺点:插入和删除数据效率低,因插入数据,这个位置后面的数据在内存中都要往后移动,且大小固定不易动态扩展。2、链表结构:存储区间离散、占用内存宽松、空间复杂度小优点:插入删除速度快,内存利用率高,没有固定大小,扩展灵活


Jetbrains全系列IDE使用 1年只要46元 售后保障 童叟无欺

一:HashMap底层实现原理解析

我们常见的有数据结构有三种结构:1、数组结构 2、链表结构 3、哈希表结构 下面我们来看看各自的数据结构的特点:
1、数组结构: 存储区间连续、内存占用严重、空间复杂度大

  • 优点:随机读取和修改效率高,原因是数组是连续的(随机访问性强,查找速度快)
  • 缺点:插入和删除数据效率低,因插入数据,这个位置后面的数据在内存中都要往后移动,且大小固定不易动态扩展。

2、链表结构:存储区间离散、占用内存宽松、空间复杂度小

  • 优点:插入删除速度快,内存利用率高,没有固定大小,扩展灵活
  • 缺点:不能随机查找,每次都是从第一个开始遍历(查询效率低)

3、哈希表结构:结合数组结构和链表结构的优点,从而实现了查询和修改效率高,插入和删除效率也高的一种数据结构
常见的HashMap就是这样的一种数据结构
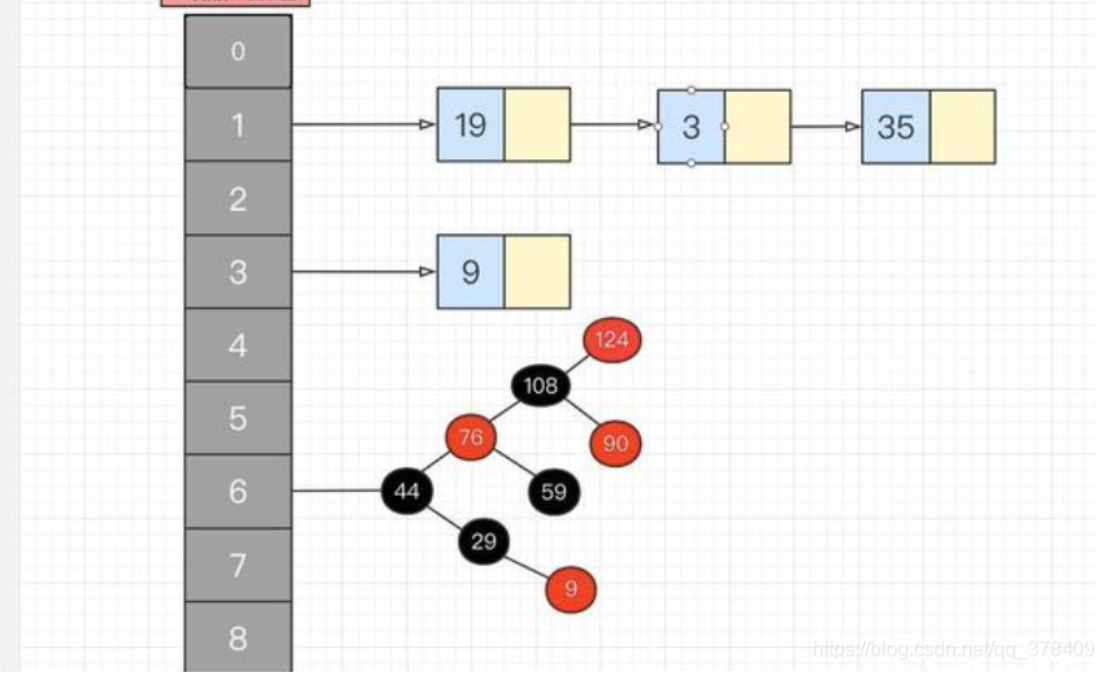
在这里插入图片描述

HashMap中的put()和get()的实现原理:

  • 1、map.put(k,v)实现原理
    (1)首先将k,v封装到Node对象当中(节点)。
    (2)然后它的底层会调用K的hashCode()方法得出hash值。
    (3)通过哈希表函数/哈希算法,将hash值转换成数组的下标,下标位置上如果没有任何元素,就把Node添加到这个位置上。如果说下标对应的位置上有链表。此时,就会拿着k和链表上每个节点的k进行equal。如果所有的equals方法返回都是false,那么这个新的节点将被添加到链表的末尾。如其中有一个equals返回了true,那么这个节点的value将会被覆盖。
  • 2、map.get(k)实现原理
    (1)先调用k的hashCode()方法得出哈希值,并通过哈希算法转换成数组的下标。
    (2)通过上一步哈希算法转换成数组的下标之后,在通过数组下标快速定位到某个位置上。如果这个位置上什么都没有,则返回null。如果这个位置上有单向链表,那么它就会拿着K和单向链表上的每一个节点的K进行equals,如果所有equals方法都返回false,则get方法返回null。如果其中一个节点的K和参数K进行equals返回true,那么此时该节点的value就是我们要找的value了,get方法最终返回这个要找的value。

为何随机增删、查询效率都很高的原因是?
原因: 增删是在链表上完成的,而查询只需扫描部分,则效率高。

HashMap集合的key,会先后调用两个方法,hashCode and equals方法,这这两个方法都需要重写。

为什么放在hashMap集合key部分的元素需要重写equals方法?
因为equals方法默认比较的是两个对象的内存地址

二:HashMap红黑树原理分析

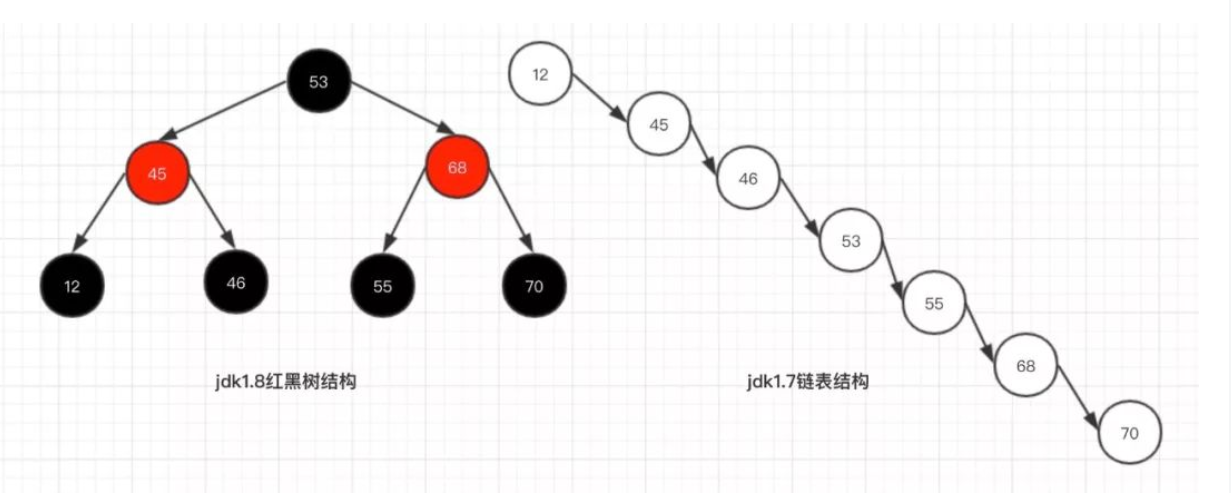
相比 jdk1.7 的 HashMap 而言,jdk1.8最重要的就是引入了红黑树的设计,当hash表的单一链表长度超过 8 个的时候,链表结构就会转为红黑树结构。
为什么要这样设计呢?好处就是避免在最极端的情况下链表变得很长很长,在查询的时候,效率会非常慢。
在这里插入图片描述

  • 红黑树查询:其访问性能近似于折半查找,时间复杂度 O(logn);
  • 链表查询:这种情况下,需要遍历全部元素才行,时间复杂度 O(n);

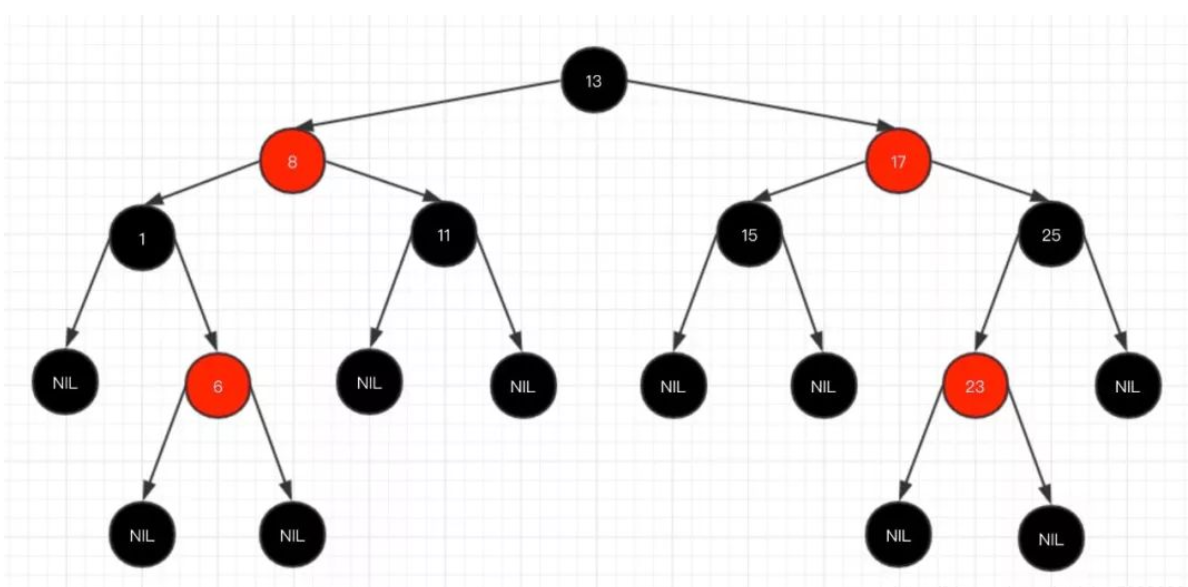
简单的说,红黑树是一种近似平衡的二叉查找树,其主要的优点就是“平衡“,即左右子树高度几乎一致,以此来防止树退化为链表,通过这种方式来保障查找的时间复杂度为 log(n)。
在这里插入图片描述
关于红黑树的内容,网上给出的内容非常多,主要有以下几个特性:

  • 1、每个节点要么是红色,要么是黑色,但根节点永远是黑色的;

  • 2、每个红色节点的两个子节点一定都是黑色;

  • 3、红色节点不能连续(也即是,红色节点的孩子和父亲都不能是红色);

  • 4、从任一节点到其子树中每个叶子节点的路径都包含相同数量的黑色节点;

  • 5、所有的叶节点都是是黑色的(注意这里说叶子节点其实是上图中的 NIL 节点);

在树的结构发生改变时(插入或者删除操作),往往会破坏上述条件 3 或条件 4,需要通过调整使得查找树重新满足红黑树的条件。

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容, 请发送邮件至 举报,一经查实,本站将立刻删除。

发布者:全栈程序员-站长,转载请注明出处:https://javaforall.net/195154.html原文链接:https://javaforall.net

赞 (0)
全栈程序员-站长的头像全栈程序员-站长


相关推荐

  • 分析家数据存储格式错误_大数据存储的基本形式

    分析家数据存储格式错误_大数据存储的基本形式fromlee感谢他! 分析家数据存储格式上海日线存储文件为:\superstk\data\sh\day.dat深圳日线存储文件为:\superstk\data\sz\day.dat以上海日

    2022年8月5日
  • linux 中 tar.xz 的解压命令

    linux 中 tar.xz 的解压命令对于tar.xz结尾的压缩文件,解压有两种方式:可以先将外层用xz解压方式解压,,然后里层用tar解压方式解压:$xz-d*****.tar.xz$tar-xvf*****.tar2.直接使用如下命令解压:$tarxvJf***.tar.xz…

    2022年5月13日
  • 汉澳sinox不受openssl心血漏洞影响并分析修复其漏洞代码

    汉澳sinox不受openssl心血漏洞影响并分析修复其漏洞代码OpenSSL心血(HeartBleed)漏洞是openssl在2014-04-07发布的重大安全漏洞(CVE-2014-0160)这个漏洞使攻击者可以从server内存中读取64KB的数据,甚至获取到加密流量的密钥。用户的名字和password。以及訪问的内容。主要影响版本号OpenSSL1.0.1到OpenSSL1.0.1f以及OpenSSL1.0….

    2022年7月16日
  • VUE组件封装_vue使用组件

    VUE组件封装_vue使用组件什么是组件化:组件化就是将一个页面拆分成一个个小的功能模块,每个功能模块完成属于自己这部分独立的功能,使得整个页面的管理和维护变得非常容易。Vue组件化思想 组件化是Vue中的重要思想,当我们对vue的基本知识有了一定的基础就要开始封装组件了 它提供了一种抽象,让我们可以开发出一个个独立可复用的小组件来构造我们的应用。组件树。组件化思想的应用 1.在项目中充分利用组件化的思想 2.尽可能的将也页面拆分成一个个小的可复用的组件 3.好处:代码更加方便组织和管理,扩展性也更强一.注

    2022年9月23日
  • Debian中文乱码_乱码处理

    Debian中文乱码_乱码处理中文系统虽说不是必须,但是至少要能看、能写汉字,不是么?我也是用终端,突然说用w3m访问页面玩玩,然后,你懂的……      下面就网上信息及自己遇到的问题,直接上步骤和解决方法了:一、要支持区域设置,首先要安装locales软件包:apt-getinstalllocales二、然后配置locales软件包:dpkg-reconfigurelocales在界面中我勾选的

    2022年10月10日
  • MapReduce编程模型[通俗易懂]

    MapReduce编程模型[通俗易懂]1.MapReduce简介MapReduce是一个分布式运算程序的编程框架,核心功能是将用户编写的业务逻辑代码和自带默认组件整合成一个完整的分布式运算程序,并发运行在Hadoop集群上。一个完整的mapreduce程序在分布式运行时有三类实例进程:MRAppMaster负责整个程序的过程调度及状态协调MapTask负责map阶段的整个数据处理流程ReduceTask负责reduce阶段的整个数据处理流程2.MapReduce核心编程思想1)分布式的运算程序往往需要分成至少2个阶段。2

    2022年6月26日

发表回复

您的邮箱地址不会被公开。 必填项已用 * 标注

关注全栈程序员社区公众号



