
struts+hibernate这两个框架在一起使用,其实二者之间并没有什么联系。struts负责前端与后台代码的交互通讯,也就是view视图与control(控制器)之间的通讯。hibernate则负责dao层与数据库或javaBean之间的交互。所以说二者之间并没有直接的联系,就是负责的部分之间没有重叠的地方。
原理或整个流程就是:
1,前端jsp发送请求,首先web.xml拦截器拦截所有请求,遇到.action结尾的请求,会发送到struts.xml中,找到对应的name,进图到进入到相应的dao层处理(此之前都是struts负责的部分),
2,在dao层做业务逻辑处理,当在与数据库交互时,比如说增删改查,首先通过Configuration config = new Configutration().configure();
3,读取并解析hibernate.cfg.xml配置文件,由此文件中的<mapping resource=”包名.类名.hbm.xml”/>读取并解析映射文件。
4,再SessionFactory sf = config.buildSessionFactory();创建sessionFactory;然后Session session=sf.openSession();打开session,session即会话。
5,接着Transaction ts=session.beginTransaction();创建并启动事务transaction。persistence operate 操作数据,持久化操作,如session.save();
6,最后ts.commit()提价事务,关闭session和sessionFactory;(至此hibernate部分完成)。
7,操作完数据库后dao层返回数据,回到struts.xml,根据name 找到相应的result,返回给前端页面。
简单工程创建步骤(工程下载地址见文末):
说明:这里以一个简单的登陆页面为例,用struts+hibernate框架实现
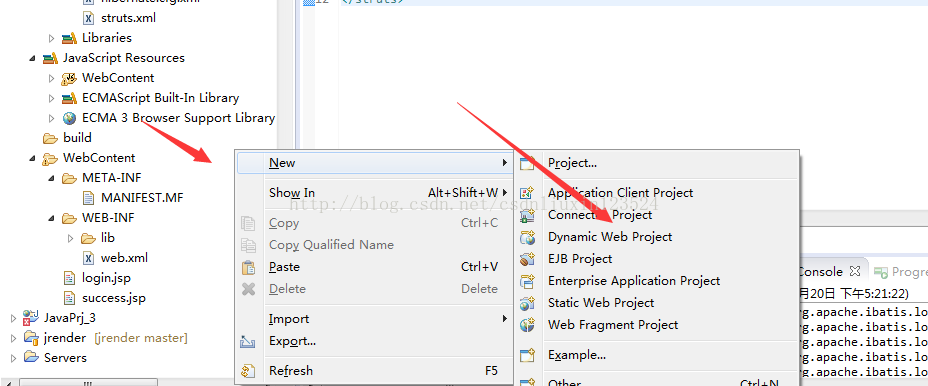
1,ecllipse中右键–》new —>Dynamic Web Project创建动态工程,填写工程名,再统统下一步即可。(hibernate创建步骤跟创建servlet工程步骤一样,可参见小编的另一篇博文:http://blog.csdn.net/csdnliuxin123524/article/details/77915367)

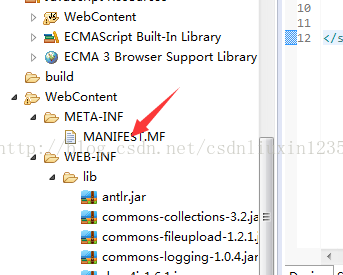
2,在WebContent/WEB-INF/lib目录下导入struts+hibernate所需要的jar包,具体jar包小编会再文章末尾上传此工程,工程中包含jar包。
3,修改web.xml文件:
<?xml version="1.0" encoding="UTF-8"?>
<web-app version="2.5"
	xmlns="http://java.sun.com/xml/ns/javaee"
	xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
	xsi:schemaLocation="http://java.sun.com/xml/ns/javaee
	http://java.sun.com/xml/ns/javaee/web-app_2_5.xsd">
  <welcome-file-list>
    <welcome-file>login.jsp</welcome-file>
  </welcome-file-list>
  	<filter>								<!--定义核心Filter FilterDispatcher -->
		<filter-name>struts2</filter-name>	<!-- 定义核心Filter的名称 -->
		<filter-class>						<!--定义核心Filter的实现类 -->
			org.apache.struts2.dispatcher.FilterDispatcher
		</filter-class>
	</filter>
	<filter-mapping>
		<filter-name>struts2</filter-name><!--核心Filter的名称 -->
		<url-pattern>/*</url-pattern><!--使用该核心Filter过滤所有的Web请求 -->
	</filter-mapping>
</web-app>
4,hibernate连接数据配置:
<?xml version='1.0' encoding='UTF-8'?>
<!DOCTYPE hibernate-configuration PUBLIC
          "-//Hibernate/Hibernate Configuration DTD 3.0//EN"
          "http://hibernate.sourceforge.net/hibernate-configuration-3.0.dtd">
<hibernate-configuration>
    <session-factory>
        <property name="dialect">
        	org.hibernate.dialect.MySQLDialect</property>		<!-- 数据库方言 -->
        <property name="connection.url">
        	jdbc:mysql://localhost:3306/db_examsystem</property><!-- 数据库连接URL -->
        <property name="connection.username">root</property>	<!-- 数据库用户名 -->
        <property name="connection.password">12345</property>	<!-- 数据库用户密码 -->
        <property name="connection.driver_class">				<!-- 数据库驱动类 -->
        	com.mysql.jdbc.Driver</property>
        <mapping resource="hibernate/po/Student.hbm.xml"/>
    </session-factory>
</hibernate-configuration>
5,struts配置
<?xml version="1.0" encoding="UTF-8" ?><!-- XML声明 -->
<!DOCTYPE struts PUBLIC
 "-//Apache Software Foundation//DTD Struts Configuration 2.1//EN"
 "http://struts.apache.org/dtds/struts-2.1.dtd"><!-- 指定Struts 2配置文件的DTD信息 -->
<struts><!-- 根节点 -->
	<constant name="struts.i18n.encoding" value="gb2312"></constant>
	<package name="struts2r" extends="struts-default">
 		<action name="login" class="hibernate.action.LoginAction">
 			<result name="studentSuccess">/success.jsp</result><!--登录失败页面-->
 		</action>
 	</package>
</struts>
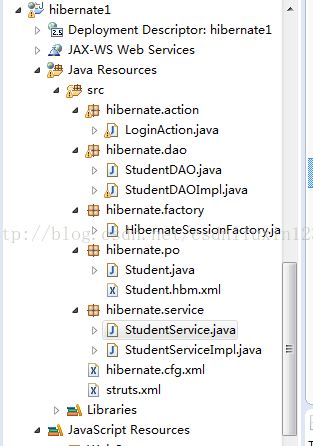
6,实体类,dao层,dao实现层,控制器层,hibernate工厂等结构:
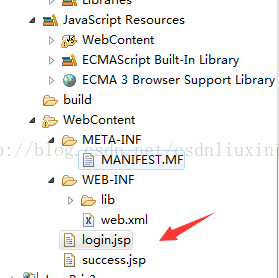
7,两个页面,一个是登陆页面,一个是登陆成功后的页面
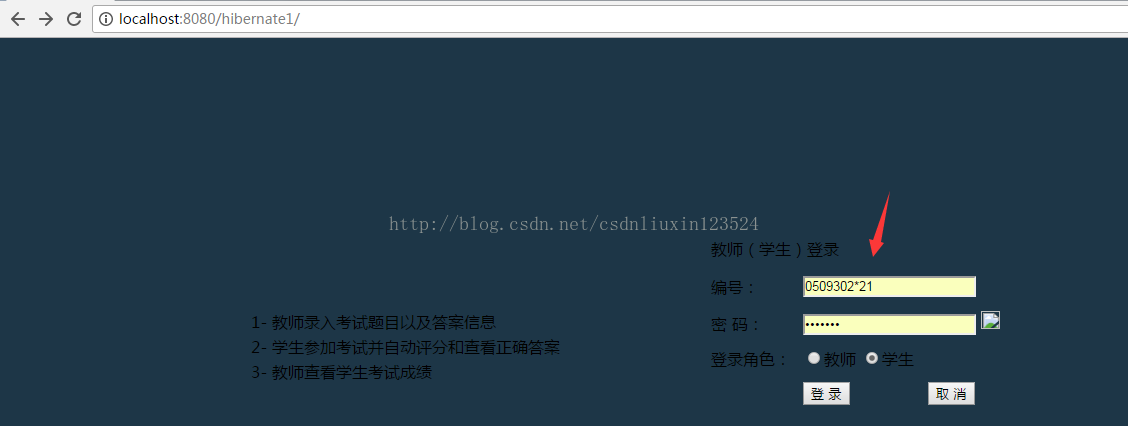
8,工程部署好后,再本地启动,可出现以下界面,登陆角色学学生,账号是0509302*21 ,密码是manager
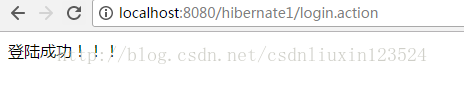
登陆成功后,有:
工程可在百度网盘下载:https://pan.baidu.com/s/1miSOFw8
发布者:全栈程序员-站长,转载请注明出处:https://javaforall.net/106307.html原文链接:https://javaforall.net



