
大家好,又见面了,我是你们的朋友全栈君。
1.朴素贝叶斯简介
朴素贝叶斯(Naive Bayes)是一个基于贝叶斯理论的分类器。它会单独考量每一唯独特征被分类的条件概率,进而综合这些概率并对其所在的特征向量做出分类预测。
因此,朴素贝叶斯的基本数据假设是:各个维度上的特征被分类的条件概率之间是相互独立的。它经常被应用在文本分类中,包括互联网新闻的分类,垃圾邮件的筛选。
2.例子:新闻分类
数据:18846条新闻,标签为0-19个数字,一共20类。
某个样本:
From: Mamatha Devineni Ratnam <mr47+@andrew.cmu.edu>
Subject: Pens fans reactions
Organization: Post Office, Carnegie Mellon, Pittsburgh, PA
Lines: 12
NNTP-Posting-Host: po4.andrew.cmu.edu
I am sure some bashers of Pens fans are pretty confused about the lack
of any kind of posts about the recent Pens massacre of the Devils. Actually,
I am bit puzzled too and a bit relieved. However, I am going to put an end
to non-PIttsburghers’ relief with a bit of praise for the Pens. Man, they
are killing those Devils worse than I thought. Jagr just showed you why
he is much better than his regular season stats. He is also a lot
fo fun to watch in the playoffs. Bowman should let JAgr have a lot of
fun in the next couple of games since the Pens are going to beat the pulp out of Jersey anyway. I was very disappointed not to see the Islanders lose the final
regular season game. PENS RULE!!!
代码:
#coding=utf-8

from sklearn.datasets import fetch_20newsgroups  # 从sklearn.datasets里导入新闻数据抓取器 fetch_20newsgroups
from sklearn.model_selection import  train_test_split
from sklearn.feature_extraction.text import CountVectorizer  # 从sklearn.feature_extraction.text里导入文本特征向量化模块
from sklearn.naive_bayes import MultinomialNB     # 从sklean.naive_bayes里导入朴素贝叶斯模型
from sklearn.metrics import classification_report

#1.数据获取
news = fetch_20newsgroups(subset='all')
print len(news.data)  # 输出数据的条数:18846

#2.数据预处理:训练集和测试集分割,文本特征向量化
X_train,X_test,y_train,y_test = train_test_split(news.data,news.target,test_size=0.25,random_state=33) # 随机采样25%的数据样本作为测试集
#print X_train[0]  #查看训练样本
#print y_train[0:100]  #查看标签

#文本特征向量化
vec = CountVectorizer()
X_train = vec.fit_transform(X_train)
X_test = vec.transform(X_test)

#3.使用朴素贝叶斯进行训练
mnb = MultinomialNB()   # 使用默认配置初始化朴素贝叶斯
mnb.fit(X_train,y_train)    # 利用训练数据对模型参数进行估计
y_predict = mnb.predict(X_test)     # 对参数进行预测

#4.获取结果报告
print 'The Accuracy of Naive Bayes Classifier is:', mnb.score(X_test,y_test)
print classification_report(y_test, y_predict, target_names = news.target_names)
运行结果:


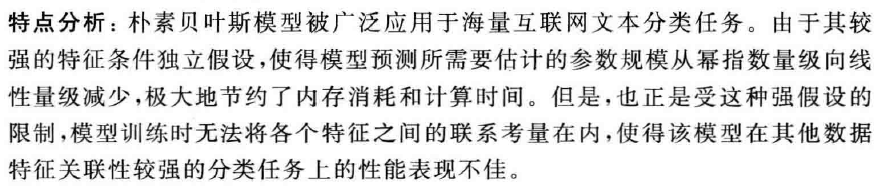
分析:
3.补充:文本特征向量化
朴素贝叶斯模型去给文本数据分类,就必须对文本数据进行处理。
处理的流程一般是:
- 对文本分词(作为特征)
- 统计各词在句子中是否出现(词集模型)
- 统计各词在句子中出现次数(词袋模型)
- 统计各词在这个文档的TFIDF值(词袋模型+IDF值)
文本特征向量化方法有:
(1)词集模型:one-hot编码向量化文本;
(2)词袋模型+IDF:TFIDF向量化文本;
(3)哈希向量化文本。
具体的原理如下:
1.one-hot表示法先将文本数据集中不重复的单词提取出来,得到一个大小为V的词汇表。然后用一个V维的向量来表示一个文章,向量中的第d个维度上的1表示词汇表中的第d个单词出现在这篇文章中。
如果文本数据集太大,那么得到的词汇表中可能存在几千个单词,这样会文本的维度太大,不仅会导致计算时间增加,而且带来了稀疏问题(one-hot矩阵中大多数元素都是0)。因此,我们通常在计算词汇表的时候,会排除那些出现次数太少的单词,从而降低文本维度。
2.tf-idf (term frequency–inverse document frequency),不仅考虑了单词在文章中的出现次数,还考虑了其在整个文本数据集中的出现次数。TF-IDF的主要思想是:如果某个词或短语在一篇文章中出现的频率TF高,并且在其他文章中很少出现,则认为此词或者短语具有很好的类别区分能力。
3.TfidfVectorizer在执行时,需要先将词袋矩阵放入内存,再计算各位置单词的TFIDF值,如果词袋维度大,将占用过多内存,效率低,此时可以使用哈希向量化。哈希向量化可以缓解TfidfVectorizer在处理高维文本时内存消耗过大的问题。
参考:
1.https://www.jianshu.com/p/dcc27a28b3f4
2.https://blog.csdn.net/juanqinyang/article/details/58222264
转载于:https://www.cnblogs.com/youngsea/p/9327972.html
发布者:全栈程序员-站长,转载请注明出处:https://javaforall.net/107412.html原文链接:https://javaforall.net



