
大家好,又见面了,我是你们的朋友全栈君。
Intel最近 发布了AVX-512,据说对浮点运算有很大提升,我的机器目前不支持AVX-512,但是支持AVX2,按照之前Intel给出的数据,据说能提速将近8倍:
Introduction to Intel® Advanced Vector Extensions
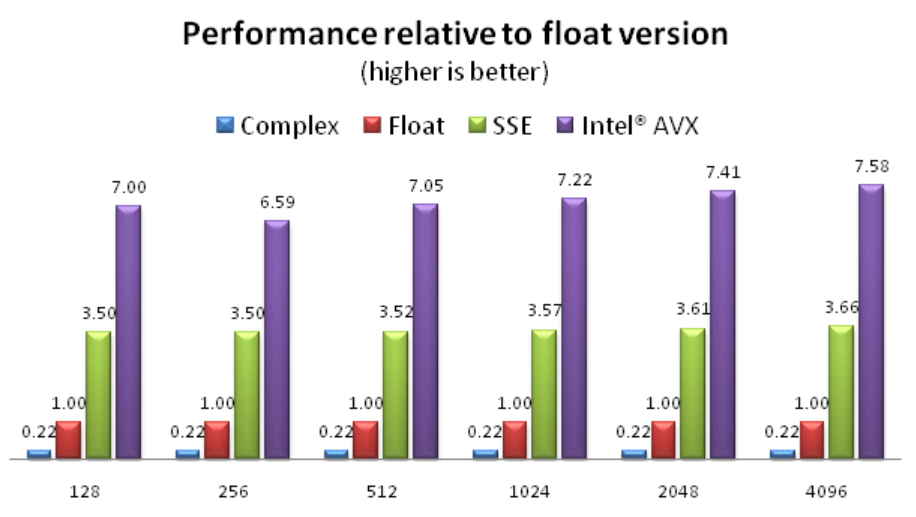

测试环境
可能这篇文章有点偏老,我这边也想验证一下没有优化的C/C++浮点运算和AVX2优化后的浮点运算到底快多少。这是我机器的配置:
Manufacturer GenuineIntel
Name Intel Core i7 7820HQ
Codename Kaby Lake
Specification Intel® Core™ i7-7820HQ CPU @ 2.90GHz
Max frequency 3900 MHz
Instructions sets MMX, SSE, SSE2, SSE3, SSSE3, SSE4.1, SSE4.2, EM64T, VT-x, AES, AVX, AVX2, FMA3, TSX
测试代码
我用的编译器是VS2017,这是对应的测试代码 :
#include <stdio.h>
#include <immintrin.h>
#include <random>
#include <chrono>

#define NUM_FLOATS 102400000

int main()
{

	// At first, prepare 2 float arrays
	float* fas = new float[NUM_FLOATS];
	float* fbs = new float[NUM_FLOATS];
	float* fcs = new float[NUM_FLOATS];

	std::random_device rd;
	std::mt19937 gen(rd());
	std::uniform_real_distribution<float> dis(-1.0f, 1.0f);

	for (int i = 0; i < NUM_FLOATS; i++)
	{

		fas[i] = dis(gen);
		fbs[i] = dis(gen);
	}

	// Begin to do the AVX operation
	__m256 ymm0, ymm1;

	auto tp0 = std::chrono::high_resolution_clock::now();

#if 0
	for (int i = 0; i < NUM_FLOATS / 8; i++)
	{

		ymm0 = _mm256_loadu_ps(fas + (i << 3));
		ymm1 = _mm256_loadu_ps(fbs + (i << 3));

		ymm0 = _mm256_mul_ps(ymm0, ymm1);

		_mm256_storeu_ps(fcs + (i << 3), ymm0);
	}

#else
	for (int i = 0; i < NUM_FLOATS; i++)
	{

		fcs[i] = fas[i] * fbs[i];
	}
#endif

	// Finish doing the AVX operation

	auto tp1 = std::chrono::high_resolution_clock::now();

	printf("It takes %lld msec to finish %d round of float multiply.\n",
		std::chrono::duration_cast<std::chrono::milliseconds>(tp1 - tp0).count(), NUM_FLOATS);

	for (int i = 0; i < 10; i++)
	{

		printf("%f*%f = %f\n", fas[i], fbs[i], fcs[i]);
	}

	delete[] fas;
	delete[] fbs;
	delete[] fcs;

	return -1;
}
中间有一个条件编译模块,可以在AVX2和C/C++之间做切换,我随机选了102,400,000(一亿个单精度浮点数字左右)进行乘法运算。
测试结果
这是对应的测试结果:
| C/C++代码 | AVX2代码 | |
|---|---|---|
| 不使用缺省编译器优化 | 第一次:347ms 第二次:298ms 第三次:296ms |
第一次:154ms 第二次:153ms 第三次:151ms |
| 使用缺省编译器优化 | 第一次:120ms 第二次:119ms 第三次:117ms |
第一次:116ms 第二次:119ms 第三次:162ms |
结论
可以看出来, VS2017对浮点有做比较好的优化,估计我测试的这种场景比较简单,编译器对这种情况做了很好的优化,基本上和自己用AVX指令写出来的性能差不多。
如果不用编译器优化,这个时候,AVX2大概比普通的C/C++浮点运算代码快2倍左右,不像宣传的那样厉害嘛。
发布者:全栈程序员-站长,转载请注明出处:https://javaforall.net/139128.html原文链接:https://javaforall.net



