
用Pandas 处理大数据的3种超级方法

用Pandas 处理大数据的3种超级方法原文链接:3simplewaystohandlelargedatawithPandas作者|GeorgeSeif译者|jojoa易上手,文档丰富的Pandas已经成为时下最火的数据处理库。此外,Pandas数据处理能力也一流。其实无论你使用什么库,大量的数据处理起来往往回遇到新的挑战。数据处理时,往往会遇到没有足够内存(RAM)这个硬件问题。企业往往…

大家好,又见面了,我是你们的朋友全栈君。

在这里插入图片描述

原文链接:3 simple ways to handle large data with
Pandas

作者 | George Seif
译者 | jojoa

易上手, 文档丰富的Pandas 已经成为时下最火的数据处理库。此外,Pandas数据处理能力也一流。

其实无论你使用什么库,大量的数据处理起来往往回遇到新的挑战。
数据处理时,往往会遇到没有足够内存(RAM)这个硬件问题。 企业往往需要能够存够数百, 乃至数千 的GB 数据。
即便你的计算机恰好有足够的内存来存储这些数据, 但是读取数据到硬盘依旧非常耗时。
别担心! Pandas 数据库会帮我们摆脱这种困境。 这篇文章包含3种方法来减少数据大小,并且加快数据读取速度。 我用这些方法,把超过100GB 的数据, 压缩到了64GB 甚至32GB 的内存大小。

快来看看这三个妙招吧。

数据分块

csv 格式是一种易储存, 易更改并且用户易读取的格式。 pandas 有read_csv ()方法来上传数据,存储为CSV 格式。当遇到CSV 文件过大,导致内存不足的问题该怎么办呢?试试强大的pandas 工具吧!我们先把整个文件拆分成小块。这里,我们把拆分的小块称为chunk。

一个chunk 就是我们数据的一个小组。 Chunk 的大小主要依据我们内存的大小,自行决定。

过程如下:

1.读取一块数据。
2.分析数据。
3.保存该块数据的分析结果。
4.重复1-3步骤,直到所有chunk 分析完毕。
5.把所有的chunk 合并在一起。

我们可以通过read_csv()方法Chunksize来完成上述步骤。 Chunksize是指pandas 一次能读取到多少行csv文件。这个当然也是建立在RAM 内存容量的基础上。
假如我们认为数据呈现高斯分布时, 我们可以在一个chunk 上, 进行数据处理和视觉化, 这样会提高准确率。

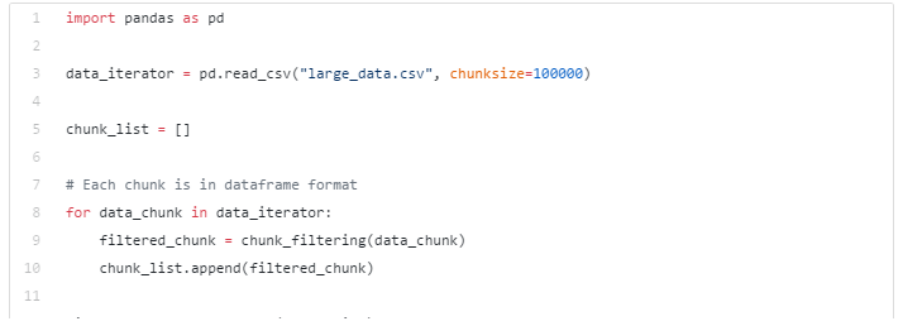
当数据稍微复杂时, 例如呈现泊松分布时, 我们最好能一块块筛选,然后把每一小块整合在一起。 然后再进行分析。很多时候, 我们往往删除太多的不相关列,或者删除有值行。 我们可以在每个chunk 上,删除不相关数据, 然后再把数据整合在一起,最后再进行数据分析。

代码如下:
在这里插入图片描述
删除数据

有时候, 我们一眼就能看到需要分析的列。事实上, 通常名字,账号等列,我们是不做分析的。

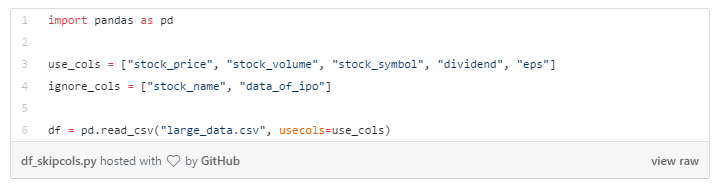
读取数据前, 先跳过这些无用的列,可以帮我们节省很多内存。 Pandas 可以允许我们选择想要读取的列。
在这里插入图片描述
把包含无用信息的列删除掉, 往往给我们节省了大量内存。

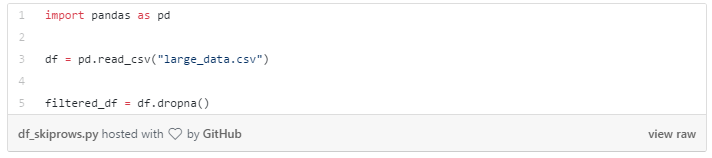
此外,我们还可以把有缺失值的行,或者是包含“NA” 的行删除掉。 通过dropna()方法可以实现:
在这里插入图片描述
有几个非常有用的参数,可以传给dropna():

  • how: 可选项:“any”(该行的任意一列如果出现”NA”, 删除该行)
  • “all” (只有某行所有数数据全部是”NA” 时才删除)
  • thresh: 设定某行最多包含多少个NA 时,才进行删除
  • subset: 选定某个子集,进行NA 查找

可以通过这些参数, 尤其是thresh 和 subset 两个参数可以决定某行是否被删除掉。

Pandas 在读取信息的时候,无法删除列。但是我们可以在每个chunk 上,进行上述操作。

为列设定不同的数据类型

数据科学家新手往往不会对数据类型考虑太多。 当处理数据越来越多时, 就非常有必要考虑数据类型了。

行业常用的解决方法是从数据文件中,读取数据, 然后一列列设置数据类型。 但当数据量非常大时, 我们往往担心内存空间不够用。

在CSV 文件中,例如某列是浮点数, 它往往会占据更多的存储空间。 例如, 当我们下载数据来预测股票信息时, 价格往往以32位浮点数形式存储。

但是,我们真的需要32位浮点数码? 大多数情况下, 股票价格以小数点后保留两位数据进行交易。 即便我们想看到更精确的数据, 16位浮点数已经足够了。

我们往往会在读取数据的时候, 设置数据类型,而不是保留数据原类型。 那样的话,会浪费掉部分内存。

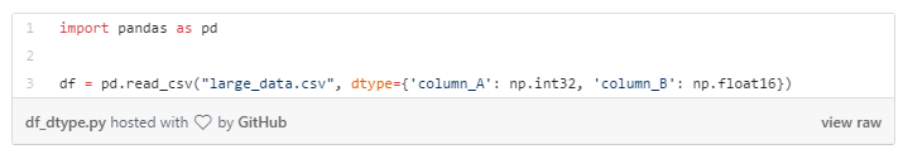
通过read_csv() 中设置dtype参数来完成数据类型设置。还可以设置字典类型,设置该列是键, 设置某列是字典的值。

请看下面的pandas 例子:
在这里插入图片描述
文章到这里结束了! 希望上述三个方法可以帮你节省时间和内存。

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容, 请发送邮件至 举报,一经查实,本站将立刻删除。

发布者:全栈程序员-站长,转载请注明出处:https://javaforall.net/142237.html原文链接:https://javaforall.net

赞 (0)
全栈程序员-站长的头像全栈程序员-站长


相关推荐

  • 使用cloudsim进行云计算仿真,至少分为哪几个步骤_模拟语音信号处理步骤

    使用cloudsim进行云计算仿真,至少分为哪几个步骤_模拟语音信号处理步骤cloud3.0当中的8个examples,给出的模拟步骤大体相似,只是在初始化当中,数量上有所变化,步骤一般如下:Stp1:   用时间和用户数,traceflag初始化cloudSim Stp2: 创建数据中心DatacenterStp3:  创建数据中心的BrokerStp4:创建 虚拟机VM,虚拟机列表被提交到brokerStp5:   创建微云clo

    2022年10月13日
  • OpenResty 最佳实践学习–安装和helloworld(1)

    一:简介OpenResty® 是一个基于 Nginx 与 Lua 的高性能 Web 平台,其内部集成了大量精良的 Lua 库、第三方模块以及大多数的依赖项。用于方便地搭建能够处理超高并发、扩展性极高的动态 Web 应用、Web 服务和动态网关。OpenResty® 通过汇聚各种设计精良的 Nginx 模块(主要由 OpenResty 团队自主开发)

    2022年2月26日
  • 坚果课堂回顾:团队项目管理&SOP打造顶尖执行力

    坚果课堂回顾:团队项目管理&SOP打造顶尖执行力【摘要】:已经非常努力高效的利用时间了,可为什么事情还是做不完?todolist产生的速度,超过能处理完成事情的速度? 作为知识密集型行业的代表人群,律师行业始终在探索如何高效利用时间,在有限的时间内创造出更多价值。在律师行业效率变革的驱动下,秉承效率至上的云盘服务提供商坚果云,一直致力于助力律师行业找到高效工作方式。在6月12日…

    2022年5月22日
  • Landsat 8数据介绍「建议收藏」

    Landsat 8数据介绍「建议收藏」1.简介  1.1数据简介  2013年2月11日,美国航空航天局(NASA)成功发射Landsat-8卫星。Landsat-8卫星上携带两个传感器,分别是OLI陆地成像仪(OperationalLandImager)和TIRS热红外传感器(ThermalInfraredSensor)。  Landsat-8在空间分辨率和光谱特性等方面与Landsat1-7保持了基本一致,卫星一共…

    2022年7月23日
  • 多线程中 ManualResetEvent 的用法[通俗易懂]

    多线程中 ManualResetEvent 的用法[通俗易懂]///<summary>///手动重启///</summary>privateManualResetEventmanualReset=newManualR

    2022年7月1日
  • JAVA统计服务器资源(cpu,内存,磁盘)–LINUX

    JAVA统计服务器资源(cpu,内存,磁盘)–LINUX标题JAVA统计服务器资源(cpu,内存,磁盘)–LINUX使用类:com.sun.management.OperatingSystemMXBean继承:java.lang.management.OperatingSystemMXBeanJDK版本1.8API说明项目用的jdk是1.8,接口也能调,不知道为什么1.8的api里没有这个类,只有这个类继承的java.lang.management.OperatingSystemMXBean的API,在JDK13API中找到想要的东西了模

    2022年6月10日

发表回复

您的邮箱地址不会被公开。 必填项已用 * 标注

关注全栈程序员社区公众号


