
大家好,又见面了,我是你们的朋友全栈君。
前言
标注数据集对深度学习而言是很重要的一步,但是标注数据是件很繁琐的工作,而半自动标注可以减轻工作量。
Github(https://github.com/virajmavani/semi-auto-image-annotation-tool)上有一款自动标注工具,它以RetinaNet作为建议算法,使用预训练的RetinaNet模型从MS COCO数据集建议80个类对象。
这款工具我没有安装使用,从Demo来看效果还是挺好的,大部分目标都能检测出来。
我这里要说的半自动标注是什么?
其实就是通过训练好的模型检测目标,输出包含目标类别和位置的txt文件,然后再将其转换为xml文件,最后再使用标注工具进行完善。
当然,前提是模型的精度越高越好,如果检测结果不准确,就会增加工作量,导致无法使用。
训练模型
首先我们要训练出一个可用的模型,精度越高越好。
使用模型对数据集进行测试
以车辆检测为例,测试结果如下图所示:
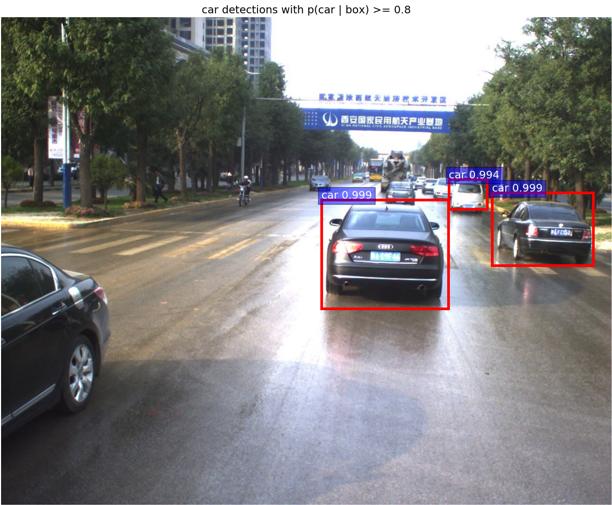

得到包含目标类别和位置的txt文件,部分内容如下:
00001.png car 1028 367 1241 520
00001.png car 671 382 938 610
00001.png car 939 339 1019 402
把txt文件转换为xml文件,代码如下:
#! /usr/bin/python
# -*- coding:UTF-8 -*-
import os, sys
import glob
from PIL import Image

# 图像存储位置
src_img_dir = ""  # 添加你的路径
# 图像的 ground truth 的 txt 文件存放位置
src_txt_dir = ""
src_xml_dir = ""

img_Lists = glob.glob(src_img_dir + '/*.jpg')

img_basenames = [] # e.g. 100.jpg
for item in img_Lists:
    img_basenames.append(os.path.basename(item))

img_names = [] # e.g. 100
for item in img_basenames:
    temp1, temp2 = os.path.splitext(item)
    img_names.append(temp1)

for img in img_names:
    im = Image.open((src_img_dir + '/' + img + '.jpg'))
    width, height = im.size

    # open the crospronding txt file
    gt = open(src_txt_dir + '/' + img + '.txt').read().splitlines()

    # write in xml file
    xml_file = open((src_xml_dir + '/' + img + '.xml'), 'w')
    xml_file.write('<annotation>\n')
    xml_file.write(' <folder>VOC2007</folder>\n')
    xml_file.write(' <filename>' + str(img) + '.jpg' + '</filename>\n')
    xml_file.write(' <size>\n')
    xml_file.write(' <width>' + str(width) + '</width>\n')
    xml_file.write(' <height>' + str(height) + '</height>\n')
    xml_file.write(' <depth>3</depth>\n')
    xml_file.write(' </size>\n')

    # write the region of image on xml file
    for img_each_label in gt:
        spt = img_each_label.split(' ') #这里如果txt里面是以逗号‘,’隔开的,那么就改为spt = img_each_label.split(',')。
        xml_file.write(' <object>\n')
        xml_file.write(' <name>' + str(spt[4]) + '</name>\n')
        xml_file.write(' <pose>Unspecified</pose>\n')
        xml_file.write(' <truncated>0</truncated>\n')
        xml_file.write(' <difficult>0</difficult>\n')
        xml_file.write(' <bndbox>\n')
        xml_file.write(' <xmin>' + str(spt[0]) + '</xmin>\n')
        xml_file.write(' <ymin>' + str(spt[1]) + '</ymin>\n')
        xml_file.write(' <xmax>' + str(spt[2]) + '</xmax>\n')
        xml_file.write(' <ymax>' + str(spt[3]) + '</ymax>\n')
        xml_file.write(' </bndbox>\n')
        xml_file.write(' </object>\n')

    xml_file.write('</annotation>')
对应的XML文件:
  <annotation>
    <folder>VOC2007</folder>
    <filename>00001.png</filename>
    <size>
        <width>1280</width>
        <height>1024</height>
        <depth>3</depth>
    </size>
    <object>
        <name>car</name>
        <pose>Unspecified</pose>
        <truncated>0</truncated>
        <difficult>0</difficult>
        <bndbox>
            <xmin>1028</xmin>
            <ymin>367</ymin>
            <xmax>1241</xmax>
            <ymax>520</ymax>
        </bndbox>
    </object>
    <object>
        <name>car</name>
        <pose>Unspecified</pose>
        <truncated>0</truncated>
        <difficult>0</difficult>
        <bndbox>
            <xmin>671</xmin>
            <ymin>382</ymin>
            <xmax>938</xmax>
            <ymax>610</ymax>
        </bndbox>
    </object>
    <object>
        <name>car</name>
        <pose>Unspecified</pose>
        <truncated>0</truncated>
        <difficult>0</difficult>
        <bndbox>
            <xmin>939</xmin>
            <ymin>339</ymin>
            <xmax>1019</xmax>
            <ymax>402</ymax>
        </bndbox>
    </object>
</annotation>
打开标注软件完善标注
如下图所示,上一步的结果可能会出现以下情况:
- 检测结果不准确
- 有目标未被检测出来
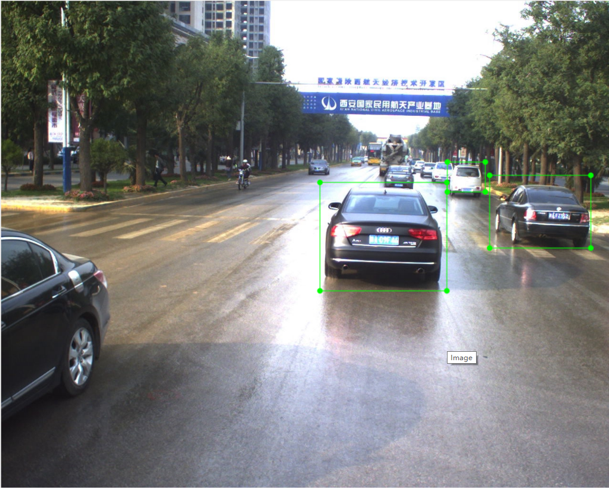
因此,还需要我们手动标注进行完善。
总结
如果半自动标注工具的效果能达到要求,就会大幅减小标注的工作量。
但是,精度和效率很难达到平衡,目前来看,主流方法还是全人工标注。
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容, 请发送邮件至 举报,一经查实,本站将立刻删除。
发布者:全栈程序员-站长,转载请注明出处:https://javaforall.net/147535.html原文链接:https://javaforall.net



