
大家好,又见面了,我是你们的朋友全栈君。
Python小爬虫——贴吧图片的爬取
在对Python有了一定的基础学习后,进行贴吧图片抓取小程序的编写。
目标:
- 首先肯定要实现图片抓取这个基本功能
- 然后实现对用户所给的链接进行抓取
- 最后要有一定的交互,程序不能太傻吧
一、页面获取
要让python可以进行对网页的访问,那肯定要用到urllib之类的包。So先来个 import urllib
urllib中有 urllib.urlopen(str) 方法用于打开网页并返回一个对象,调用这个对象的read()方法后能直接获得网页的源代码,内容与浏览器右键查看源码的内容一样。
1 #coding:utf-8
2 import urllib
3
4 page = urllib.urlopen('http://tieba.baidu.com/p/1753935195')#打开网页
5 htmlcode = page.read()#读取页面源码
6 print htmlcode#在控制台输出
运行结果与查看源码其实差不多
运行结果就不放上来了
也可以写到文本文档中:
 1 #coding:utf-8
 2 import urllib
 3
 4 page = urllib.urlopen('http://tieba.baidu.com/p/1753935195')
 5 htmlcode = page.read()
 6 #print htmlcode
 7
 8 pageFile = open('pageCode.txt','w')#以写的方式打开pageCode.txt
 9 pageFile.write(htmlcode)#写入
10 pageFile.close()#开了记得关
运行一遍,txt就出现在了getJpg.py
 的目录下
好了别闹,我们把它封装成方法:
1 def get_html(url):
2     page = urllib.urlopen(url)
3     html = page.read()
4     return html
然后我们的页面获取代码就K.O.了
二、图片(目标)的提取
做完上面步骤,你打开txt一看,我去!这都是什么跟什么啊,根本找不到图片在哪好伐?
客官别急啊,我这就去给你叫我们的小。。。图片!图片!
首先我们要一个正则表达式 (什么你不会?请看菜鸟入门教程–>Go)
然后我们看源代码,Yeah 我们找到了其中一张图片是这样的
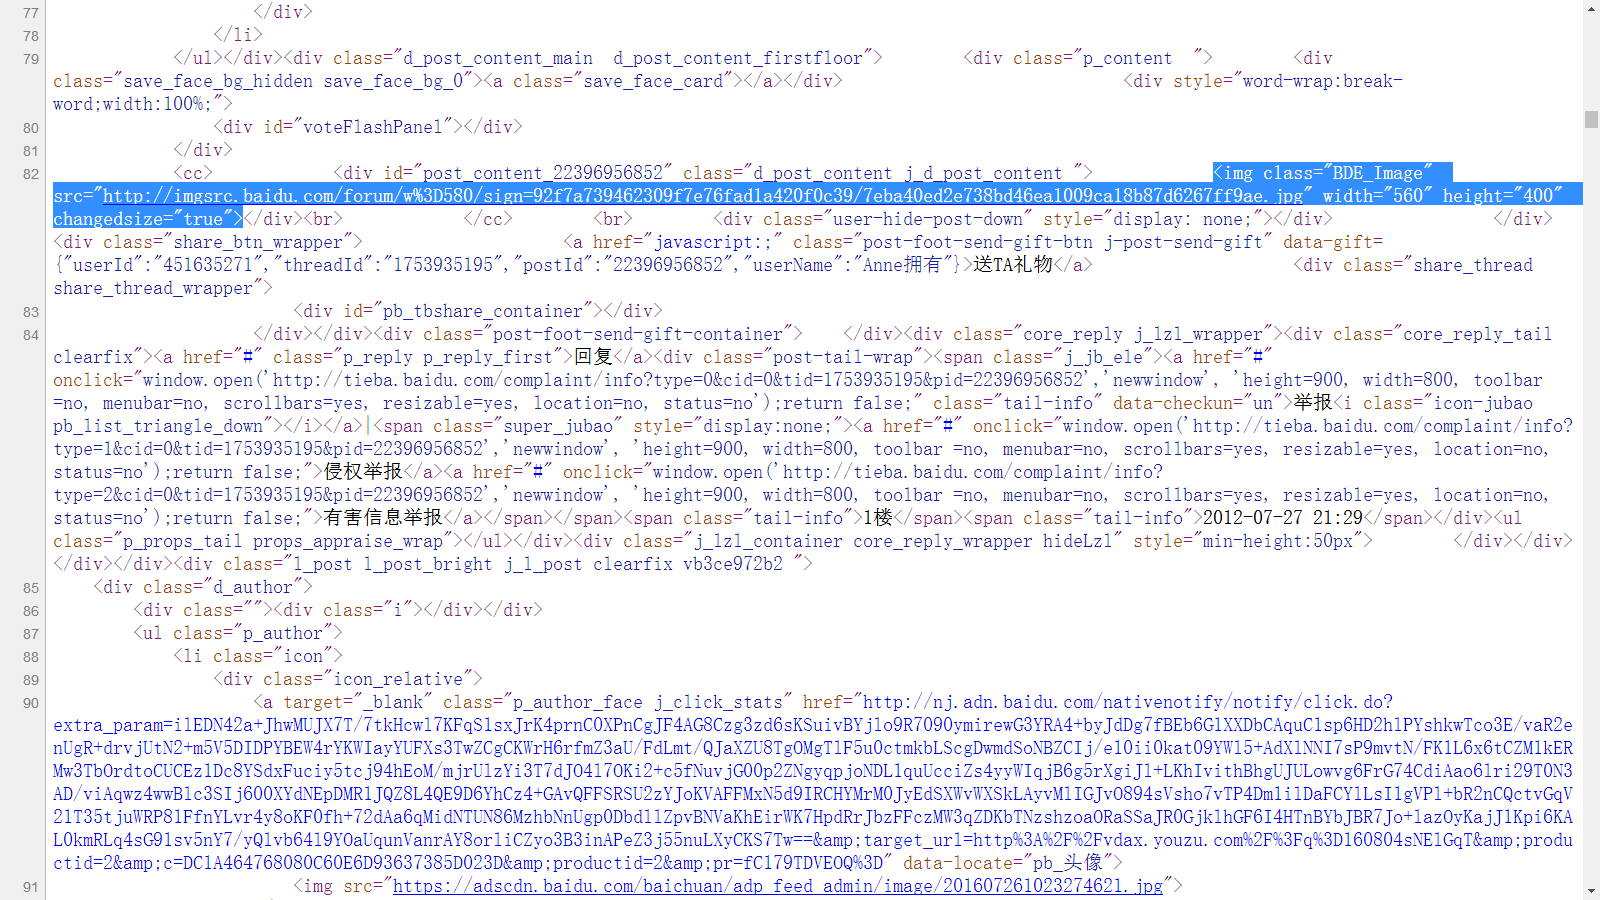
写出图片的正则表达式: reg = r‘src=”(.+?\.jpg)” width‘
解释下吧——匹配以src=”开头然后接一个或多个任意字符(非贪婪),以.jpg” width结尾的字符串。比如图中红框内src后 双引号里的链接就是一个匹配的字符串。
接着我们要做的就是从get_html方法返回的辣么长一串字符串中 拿到 满足正则表达式的 字符串。
用到python中的re库中的 re.findall(str) 它返回一个满足匹配的字符串组成的列表
 1 # coding:utf-8
 2 import urllib
 3 import re
 4
 5 def get_html(url):
 6     page = urllib.urlopen(url)
 7     html = page.read()
 8     return html
 9
10 reg = r'src="(.+?\.jpg)" width'#正则表达式
11 reg_img = re.compile(reg)#编译一下,运行更快
12 imglist = reg_img.findall(get_html('http://tieba.baidu.com/p/1753935195'))#进行匹配
13 for img in imglist:
14     print img
打印出这么多图片链接
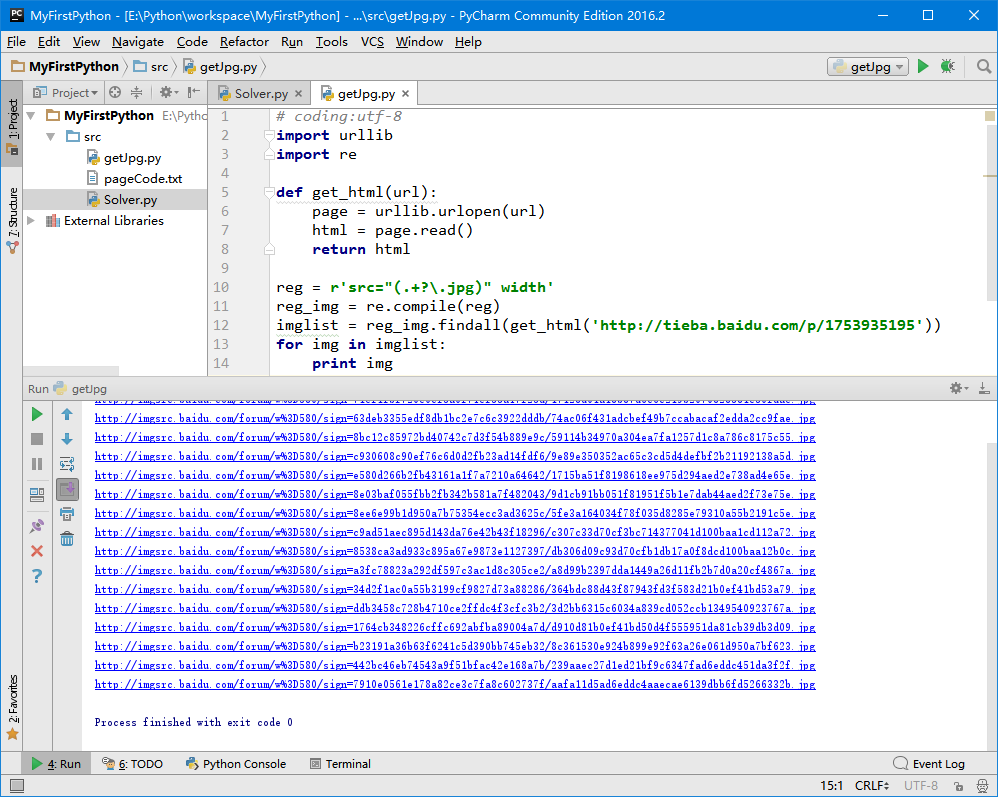
光把链接拿出来没用啊,我们的目标是下载下来~
urllib库中有一个 urllib.urlretrieve(链接,名字) 方法,它的作用是以第二个参数为名字下载链接中的内容,我们来试用一下
在上面代码循环中加上 urllib.urlretrieve(img, ‘tieba.jpg‘)
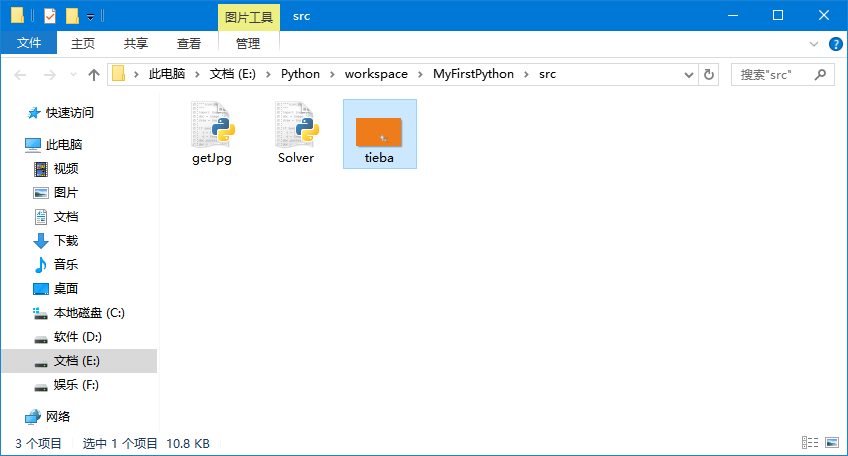
卧槽!!!怎么只下了一张
至少它下载了不是?啪啪啪啪啪(掌声)
检查下问题出在哪。。。。
没错我们只给了一个tieba.jpg的名字,后来的把前面的覆盖了。
调整下代码:
 1 # coding:utf-8
 2 import urllib
 3 import re
 4
 5 def get_html(url):
 6     page = urllib.urlopen(url)
 7     html = page.read()
 8     return html
 9
10 reg = r'src="(.+?\.jpg)" width'
11 reg_img = re.compile(reg)
12 imglist = reg_img.findall(get_html('http://tieba.baidu.com/p/1753935195'))
13 x = 0
14 for img in imglist:
15     urllib.urlretrieve(img, '%s.jpg' %x)
16     x += 1
啪啪啪啪啪

第一步完成~
三、指定链接抓取
我想要抓另一个帖子,总不能打开源代码,然后把那段地址改了在运行吧。
只是一个小程序,那也不行欸,加一个让用户指定地址的交互。
先把提取图片的那段代码打包下:
1 def get_image(html_code):
2     reg = r'src="(.+?\.jpg)" width'
3     reg_img = re.compile(reg)
4     img_list = reg_img.findall(html_code)
5     x = 0
6     for img in img_list:
7         urllib.urlretrieve(img, '%s.jpg' % x)
8         x += 1
最后来个请输入:
1 print u'请输入url:',
2 url = raw_input()
3 if url:
4     pass
5 else:
6     url = 'http://tieba.baidu.com/p/1753935195'
7 html_code = get_html(url)
8 get_image(html_code)
运行一下,试试另一个帖子:
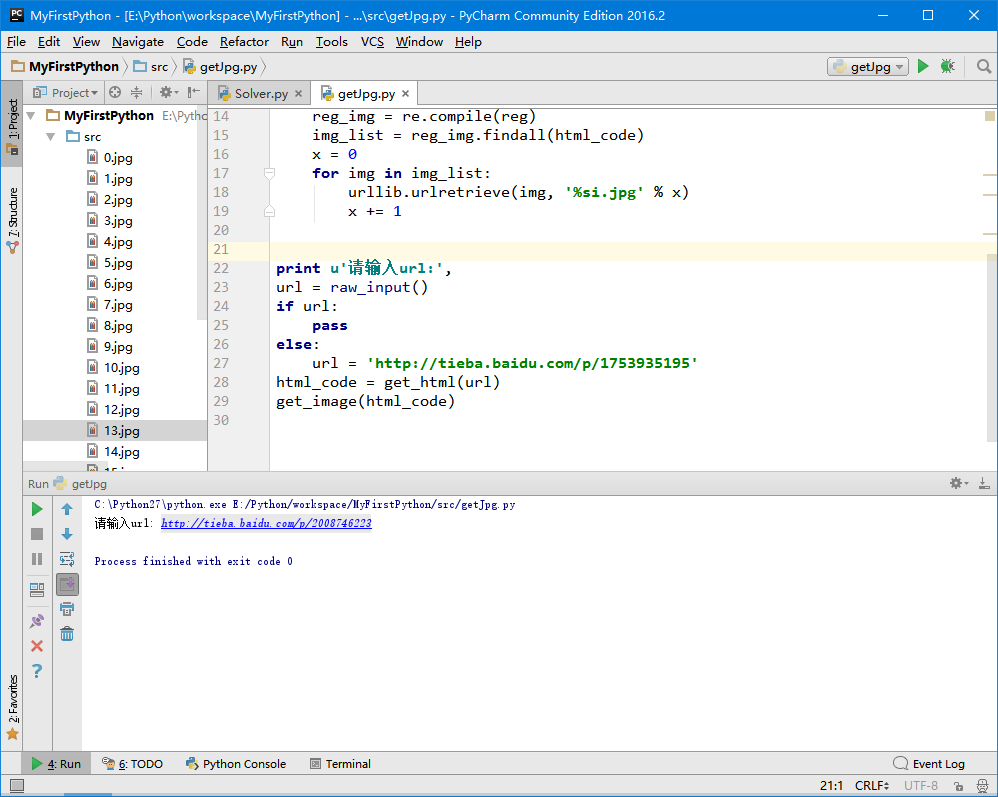
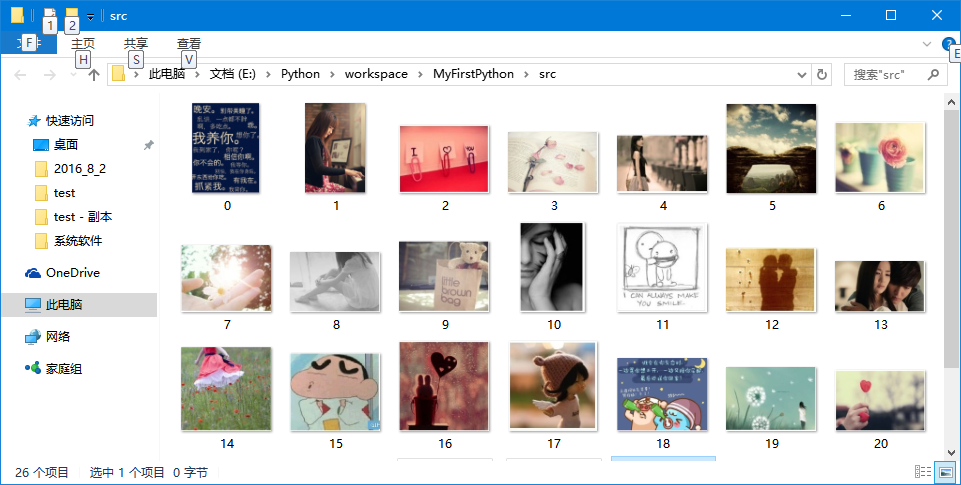
完美~~
四、交互的添加
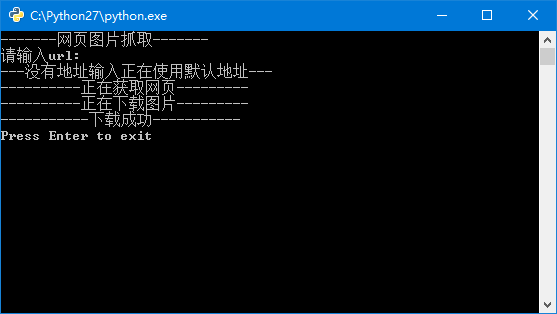
虽然写的是一个简单的小程序,但有强迫症的我还是给他加上了交互(不然多难受啊:双击,屏幕一闪,下载完了。。。)
最后的代码
 1 # coding:utf-8
 2 import urllib
 3 import re
 4
 5 def get_html(url):
 6     page = urllib.urlopen(url)
 7     html_code = page.read()
 8     return html_code
 9
10 def get_image(html_code):
11     reg = r'src="(.+?\.jpg)" width'
12     reg_img = re.compile(reg)
13     img_list = reg_img.findall(html_code)
14     x = 0
15     for img in img_list:
16         urllib.urlretrieve(img, '%s.jpg' % x)
17         x += 1
18
19 print u'-------网页图片抓取-------'
20 print u'请输入url:',
21 url = raw_input()
22 if url:
23     pass
24 else:
25     print u'---没有地址输入正在使用默认地址---'
26     url = 'http://tieba.baidu.com/p/1753935195'
27 print u'----------正在获取网页---------'
28 html_code = get_html(url)
29 print u'----------正在下载图片---------'
30 get_image(html_code)
31 print u'-----------下载成功-----------'
32 raw_input('Press Enter to exit')
相对来说比较舒服的交互体验,大功告成~
发布者:全栈程序员-站长,转载请注明出处:https://javaforall.net/155873.html原文链接:https://javaforall.net



