
大家好,又见面了,我是你们的朋友全栈君。如果您正在找激活码,请点击查看最新教程,关注关注公众号 “全栈程序员社区” 获取激活教程,可能之前旧版本教程已经失效.最新Idea2022.1教程亲测有效,一键激活。
Jetbrains全系列IDE稳定放心使用
概述
今天主要介绍一下Oracle、MySQL、sqlserver、pg数据库在删除重复数据时是怎么实现的。这里用实例来说明。
一、Oracle数据库去重
1、环境准备
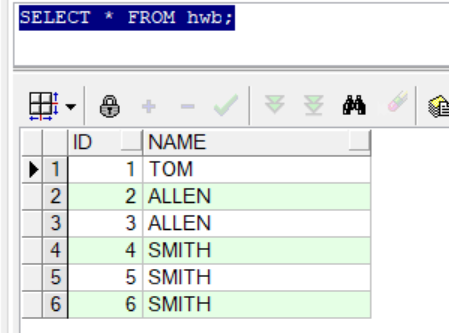
可以看到“ALLEN”和“SMITH”这两个人的数据重复了,现在要求表中name重复的数据只保留一行,其他的删除。
CREATE TABLE hwb(
    id int,
    name varchar(10)
);

INSERT INTO hwb VALUES(1, 'TOM');
INSERT INTO hwb VALUES(2, 'ALLEN');
INSERT INTO hwb VALUES(3, 'ALLEN');
INSERT INTO hwb VALUES(4, 'SMITH');
INSERT INTO hwb VALUES(5, 'SMITH');
INSERT INTO hwb VALUES(6, 'SMITH');
commit;
SELECT * FROM hwb;

2、实现方法一:通过分组后,拿最小的id重复删除
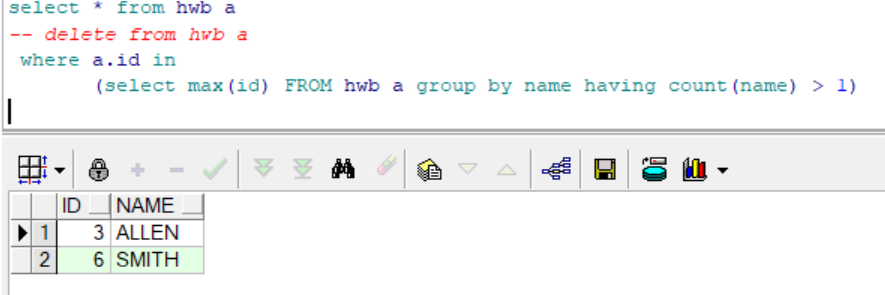
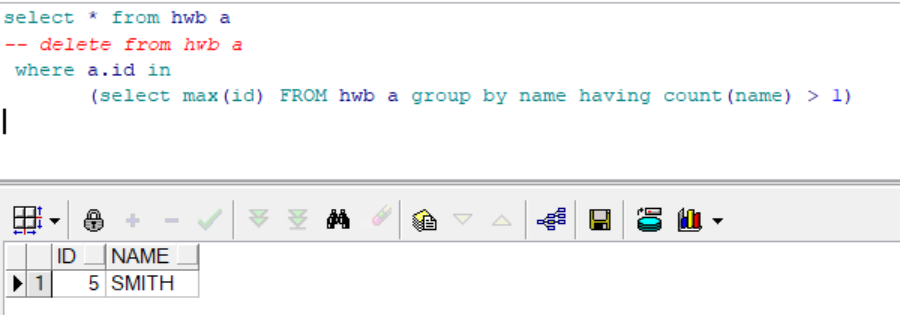
这里得连续删2次
delete from hwb a
 where a.id  in
       (select min(id) FROM hwb a group by name having count(name) > 1)
3、实现方法二:通过name相同,id不同的方式来判断
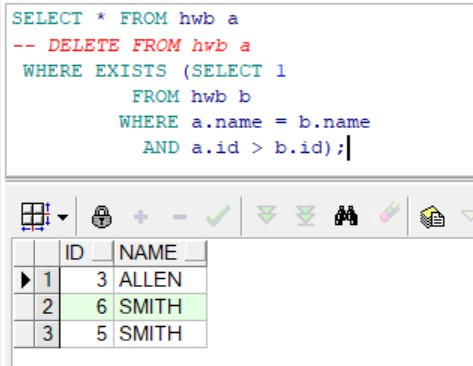
DELETE FROM hwb a
 WHERE EXISTS (SELECT 1
          FROM hwb b
         WHERE a.name = b.name
           AND a.id > b.id);
4、实现方法三:用rowid代替id,替换删除
DELETE FROM hwb a
 WHERE EXISTS (SELECT 1
          FROM hwb b
         WHERE a.name = b.name
           AND a.rowid > b.rowid);
5、实现方法四:通过分析函数根据name分组生成序号,然后删除序号大于1的数据。
语法格式:row_number() over(partition by 分组列 order by 排序列 desc)
在使用 row_number() over()函数时候,over()里头的分组以及排序的执行晚于 where 、group by、 order by 的执行
DELETE FROM hwb a
WHERE ROWID IN (SELECT rid
                   FROM (SELECT ROWID as rid,
                                ROW_NUMBER() OVER(PARTITION BY name ORDER BY id) AS seq
                           FROM hwb)
                  WHERE seq > 1);
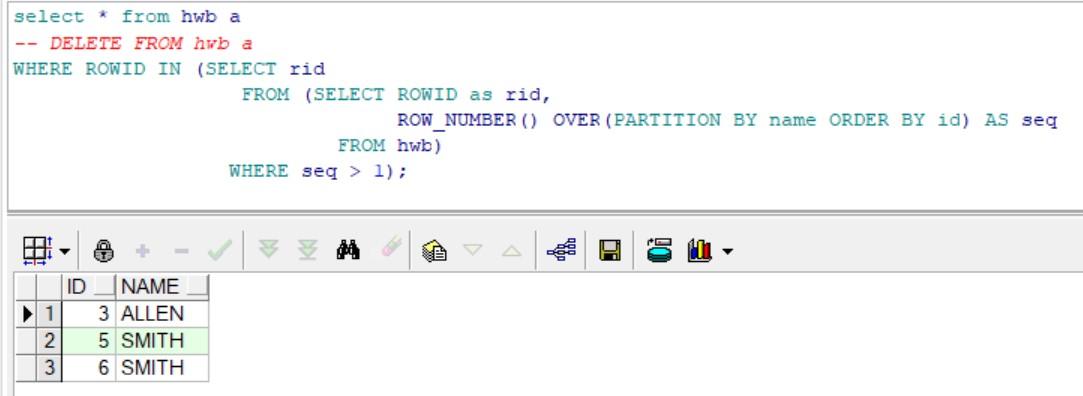
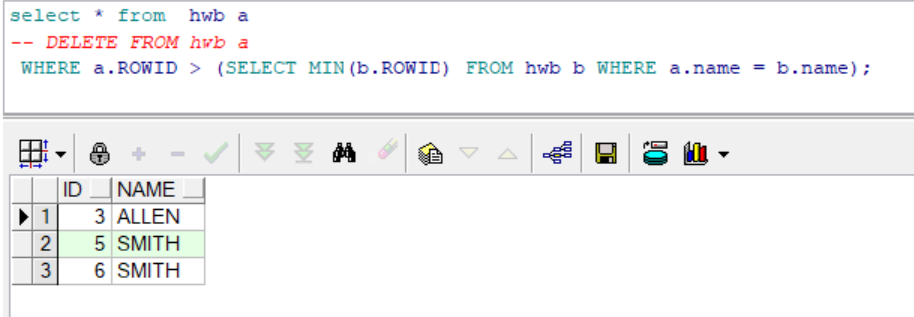
6、【推荐】实现方法五:根据rowid删除
DELETE FROM hwb a
 WHERE a.ROWID > (SELECT MIN(b.ROWID) FROM hwb b WHERE a.name = b.name);
二、MySQL数据库去重
1、环境准备
CREATE TABLE hwb(
    id BIGINT (4) not null,
    name varchar(10),
    PRIMARY KEY (id)
) ENGINE = INNODB;

INSERT INTO hwb VALUES(1, 'TOM');
INSERT INTO hwb VALUES(2, 'ALLEN');
INSERT INTO hwb VALUES(3, 'ALLEN');
INSERT INTO hwb VALUES(4, 'SMITH');
INSERT INTO hwb VALUES(5, 'SMITH');
INSERT INTO hwb VALUES(6, 'SMITH');
commit;
SELECT * FROM hwb;
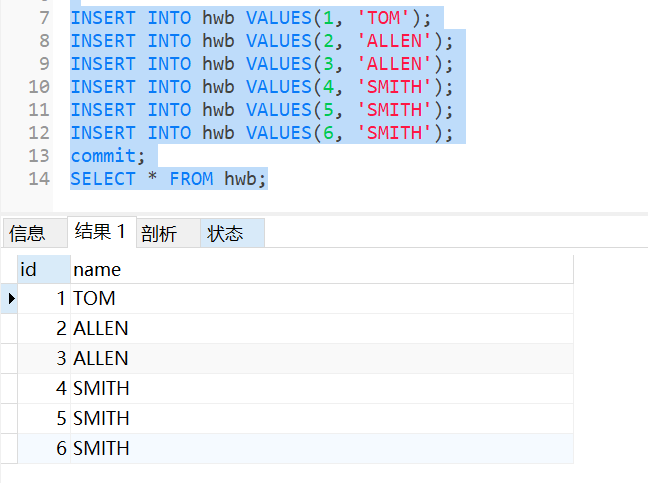
2、实现方法一:通过分组后,拿最大/最小的id重复删除
需删除两次
--重复删除多次
delete from hwb
where id in (select id from
       (select max(b.id) as id FROM hwb b group by name having count(name) > 1)c )

--或者修改为以下,只需删除一次
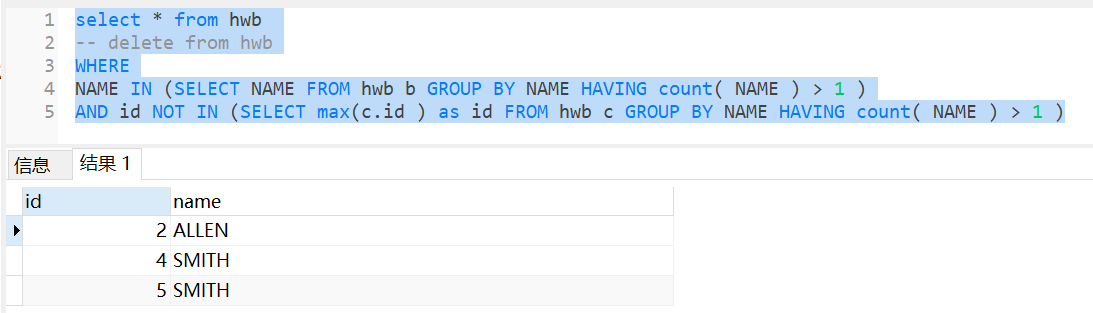
delete from hwb
WHERE
NAME IN (select name from ( SELECT NAME FROM hwb b GROUP BY NAME HAVING count( NAME ) > 1 ) t)
AND id NOT IN (select tt.id from (SELECT max(c.id ) as id FROM hwb c GROUP BY NAME HAVING count( NAME ) > 1 ) tt)
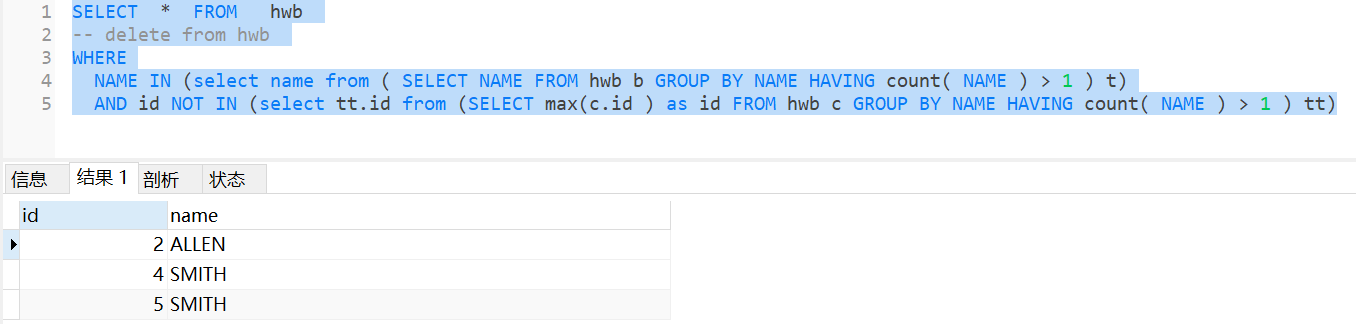
3、实现方法二:通过name相同,id不同方式
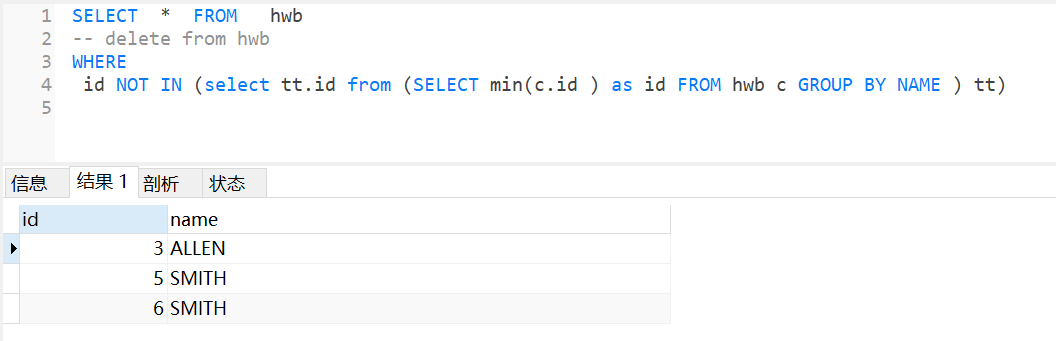
根据name分组,查找出id最小的,然后再查找id不包含刚才查出来的。这样就查询出了所有的重复数据(除了id最小的那行)
delete from hwb
WHERE
 id NOT IN (select tt.id from (SELECT min(c.id ) as id FROM hwb c GROUP BY NAME ) tt)
4、实现方法三:通过name相同,id不同的方式来判断
delete  from hwb  where  id in (
select id from (
select * from hwb a
WHERE EXISTS (SELECT 1
          FROM hwb b
         WHERE a.name = b.name
           AND a.id > b.id))c );

5、实现方法四:用rowid代替id,替换删除
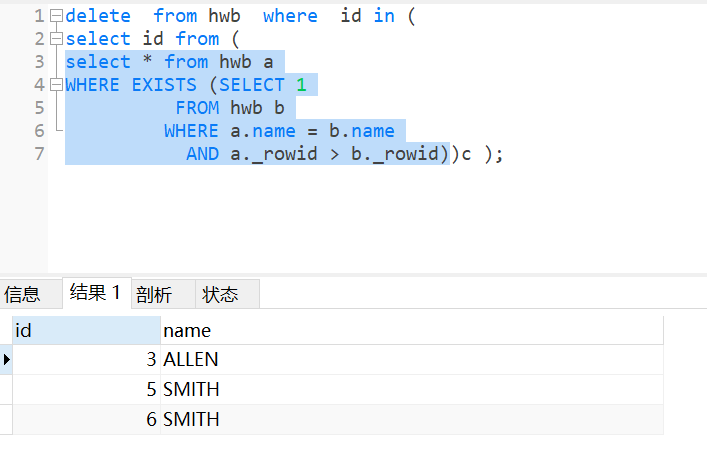
在 Oracle 数据库的表中的每一行数据都有一个唯一的标识符,称为 rowid ,在 Oracle 内部通常就是使用它来访问数据的。
而在 MySQL 中也有一个类似的隐藏列 _rowid 来标记唯一的标识。但是需要注意 _rowid 并不是一个真实存在的列,其本质是一个 非空唯一列 的别名。
在某些情况下 _rowid 是不存在的,其只存在于以下情况:
1)当表中存在一个 数字类型 的单列主键时, _rowid 其实就是指的是这个主键列
2)当表中 不存在主键 但存在一个 数字类型 的 非空唯一列 时, _rowid 其实就是指的是对应 非空唯一列 。
需要注意以下情况是不存在 _rowid 的
1)主键列 或者 非空唯一列 的类型不是 数字类型
2)主键 是联合主键
3)唯一 列不是非空的。
delete  from hwb  where  id in (
select id from (
select * from hwb a
WHERE EXISTS (SELECT 1
          FROM hwb b
         WHERE a.name = b.name
           AND a._rowid > b._rowid))c );
ps:可考虑表切换完成去重步骤
三、sqlserver数据库去重
1、环境准备
CREATE TABLE [dbo].[hwb] (
  [id] decimal(12)   NULL,
  [name] nvarchar(10) COLLATE Chinese_PRC_CI_AS  NOT NULL
)
GO

ALTER TABLE [dbo].[hwb] SET (LOCK_ESCALATION = TABLE)
GO

INSERT INTO hwb VALUES(1, 'TOM');
INSERT INTO hwb VALUES(2, 'ALLEN');
INSERT INTO hwb VALUES(3, 'ALLEN');
INSERT INTO hwb VALUES(4, 'SMITH');
INSERT INTO hwb VALUES(5, 'SMITH');
INSERT INTO hwb VALUES(6, 'SMITH');
GO
2、实现方法一:通过分组后,拿最大/最小的id重复删除
需删除两次
--重复删除多次
delete from hwb
 where id  in
       (select min(id) FROM hwb a group by name having count(name) > 1)

--或者修改为以下,只需删除一次
select * from hwb
-- delete from hwb
WHERE
NAME IN (SELECT NAME FROM hwb b GROUP BY NAME HAVING count( NAME ) > 1 )
AND id NOT IN (SELECT max(c.id ) as id FROM hwb c GROUP BY NAME HAVING count( NAME ) > 1 )
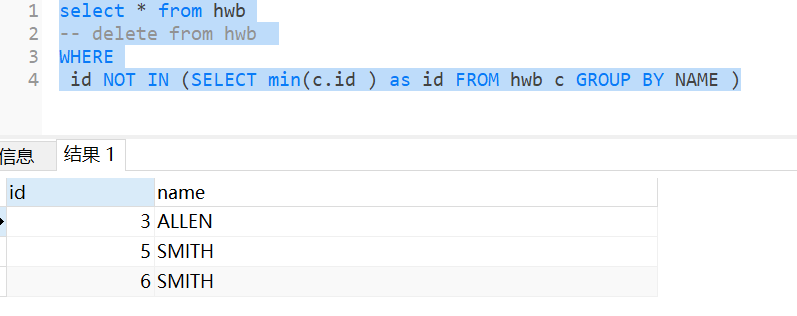
3、实现方法二:根据name分组,查找出id最小的,然后再查找id不包含刚才查出来的
这样就查询出了所有的重复数据(除了id最小的那行)
delete from hwb
WHERE
 id NOT IN (select tt.id from (SELECT min(c.id ) as id FROM hwb c GROUP BY NAME ) tt)
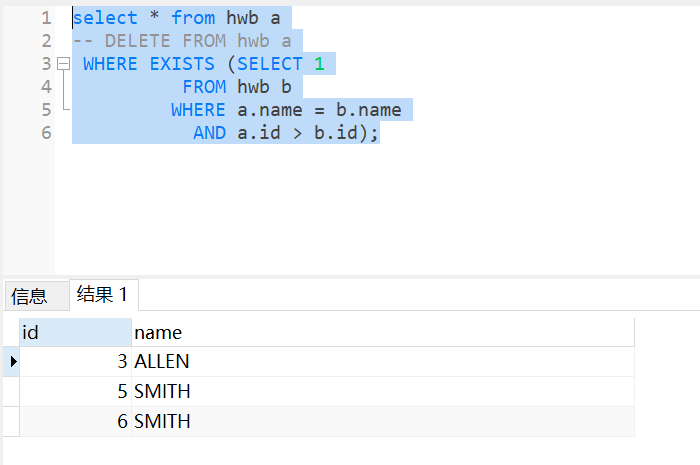
4、实现方法三:通过name相同,id不同的方式来判断
DELETE FROM hwb a
 WHERE EXISTS (SELECT 1
          FROM hwb b
         WHERE a.name = b.name
           AND a.id > b.id);
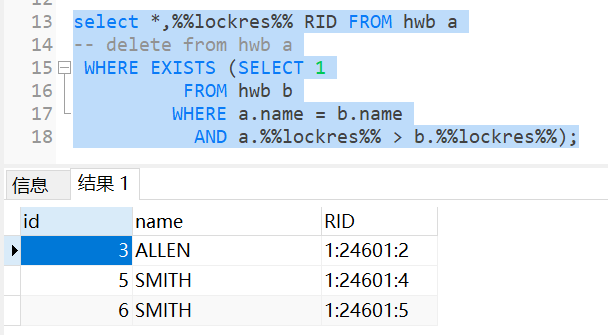
5、实现方法四:用hash值代替id,替换删除
%%lockres%%会返回聚集索引键的hash值,
非聚集索引,%%lockres%%会返回非聚集索引键的hash值。
select *,%%lockres%% RID FROM hwb a
-- delete from hwb a
 WHERE EXISTS (SELECT 1
          FROM hwb b
         WHERE a.name = b.name
           AND a.%%lockres%% > b.%%lockres%%);
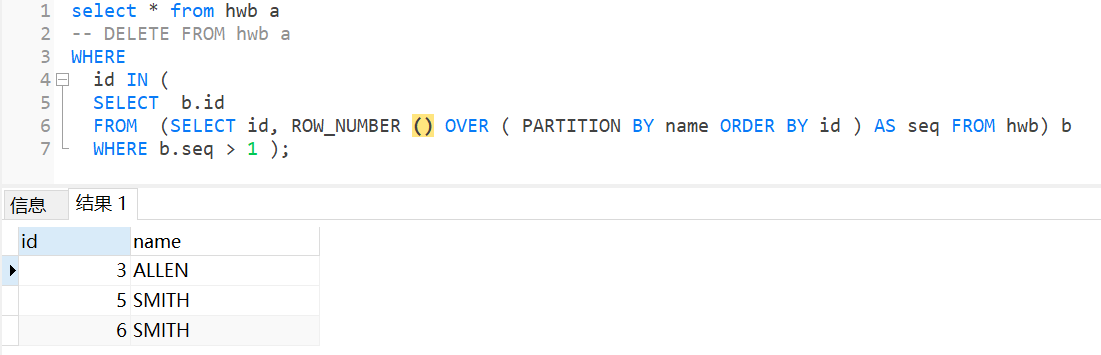
6、实现方法五:通过分析函数根据name分组生成序号,然后删除序号大于1的数据。
语法格式:row_number() over(partition by 分组列 order by 排序列 desc)
在使用 row_number() over()函数时候,over()里头的分组以及排序的执行晚于 where 、group by、 order by 的执行
DELETE FROM hwb a
WHERE
	id IN (
	SELECT	b.id
	FROM	(SELECT id, ROW_NUMBER () OVER ( PARTITION BY name ORDER BY id ) AS seq FROM hwb) b
	WHERE	b.seq > 1 );
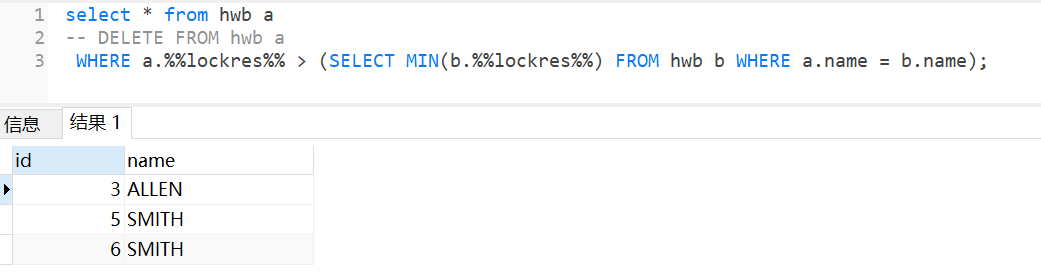
7、【推荐】实现方法六:根据hash值删除
DELETE FROM hwb a
 WHERE a.%%lockres%% > (SELECT MIN(b.%%lockres%%) FROM hwb b WHERE a.name = b.name);
四、pg数据库删除重复数据
1、环境准备
$ psql
\l  --list database
\c database_name
\dn   --list schemas
set search_path to 'public';
\dt   --list tables
CREATE TABLE hwb(
    id INT PRIMARY KEY  NOT NULL,
    name CHAR(10));

INSERT INTO hwb VALUES(1, 'TOM');
INSERT INTO hwb VALUES(2, 'ALLEN');
INSERT INTO hwb VALUES(3, 'ALLEN');
INSERT INTO hwb VALUES(4, 'SMITH');
INSERT INTO hwb VALUES(5, 'SMITH');
INSERT INTO hwb VALUES(6, 'SMITH');
SELECT * FROM hwb;
2、实现方法一:通过分组后,拿最大/最小的id重复删除
需删除两次
--重复删除多次
delete from hwb
where id in (select max(b.id) as id FROM hwb b group by name having count(name) > 1)

--或者修改为以下,只需删除一次
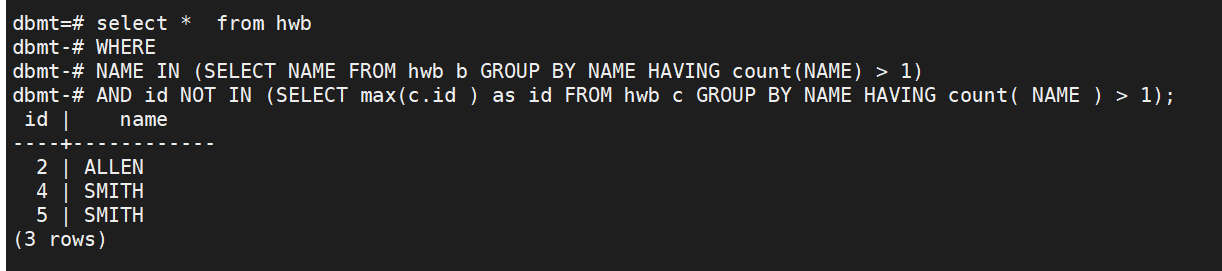
delete  from hwb
WHERE
NAME IN (SELECT NAME FROM hwb b GROUP BY NAME HAVING count(NAME) > 1)
AND id NOT IN (SELECT max(c.id ) as id FROM hwb c GROUP BY NAME HAVING count( NAME ) > 1);
3、实现方法二:通过name相同,id不同方式
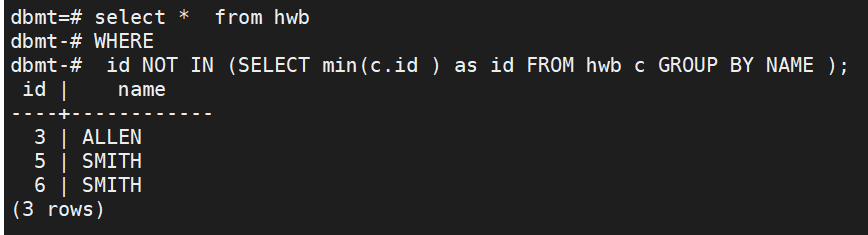
根据name分组,查找出id最小的,然后再查找id不包含刚才查出来的。这样就查询出了所有的重复数据(除了id最小的那行)
delete  from hwb
WHERE id NOT IN (SELECT min(c.id ) as id FROM hwb c GROUP BY NAME );
4、实现方法三:通过name相同,id不同的方式来判断
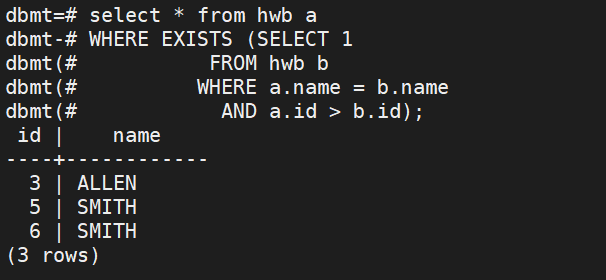
delete from hwb a
WHERE EXISTS (SELECT 1
          FROM hwb b
         WHERE a.name = b.name
           AND a.id > b.id);
5、[推荐]实现方法四:用ctid代替id,替换删除
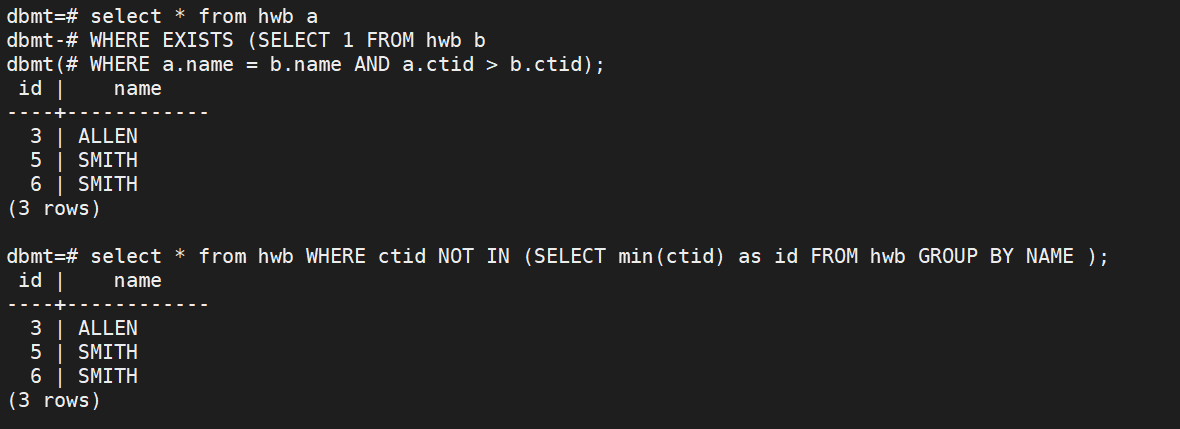
delete from hwb a
WHERE EXISTS (SELECT 1 FROM hwb b
WHERE a.name = b.name AND a.ctid > b.ctid);

--或者如下:
select * from hwb WHERE ctid NOT IN (SELECT min(ctid) as id FROM hwb GROUP BY NAME );
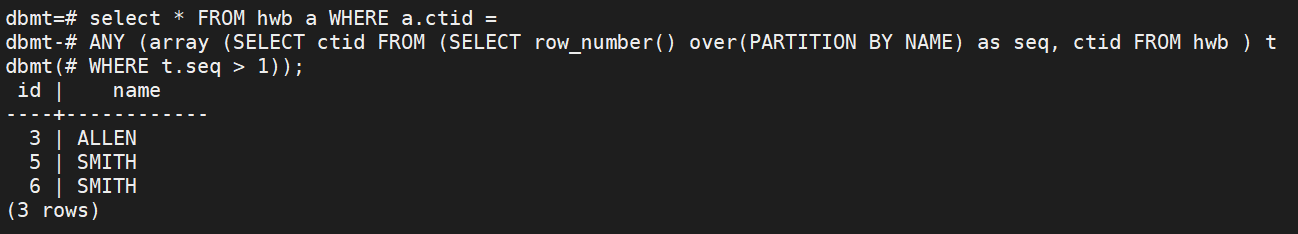
6、[最高效推荐]实现方法五:用ctid代替id,结合row_number替换删除
delete FROM hwb a WHERE a.ctid =
ANY (array (SELECT ctid FROM (SELECT row_number() over(PARTITION BY NAME) as seq, ctid FROM hwb ) t
WHERE t.seq > 1));
发布者:全栈程序员-站长,转载请注明出处:https://javaforall.net/187235.html原文链接:https://javaforall.net



