
1. 准备
LMDB和SQLite/MySQL等关系型数据库不同,属于key-value数据库(把LMDB想成dict会比较容易理解),键key与值value都是字符串。
安装:
pip install lmdb使用时import lmdb。
2. 操作流程
概况地讲,操作LMDB的流程是:
- 通过env = lmdb.open()打开环境
- 通过txn = env.begin()建立事务
- 通过txn.put(key, value)进行插入和修改
- 通过txn.delete(key)进行删除
- 通过txn.get(key)进行查询
- 通过txn.cursor()进行遍历
- 通过txn.commit()提交更改
3. 操作实例
3.1 建立环境
#!/usr/bin/env python

import lmdb

env = lmdb.open("students");
运行一下,查看当前目录的变化:

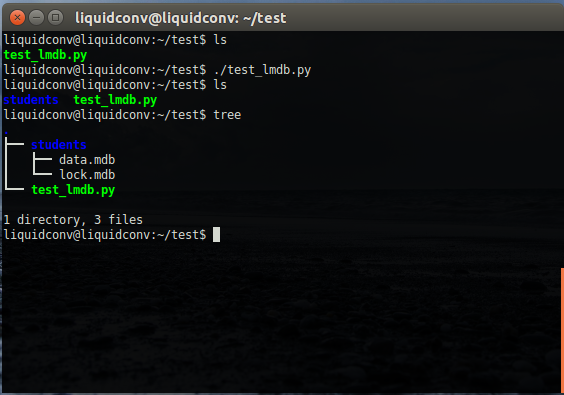
可以看到当前目录下多了students目录,里面有data.mdb和lock.mdb两个文件。
3.2 插入、删除、修改
插入与修改都用put实现,删除用delete实现。
#!/usr/bin/env python

import lmdb

env = lmdb.open("students");
txn = env.begin(write=True);

txn.put(str(1), "Alice");
txn.put(str(2), "Bob");
txn.put(str(3), "Peter");

txn.delete(str(1));

txn.put(str(3), "Mark");

txn.commit();
注意用txn = env.begin()创建事务时,只有write=True才能够写数据库。
3.3 查询
查单条记录用get(key),遍历数据库用cursor。
#!/usr/bin/env python

import lmdb

env = lmdb.open("students");
# txn = env.begin(write=True);
txn = env.begin();
print txn.get(str(2));

for key, value in txn.cursor():
    print (key, value);

env.close();
运行一下,输出结果为:

3.4 完整的例子
#!/usr/bin/env python

import lmdb
import os, sys

def initialize():
    env = lmdb.open("students");
    return env;

def insert(env, sid, name):
    txn = env.begin(write = True);
    txn.put(str(sid), name);
    txn.commit();

def delete(env, sid):
    txn = env.begin(write = True);
    txn.delete(str(sid));
    txn.commit();

def update(env, sid, name):
    txn = env.begin(write = True);
    txn.put(str(sid), name);
    txn.commit();

def search(env, sid):
    txn = env.begin();
    name = txn.get(str(sid));
    return name;

def display(env):
    txn = env.begin();
    cur = txn.cursor();
    for key, value in cur:
        print (key, value);

env = initialize();

print "Insert 3 records."
insert(env, 1, "Alice");
insert(env, 2, "Bob");
insert(env, 3, "Peter");
display(env);

print "Delete the record where sid = 1."
delete(env, 1);
display(env);

print "Update the record where sid = 3."
update(env, 3, "Mark");
display(env);

print "Get the name of student whose sid = 3."
name = search(env, 3);
print name;

env.close();

os.system("rm -r students");
运行一下,输出结果为:

转载自:
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容, 请发送邮件至 举报,一经查实,本站将立刻删除。
发布者:全栈程序员-站长,转载请注明出处:https://javaforall.net/187835.html原文链接:https://javaforall.net



