模仿学习(Imitation Learning)入门

模仿学习(Imitation Learning)入门在游戏中,我们往往有一个计分板准确定义事情的好坏程度。但现实中,定义Reward有可能是非常困难的,并且人定的reward也有可能存在许多意想不到的缺陷。在没有reward的情况下,让AI跟环境互动的一个方法叫做Imitation-Learning。在没有reward的前提下,我们可以找人类进行示范,AI可以凭借这些示范以及跟环境的互动进行学习。这种模仿学习使得智能体自身不必从零学起,不必去尝试探索和收集众多的无用数据,能大大加快训练进程。这跟supervised-learning有类似之处,如果采用这种


Jetbrains全系列IDE使用 1年只要46元 售后保障 童叟无欺

在游戏中,我们往往有一个计分板准确定义事情的好坏程度。但现实中,定义Reward有可能是非常困难的,并且人定的reward也有可能存在许多意想不到的缺陷。在没有reward的情况下,让AI跟环境互动的一个方法叫做Imitation-Learning。在没有reward的前提下,我们可以找人类进行示范,AI可以凭借这些示范以及跟环境的互动进行学习。这种模仿学习使得智能体自身不必从零学起,不必去尝试探索和收集众多的无用数据,能大大加快训练进程。

这跟supervised-learning有类似之处,如果采用这种做法,我们叫做Behavior-Cloning,也就是复制人类的行为。

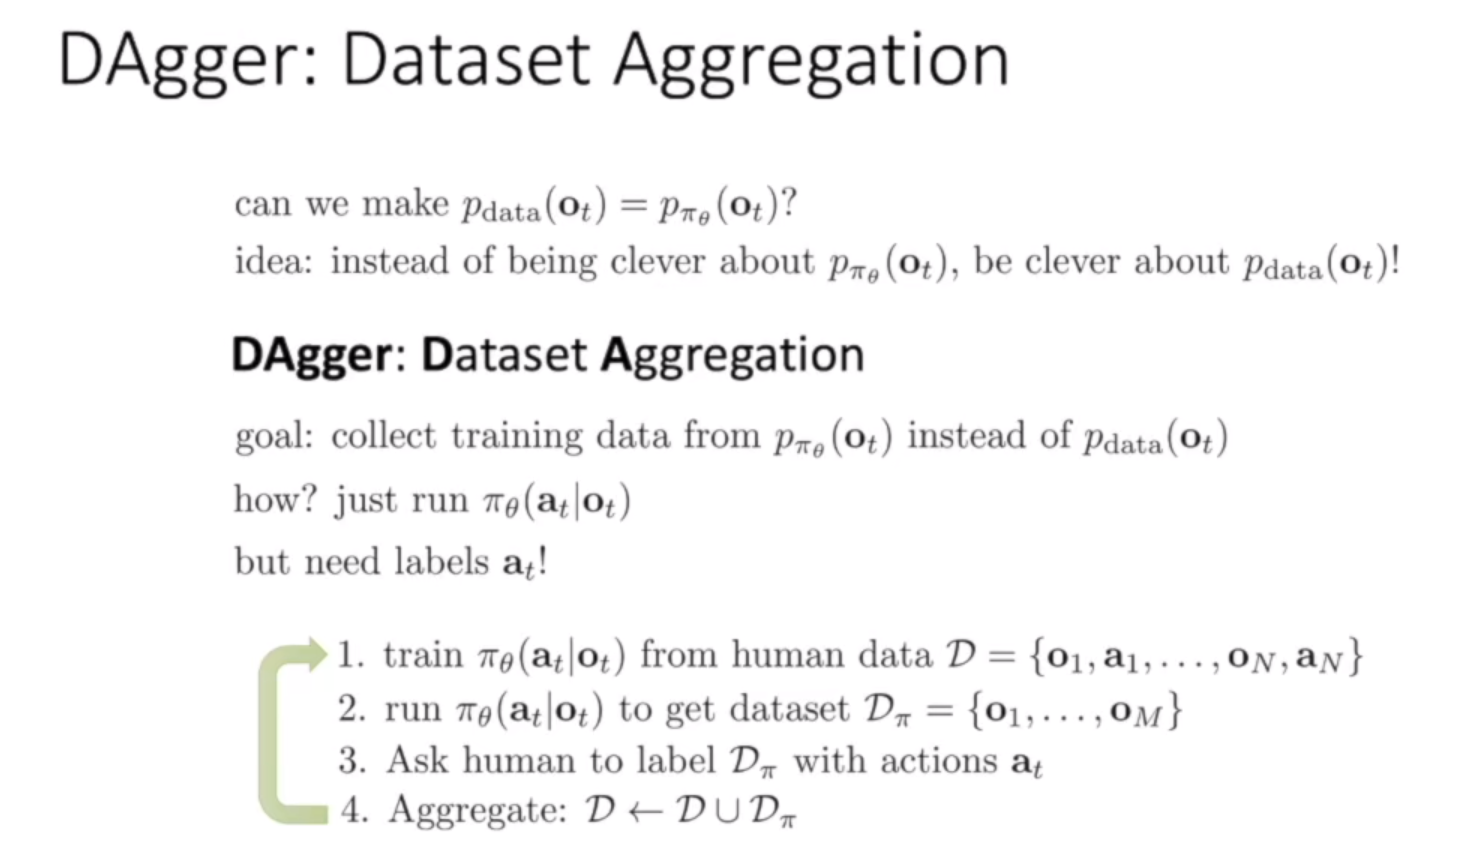
但是这种监督学习有一个缺点,如果是智能体进入到一个以前从来没有见到过的状态,就会产生较大的误差,这种误差会一直累加,到最后没有办法进行正常的行为。因此我们需要让实际遇到的数据和训练数据的分布尽量保持一致。

DAgger

前期先让人类去操作policy,拿到足够多的数据以后做完全意义上的offline训练;如果offline训出来效果不好,把效果不好的场景再让人类操作一遍,对各个状态打上动作标签。然后新数据加旧数据一起再训练,直到效果变好为止,这就是DAgger。

在这里插入图片描述

通常第三步人来收集数据也是一个比较麻烦和漫长的过程,我们也可以使用其他算法来代替人类来打标签。

逆强化学习(Inverse Reinforcement Learning)

在强化学习中,我们给定环境(状态转移)和奖励函数,我们需要通过收集的数据来对自身的策略函数和值函数进行优化。在逆强化学习中,提供环境(状态转移),也提供策略函数或是示教数据,我们希望从这些数据中反推奖励函数。即给定状态和动作,建立模型输出对应奖励。在奖励函数建立好后,我们就能新训练一个智能体来模仿给定策略(示教数据)的行为。

GAIL(Generative Adversarial Imitation Learning)
在这里插入图片描述

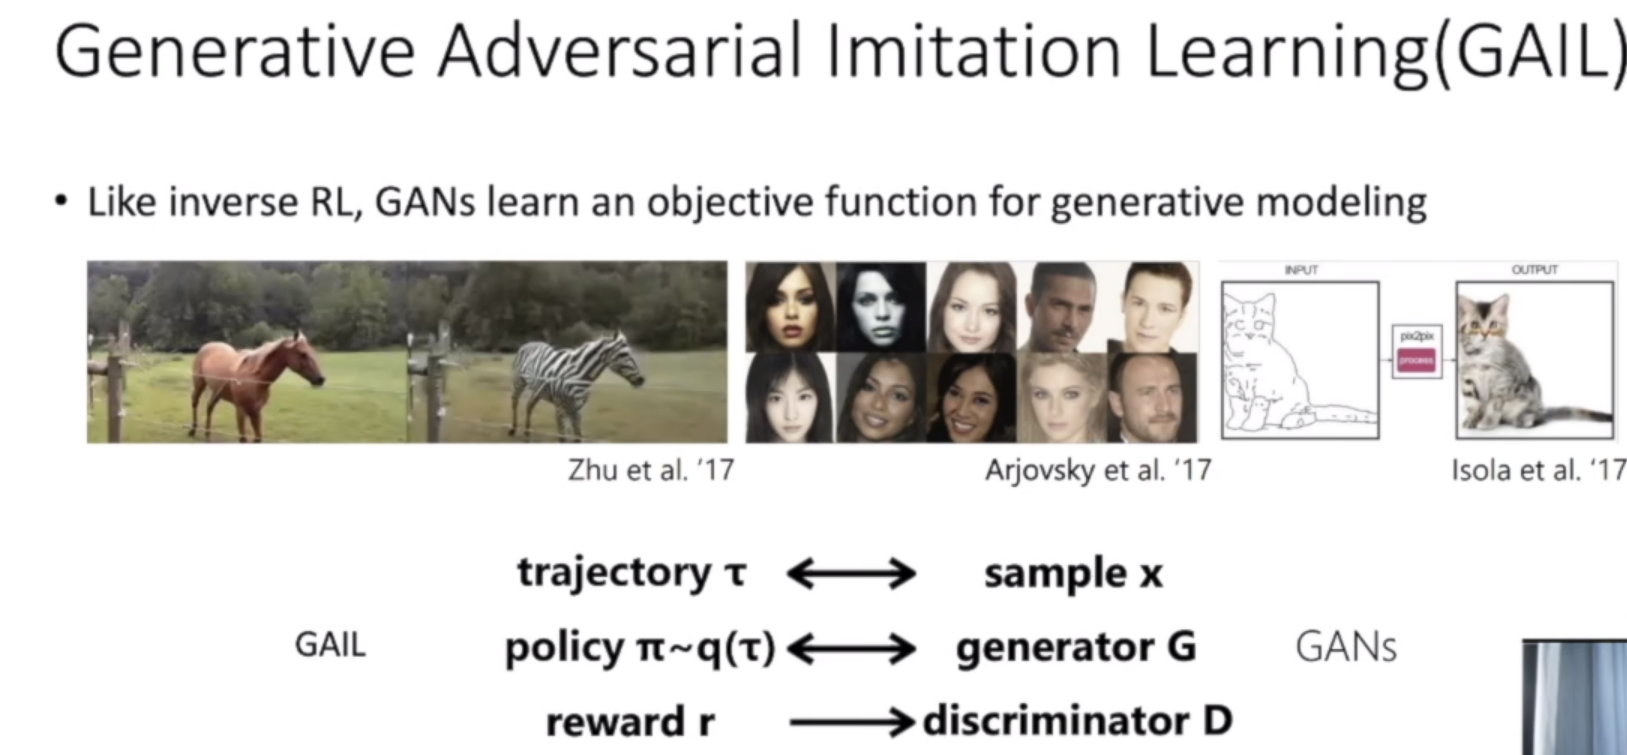
在IRL领域有名的算法是GAIL,这种算法模仿了生成对抗网络GANs。把Actor当成Generator,把Reward Funciton当成Discriminator。
我们要训练一个策略网络去尽量拟合提供的示教数据,那么我们可以让需要训练的reward函数来进行评价,Reward函数通过输出评分来分辨哪个是示教数据的轨迹,哪个是自己生成的虚假轨迹;而策略网络负责生成虚假的轨迹,尽可能骗过Reward函数,让其难辨真假。两者是对抗关系,双方的Loss函数是对立的,两者在相互对抗中一起成长,最后训练出一个较好的reward函数和一个较好的策略网络。

模仿学习结合强化学习

模仿学习的特点:

  1. 用人工收集数据往往需要较大成本,而且数据量也不会很大,并且存在数据分布不一致的问题。
  2. 人也有很多办不到的策略,如果是非常复杂的控制(例如高达机器人,六旋翼飞行器),人是没办法胜任的。
  3. 训练稳定简单。
  4. 最多只能做到和示教数据一样好,无法超越。

强化学习的特点:

  1. 需要奖励函数。
  2. 需要足够的探索。
  3. 有可能存在的不能收敛问题。
  4. 可以做到超越人类的决策。

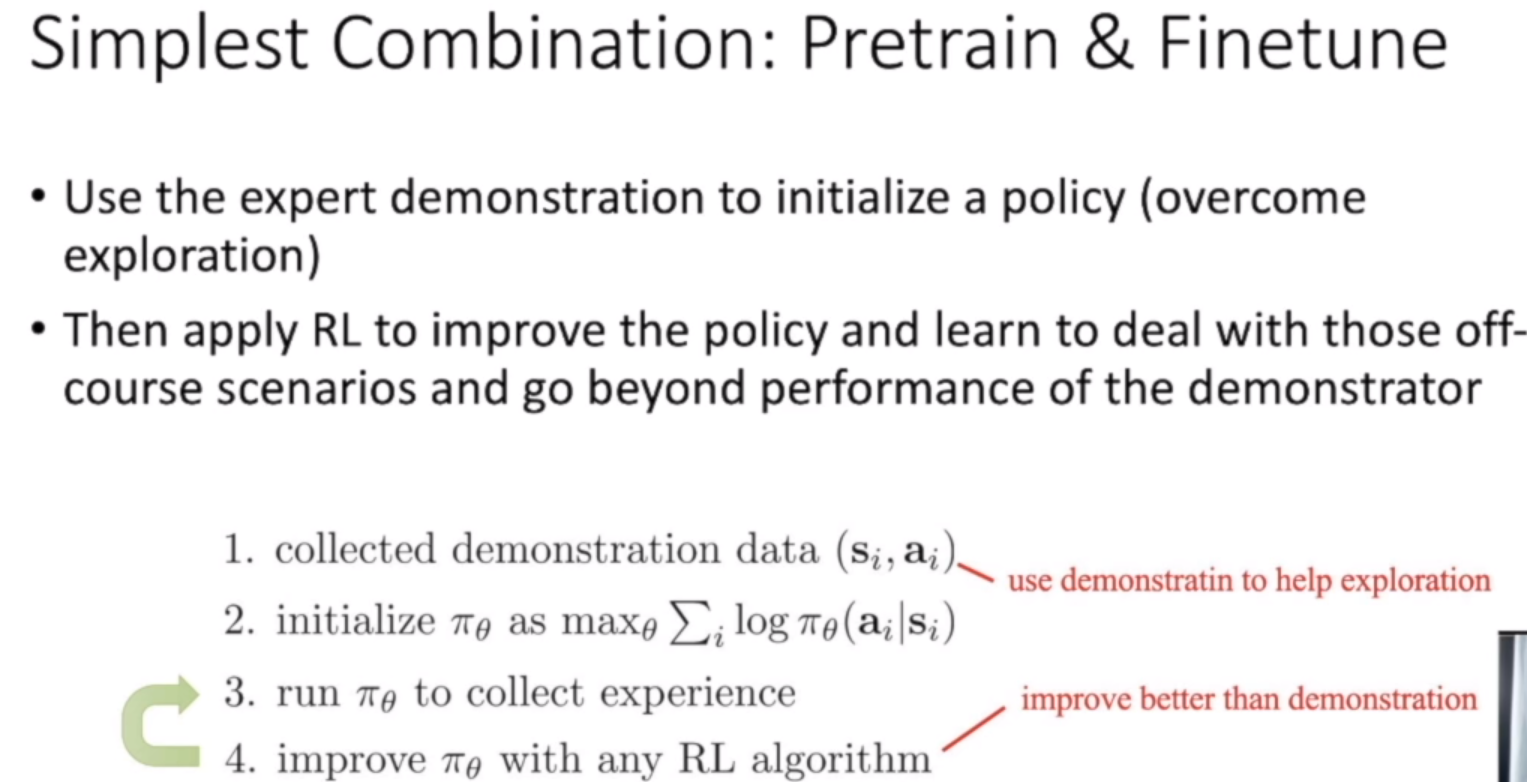
因此我们可以把两者结合起来,既有人类的经验,又有自己的探索和学习。我们的做法是进行预训练和微调。AlphaGo正是运用了这种框架。同样星际争霸2的AlphaStar同样也是这种训练框架,得到了超越人类的水平。
在这里插入图片描述

但在运用pretrain和finetune这种框架时我们通常会面临一个问题,就是在预训练过后进行强化学习的时候,我们的策略一开始采集到的数据很可能是非常糟糕的,这会直接摧毁策略网络,导致效果越来越差,训练没法进行。因此我们需要在策略中将一开始的示教数据保留下来,我们可以把示教的数据直接放入reply buffer中,这样可以让策略网络随时进行学习。


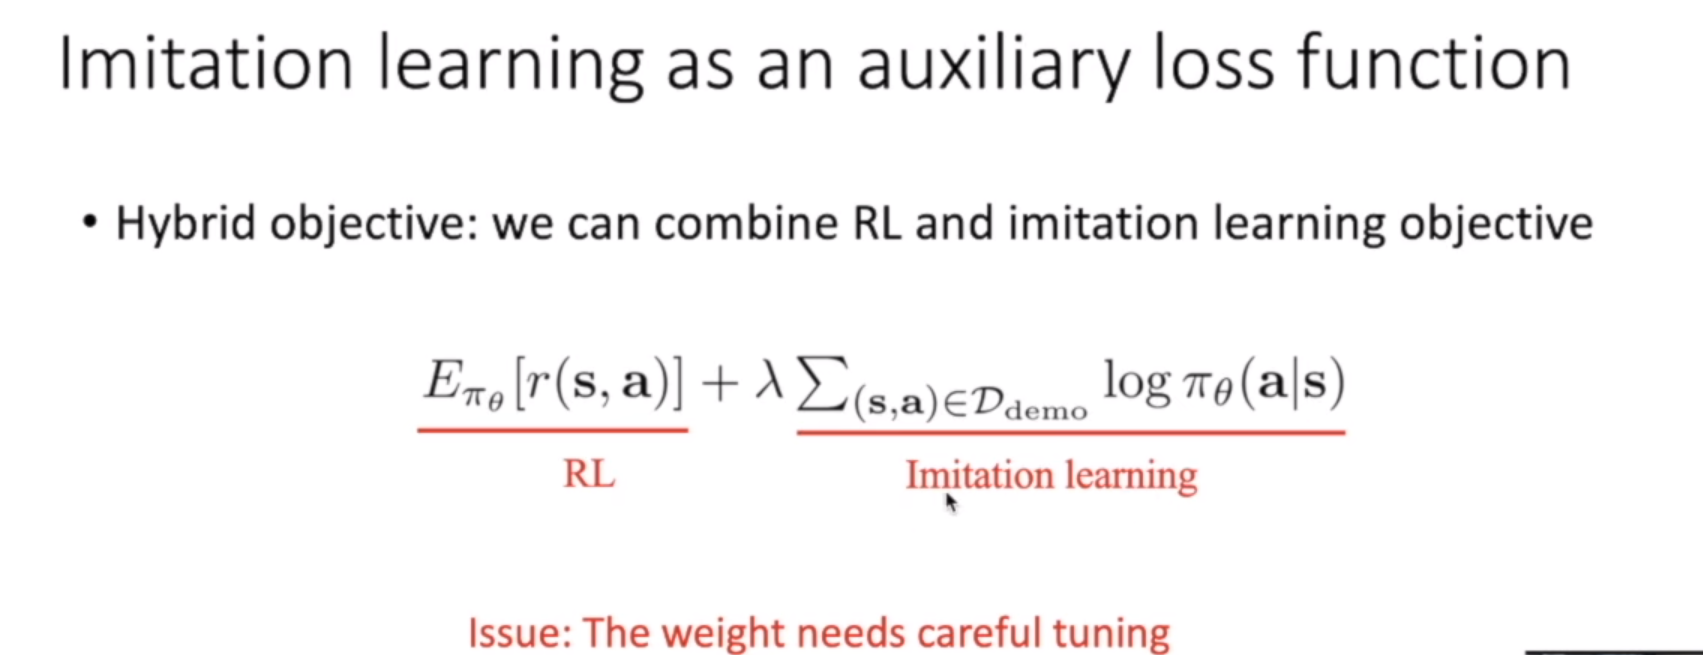
我们可以通过加入一个损失函数同时对loss进行优化:
在这里插入图片描述

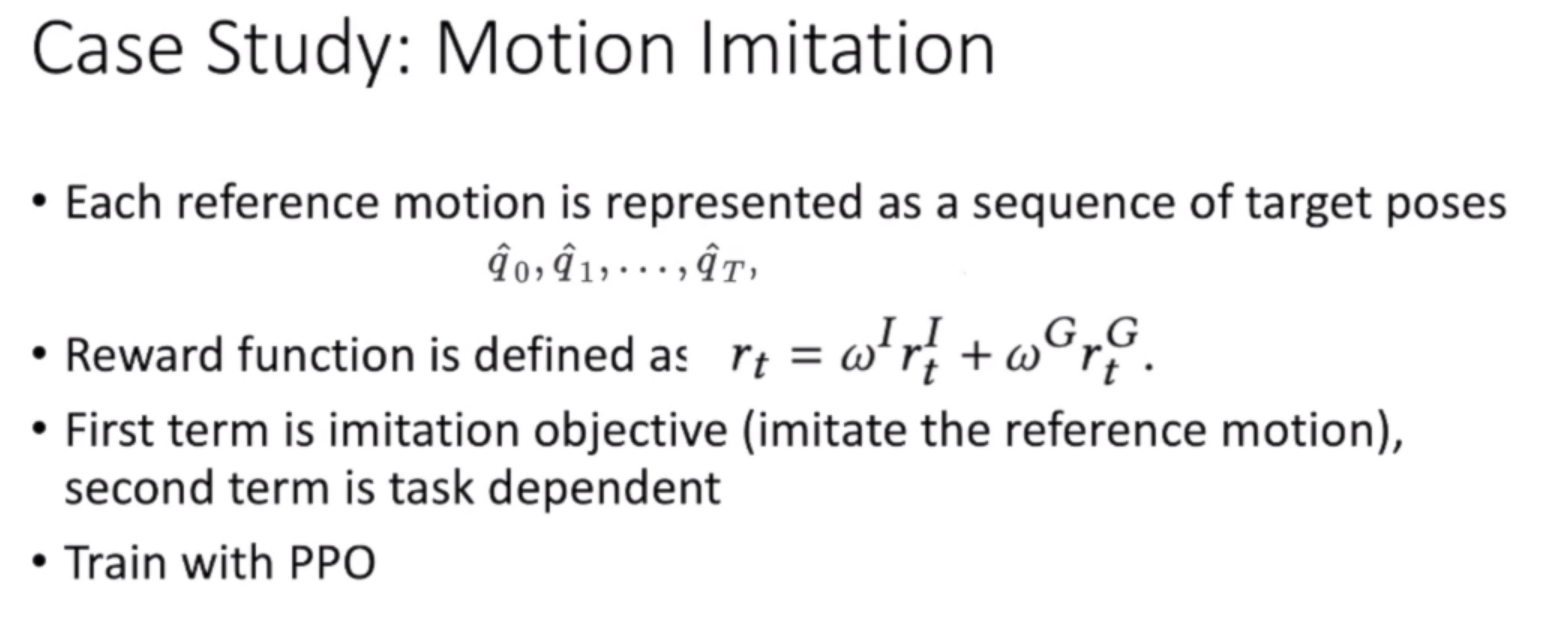
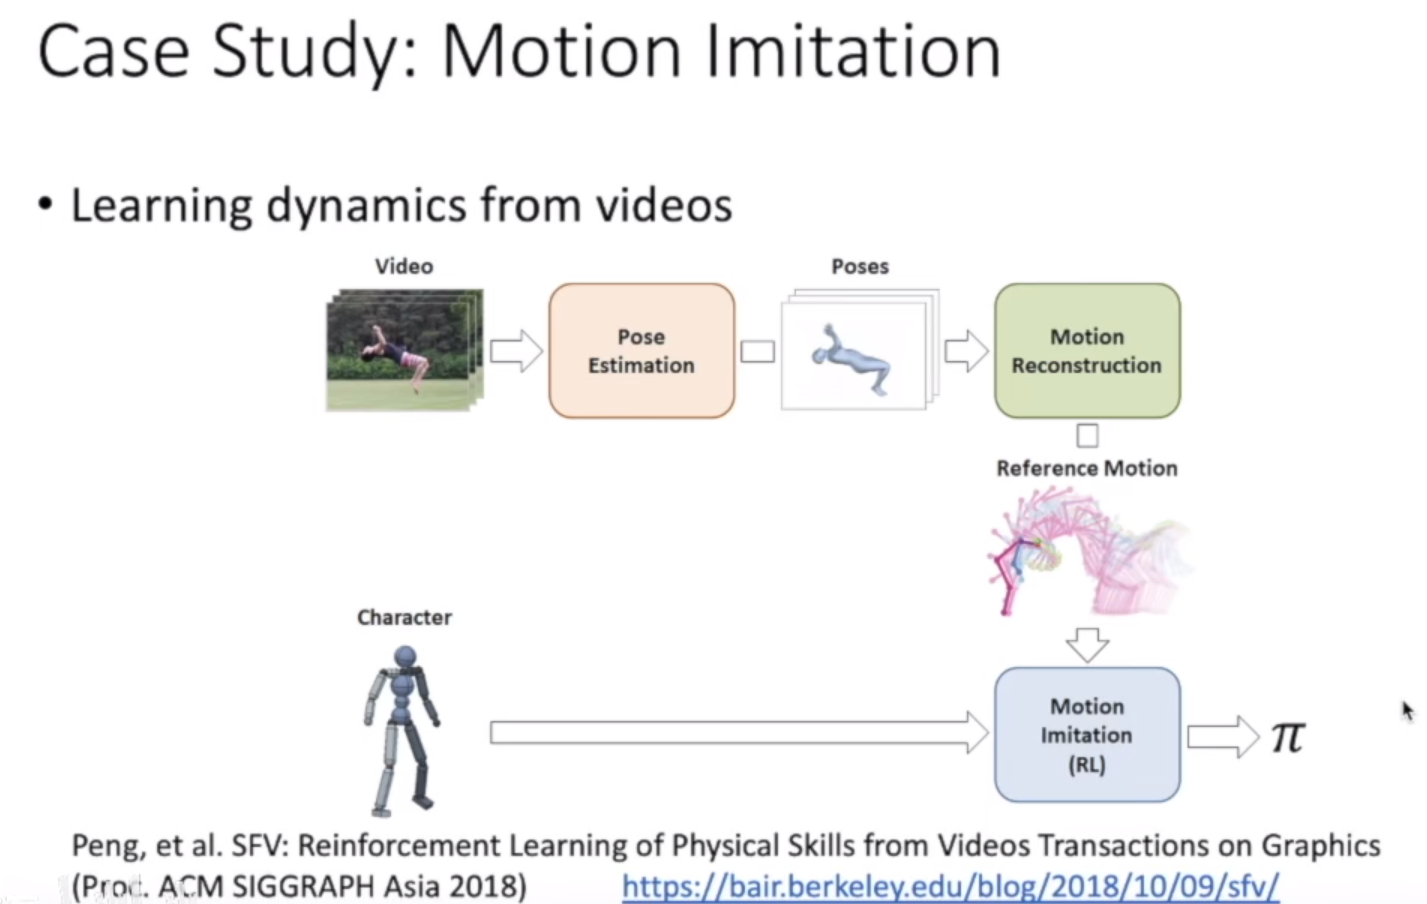
应用

在这里插入图片描述

在这里插入图片描述

结论

在这里插入图片描述

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容, 请发送邮件至 举报,一经查实,本站将立刻删除。

发布者:全栈程序员-站长,转载请注明出处:https://javaforall.net/191864.html原文链接:https://javaforall.net

赞 (0)
全栈程序员-站长的头像全栈程序员-站长

相关推荐

  • 推荐几个IDEA插件,Java开发者撸码利器

    推荐几个IDEA插件,Java开发者撸码利器点击上方“Java之间”,选择“置顶或者星标”你关注的就是我关心的!来源:www.cnblogs.com/jimoer/p/8799437.html#上一篇:Java8很香但还是想升级到…

    2022年8月22日
  • java数组排序去重_JAVA数组去重排序

    java数组排序去重_JAVA数组去重排序今天也是很丧的一天,天气真的好热啊,胃不舒服,一直打嗝,中午吃了一碗凉掉的粥,然后开始拉肚子,一点不想要过来医院学习(基本上都是自己傻坐着,又没有老师来教我们,幽怨.jpg),但不来又过不去自己心里的那道坎,像是逃课的感觉,就很烦,然后在校门口纠结了十分钟还是过来了,emmmmm……然后就有了下面的代码packageArray;publicclassBubbleSort{publi…

    2022年6月29日
  • 什么是按位或,什么是按位异或,什么是按位与?「建议收藏」

    什么是按位或,什么是按位异或,什么是按位与?「建议收藏」&按位与|按位或^按位异或1.按位与运算按位与运算符"&"是双目运算符。其功能是参与运算的两数各对应的二进位相与。只有对应的两个二进位均为1时,结果位才为1,否则为0。参与运算的数以补码方式出现。例如:9&5可写算式如下:00001001(9的二进制补码)&00000101(5的二进制补码)00000001(1的二进制补码)可见9&am…

    2022年6月3日
  • Platform SDK工具集

    Platform SDK工具集PlatformSDK工作集,PlatformSDK目录下包含很多工具。这些工具在调试、测试、性能测试、可执行文件查看等方面有比较强的功能。depends.exe:系统调用依赖查看工具,可以用来查看可执行文件的导入表和导出表。WinDbg:功能强大的调试器。rc.exe:资源编译器。mc.exe:消息编译器。bind.exe:绑定DLL,将DLL导出的函数的地址存储到地址表

    2022年5月4日
  • 目录层次结构_文件夹构成什么结构

    目录层次结构_文件夹构成什么结构:数码相机/摄像机/图形冲印–:普通数码相机–:专业数码单反–:数码摄像机–:单反镜头–:相机闪光灯及附件–:胶卷相机—-:收藏相机—-:135胶片单反—-:旁轴相机—-:大中幅相机—-:LOMO—-:傻瓜相机—-:一次成像(拍立得)—-:一次性相机—-:特殊相机–:三脚架/云台-…

    2022年10月8日
  • labelme教程_label shop

    labelme教程_label shopdelete删除标签时,不再弹出对话框找到./python/site-packages/labelme/app.pydefdeleteSelectedShape(self):self.remLabels(self.canvas.deleteSelected())self.setDirty()ifself.noShapes():foractioninself.actions.onShapesPresent:..

    2022年9月3日

发表回复

您的邮箱地址不会被公开。 必填项已用 * 标注

关注全栈程序员社区公众号