深度强化学习之模仿学习(Imitation Learning)

深度强化学习之模仿学习(Imitation Learning)  上一部分研究的是奖励稀疏的情况,本节的问题在于如果连奖励都没有应该怎么办,没有奖励的原因是,一方面在某些任务中很难定量的评价动作的好坏,如自动驾驶,撞死人和撞死动物的奖励肯定不同,但分别为多少却并不清楚,另一方面,手动设置的奖励可能导致不可控的行为。要解决此类问题,可以将人类专家的范例作为强化学习代理的参考去学习,因此模仿学习又叫演示学习(Learningbydemonstration)…

大家好,又见面了,我是你们的朋友全栈君。如果您正在找激活码,请点击查看最新教程,关注关注公众号 “全栈程序员社区” 获取激活教程,可能之前旧版本教程已经失效.最新Idea2022.1教程亲测有效,一键激活。

Jetbrains全系列IDE使用 1年只要46元 售后保障 童叟无欺
在这里插入图片描述
  上一部分研究的是奖励稀疏的情况,本节的问题在于如果连奖励都没有应该怎么办,没有奖励的原因是,一方面在某些任务中很难定量的评价动作的好坏,如自动驾驶,撞死人和撞死动物的奖励肯定不同,但分别为多少却并不清楚,另一方面,手动设置的奖励可能导致不可控的行为。要解决此类问题,可以将人类专家的范例作为强化学习代理的参考去学习,因此模仿学习又叫演示学习(Learning by demonstration)或学徒学习(Apprenticeship Learning)。下面将介绍两种模仿学习方法:行为克隆和逆向强化学习。
1、行为克隆(Behavior Cloning)
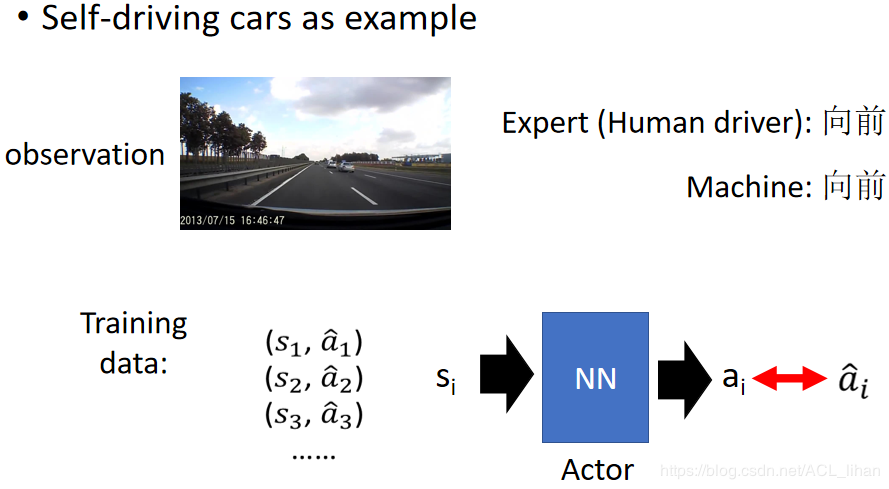
  行为克隆和监督学习的思想如出一辙,人类专家采取什么动作,代理就采取什么动作。以自动驾驶为例,收集很多人类专家的驾驶资料,这些资料的状态s是开车的场景,动作a是在此场景下的动作。把这些资料输入到神经网络中,使网络的输出尽可能地接近人类实际做出的动作,就可以完成任务。
在这里插入图片描述
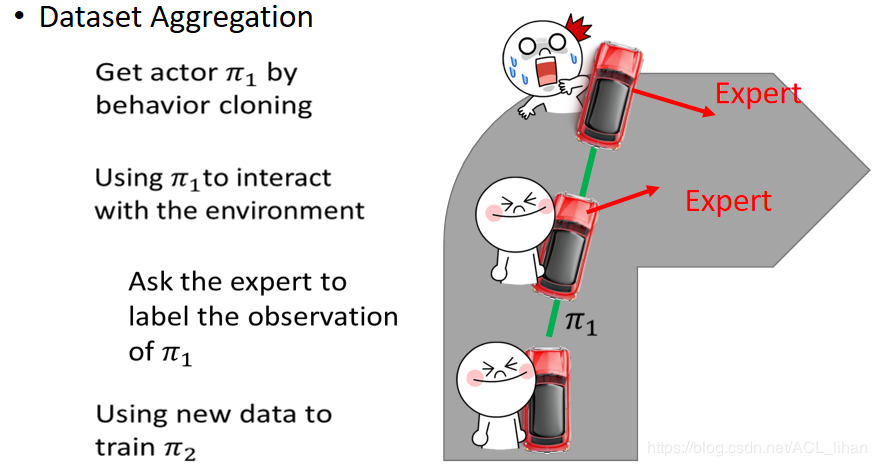
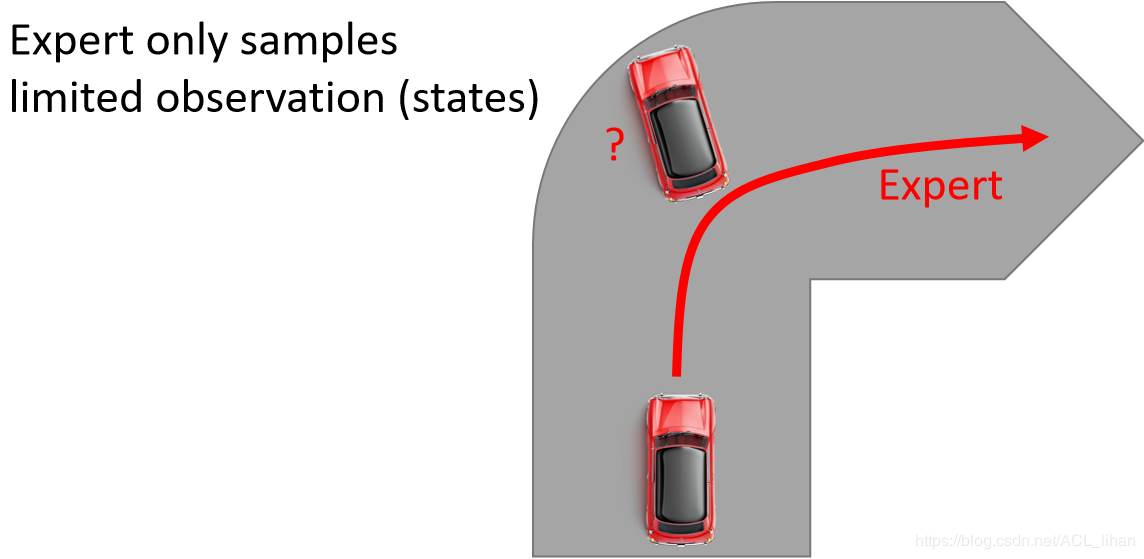
  但是在这个过程中,专家观察到的状态是有限的。比如在实验中,让人去开车就都能顺利转弯,而不会出现撞墙的情况,而这时让代理去开车,如果某一时间它没能和人类专家一样及时转弯导致出现快撞墙的状态,由于人类专家并没有给出这种情况下的处理动作,代理就不知道下一步应该怎么办。一种解决方法就是让代理收集更多的数据——Dataset Aggregation。
在这里插入图片描述
Dataset Aggregation
在这里插入图片描述
  通过Behavior Cloning得到actor Π1,使用Π1与环境进行交互,即开车;让专家坐在车里观察所处的状态并告诉actor做出什么动作;但是actor并不会听取专家的建议,还是以actor的意愿开车,如果最终撞墙一个episode就结束了;这时actor就知道在快要撞墙的时候采取什么动作了,然后用这个新的数据去训练新的策略Π2;重复多次步骤1~4。 以上就是Dataset Aggregation的过程。
  从上面可以看出行为克隆很容易实现,但是也存在问题:

  1. 代理会完全复制专家的行为,不管这个行为对不对,因为没有奖励,代理会将人类专家的行为当成圣旨;
  2. 代理的学习能力有限,代理会选择错误的行为进行复制,那什么该学什么不该学就显得很重要;
  3. 有可能出现mismatch的问题(上面开车的例子)。

  什么是mismatch问题呢?
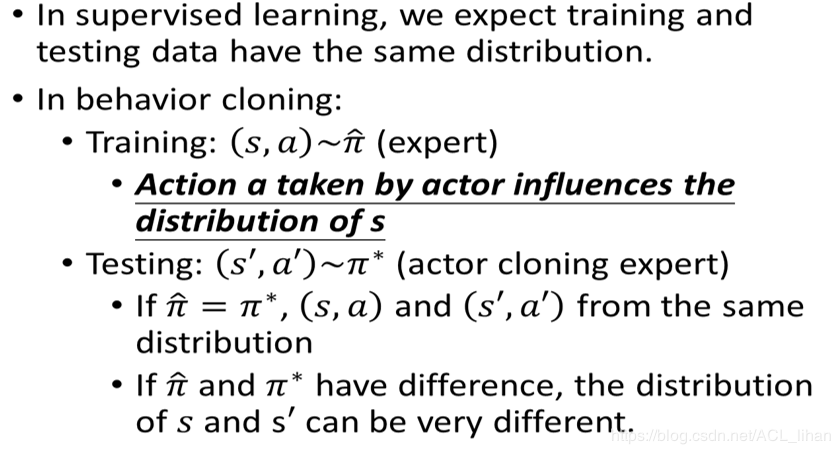
在这里插入图片描述
  在监督学习中,期望训练数据和测试数据具有相同的分布,而在行为克隆中,代理做出的动作是会影响后续状态的。因为神经网络的训练存在误差,训练出来的actor Π*与人类专家Π不可能完全一模一样,就会导致某个状态下,两者采取的动作不一样,自然而然就会导致后面的状态完全不同,最坏的情况就是actor遇到了专家从未遇到过的状态,这时actor就完全懵逼了,即失之毫厘,差之千里。
  所以,虽然行为克隆简单但是并不是一种很好的方法,所以就出现了第二种方法:逆向强化学习。
2、逆向强化学习(Inverse Reinforcement Learning,IRL)
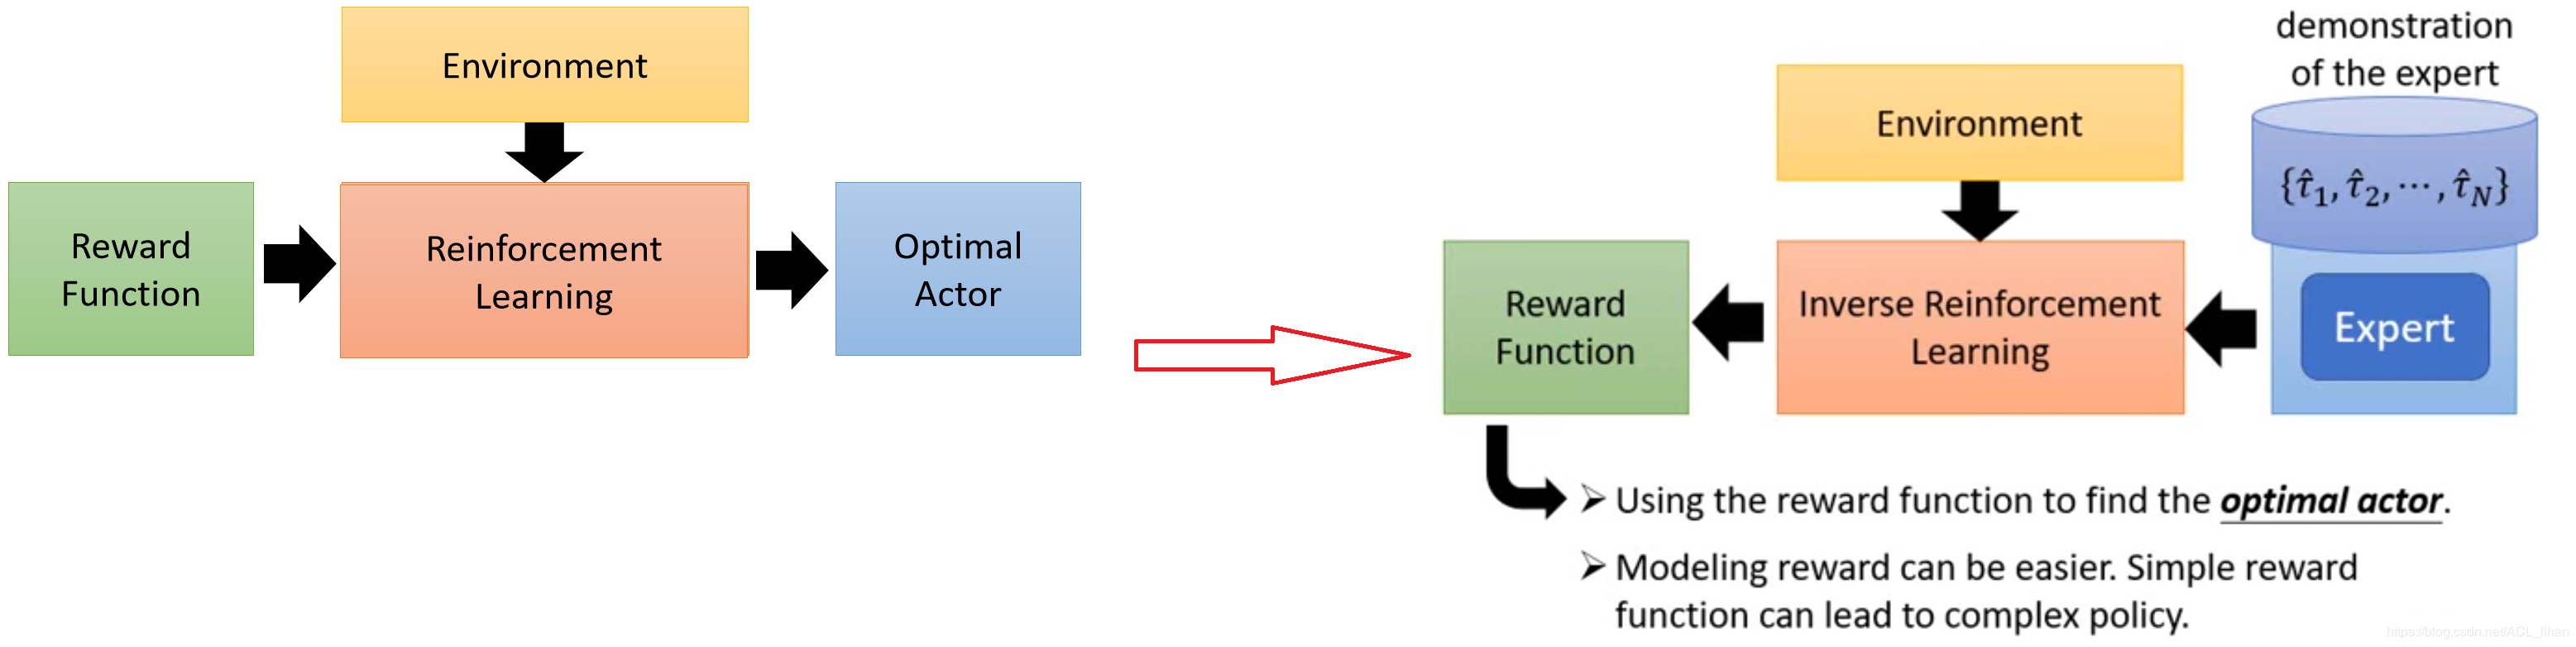
在这里插入图片描述
  上面的左图是熟悉的强化学习的步骤,通过环境和奖励函数,最终得到理想的actor。右图是逆向强化学习的步骤,由于无法从环境中获得奖励,那就需要通过收集人类专家的资料和环境的信息,来反推奖励函数,推出奖励函数后就可以使用正常强化学习的做法了。
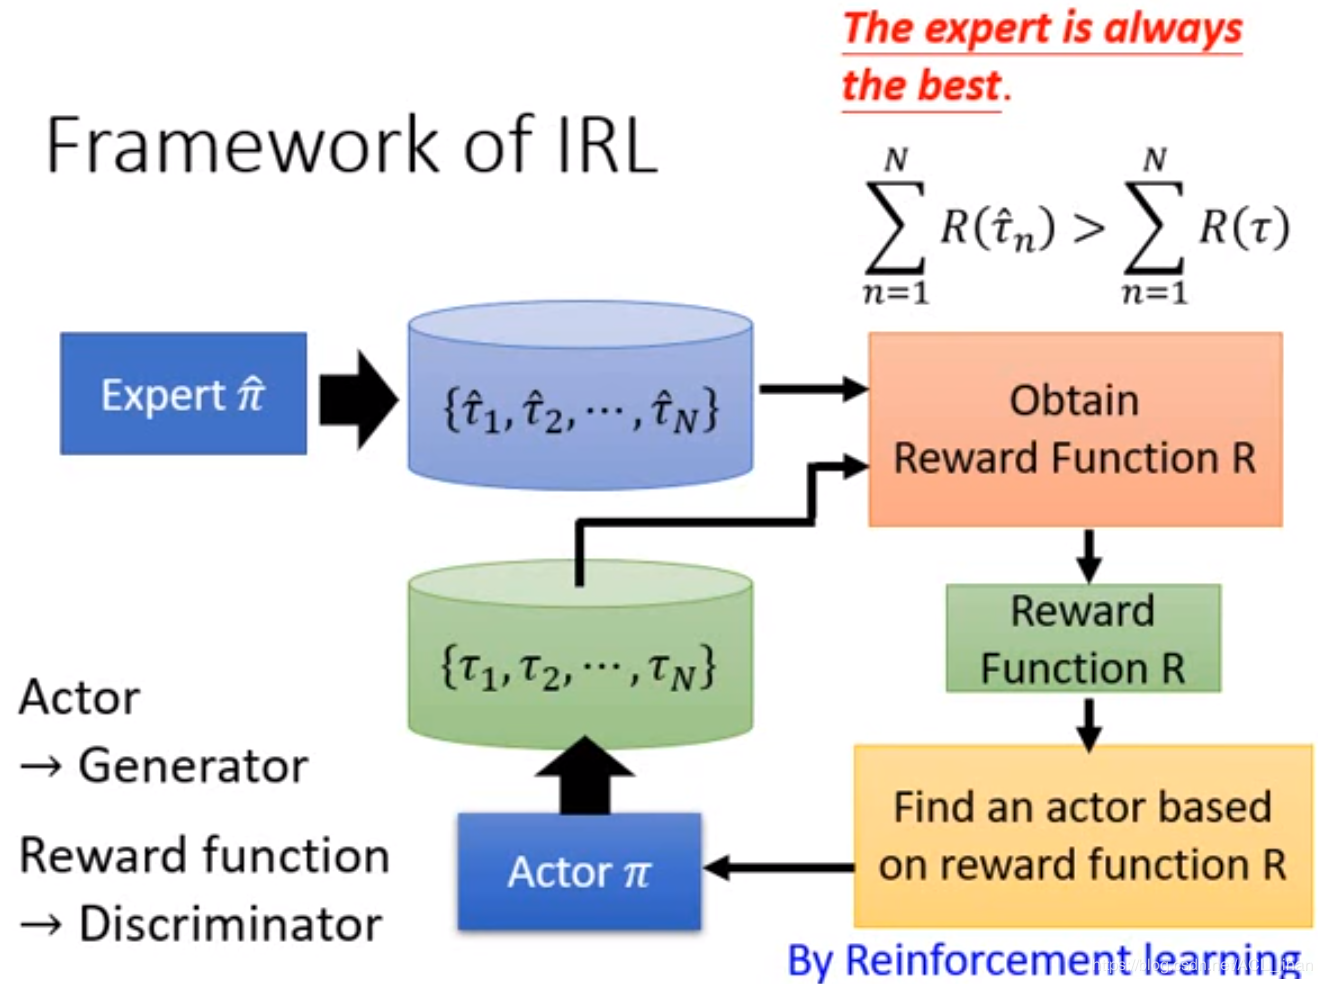
在这里插入图片描述
 emsp;具体来看逆向强化学习的运作步骤:

  1. 让专家先玩游戏,记录游戏过程,形成n个episode;
  2. actor再去玩游戏啊,记录游戏过程,形成n个episode;
  3. 设定一个奖励函数,这个奖励函数强制要求专家的累计得分一定要高于actor的累计得分;
  4. 有了奖励函数就可以使actor去更新出更强的actor;
  5. 当actor能在此时的奖励函数下得到很高的奖励(还是要求专家的得分高于actor),让actor根据新的奖励函数更新出更强的actor;
  6. 重复执行以上步骤。

  逆向强化学习可以实现只用很少的专家示范资料,就可以训练出一个很理想的actor。
  看了以上步骤,可以 想到,actor和奖励函数对应于GAN中的generator和discriminator。通过奖励函数的不断修正,使actor越来越接近专家的水平。
在这里插入图片描述

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容, 请发送邮件至 举报,一经查实,本站将立刻删除。

发布者:全栈程序员-站长,转载请注明出处:https://javaforall.net/193153.html原文链接:https://javaforall.net

赞 (0)
全栈程序员-站长的头像全栈程序员-站长


相关推荐

  • AOSP开源协议_open sap

    AOSP开源协议_open sapOLAP(OnlineAnalyticalProcessing)是指在线联机分析,基于数据查询计算并实时获得返回结果。日常业务中的报表、数据查询、多维分析等一切需要即时返回结果的数据查询任务都属于OLAP的范畴。对应的,行业内也有相应产品来满足这类需求,那就是OLAPServer。当前主流OLAPServer几乎都是基于RDB或封装成RDB的大数据平台,有点类似早期的ROLAP(这个词已经很少被提及了),其中一个关键的特征是使用SQL作为查询语言。RDB和SQL的特性会给OLAPServer带来诸

    2022年10月23日
  • ubuntu ll命令[通俗易懂]

    ubuntu ll命令[通俗易懂]用过Redhat的朋友应该很熟悉ll这个命令,就相当于ls-l,但在Ubuntu中就不行了。严格来说ll不是一个命令,只是命令的别名而已。很多Linux用户都使用bashshell,对普通用户来说用得最多的就是命令补全(按tab键)和alias(别名)功能。Ubuntu默认建立的用户都用的bashshell,所以它也支持别名功能,我们只需要gedi

    2022年9月24日
  • bootstrap的datetimepicker_bootstrap日期选择器

    bootstrap的datetimepicker_bootstrap日期选择器先说datepicker。github上的地址是:https://github.com/eternicode/bootstrap-datepicker。效果如下:在bundle里面引用添加js和

    2022年8月5日
  • A new Linux distribution for ethical computer hacking, penetration testing

    A new Linux distribution for ethical computer hacking, penetration testing

    2021年8月5日
  • 大数据平台展示可视化效果,echarts图表实战项目(源码50套)「建议收藏」

    大数据平台展示可视化效果,echarts图表实战项目(源码50套)「建议收藏」最近接了个任务需要用H5在前台两个大电视上做两页数据展示公司的产品数据,效果要高大上,充分展示咱们公司的实力,给各位来公司参观的大能们留下深刻的印象。还好之前接触过HTML5,所以第一时间想到就是echarts,这个框架对于数据展示尤其图表类处理的还是非常强大和炫酷的。说干就干,首先到官网上把框架下下来,各组件Demo和API都熟悉下,对于你想要的东西和效果心里有个底,就开始动工了。官网地址是:https://echarts.apache.org,里面的Demo都是代码和效果图文并貌,还可以在线修改

    2022年10月12日
  • 为了解决这个问题:07文本WORD文档超链接、页码成{HYPERLINK"网站"}、{PAGE}/{NUMPAGES}

    为了解决这个问题:07文本WORD文档超链接、页码成{HYPERLINK"网站"}、{PAGE}/{NUMPAGES}

    2022年1月12日

发表回复

您的邮箱地址不会被公开。 必填项已用 * 标注

关注全栈程序员社区公众号