scrapy安装步骤_linux下安装scrapy

scrapy安装步骤_linux下安装scrapy1、Scrapy是什么Scrapy是一个为了爬取网站数据,提取结构性数据而编写的应用框架。可以应用在包括数据挖掘,信息处理或存储历史数据等一系列的程序中。2、scrapy安装安装过程中出错:如果安装出现一下错误building‘twisted.test.raiser’extensionerror:MicrosoftVisualC++14.0isrequired.Getitwith“MicrosoftVisualC++BuildTools”:http://l


Jetbrains全系列IDE使用 1年只要46元 售后保障 童叟无欺

1、Scrapy是什么
Scrapy是一个为了爬取网站数据,提取结构性数据而编写的应用框架。 可以应用在包括数据挖掘,信息处理
或存储历史数据等一系列的程序中。
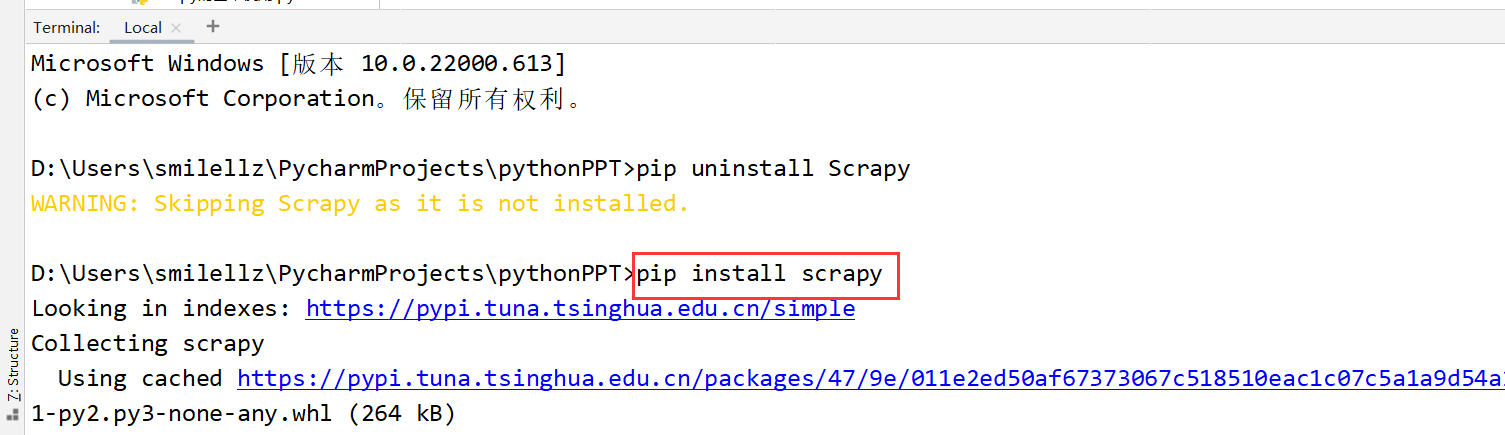
2、scrapy安装
在这里插入图片描述
安装过程中出错:
如果安装出现一下错误
building ‘twisted.test.raiser’ extension
error: Microsoft Visual C++ 14.0 is required. Get it with “Microsoft Visual C++
Build Tools”: http://landinghub.visualstudio.com/visual‐cpp‐build‐tools

解决方案:
http://www.lfd.uci.edu/~gohlke/pythonlibs/#twisted
下载twisted对应版本的whl文件(如我的Twisted‐17.5.0‐cp37‐cp37m‐win_amd64.whl),cp后面是
python版本,amd64代表64位,运行命令:
pip install C:\Users…\Twisted‐17.5.0‐cp37‐cp37m‐win_amd64.whl
pip install scrapy

3、scrapy项目的创建以及运行
3.1scrapy项目的创建
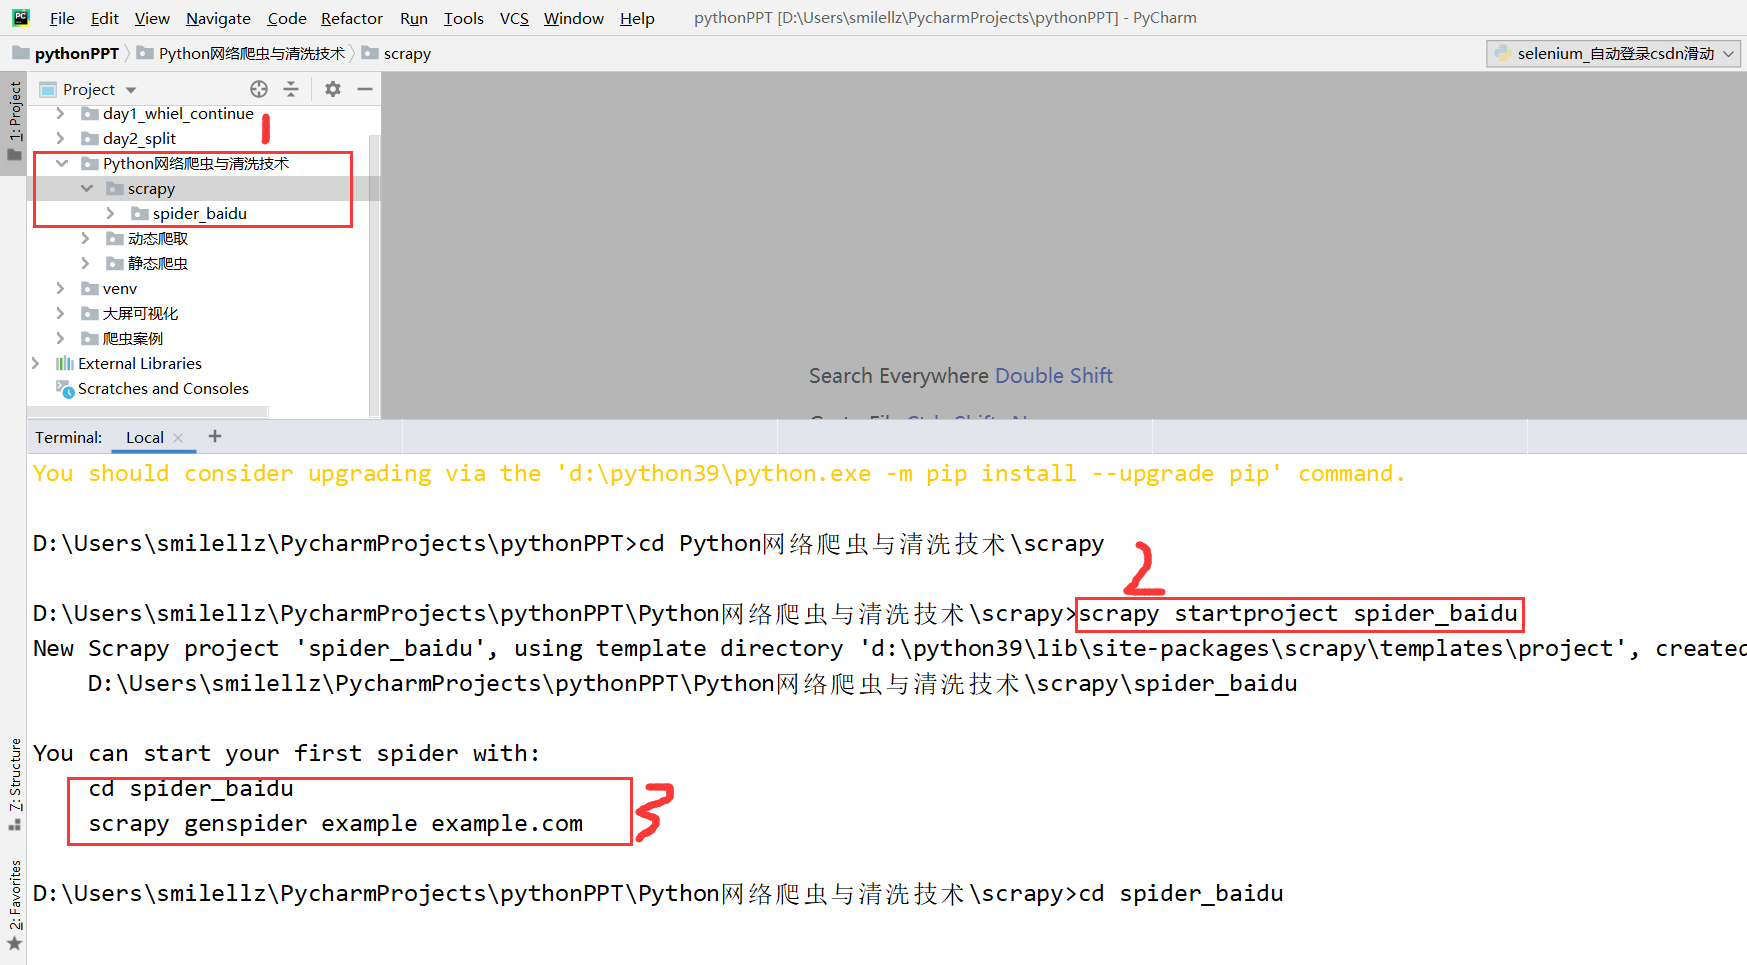
在pycharm终端通过cd命令进入创建项目路径下的文件夹,然后创建一个名为spider_baidu项目(注意:项目名称的定义务必不出现中文)。

创建项目步骤如下图所示:
在这里插入图片描述
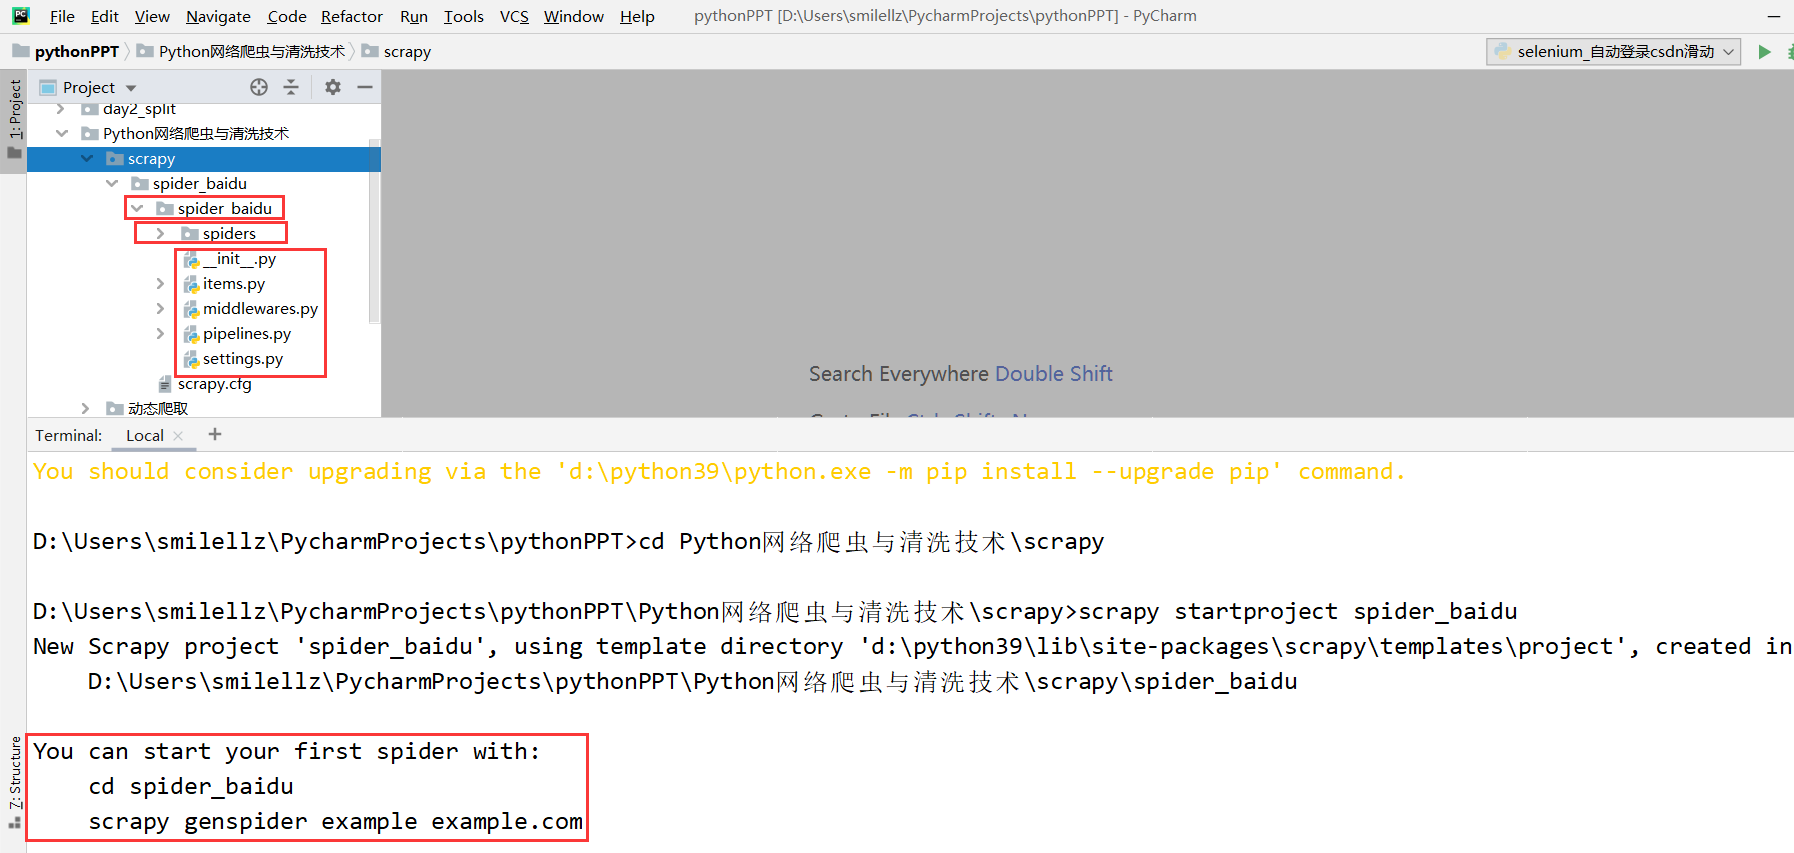
创建成功后该项目忽然多了5个python文件,如图所示:
You can start your first spider with:
cd spider_baidu
scrapy genspider example example.com
在这里插入图片描述
因此该项目(spider_baidu)组成:
spider_baidu
init.py
自定义的爬虫文件.py ‐‐‐》 由我们自己创建,是实现爬虫核心功能的文件
init.py items.py ‐‐‐》定义数据结构的地方,是一个继承自scrapy.Item的类
middlewares.py ‐‐‐》中间件 代理
pipelines.py ‐‐‐》管道文件,里面只有一个类,用于处理下载数据的后续处理默认是300优先级,值越小优先级越高(1‐1000)
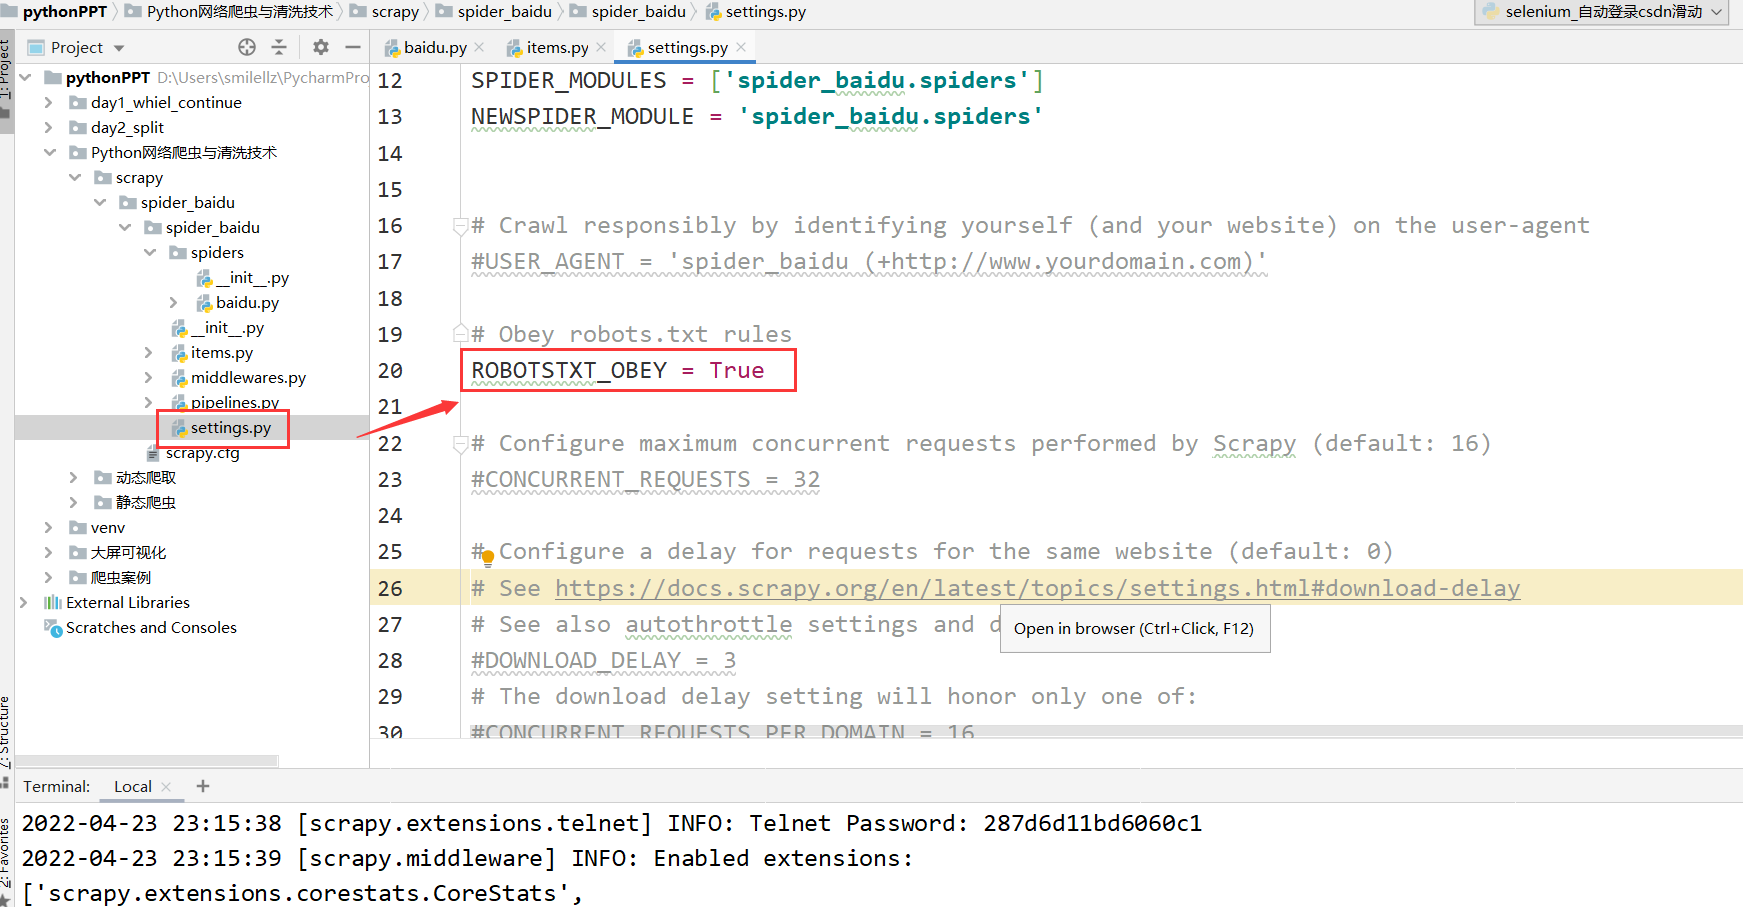
settings.py ‐‐‐》配置文件 比如:是否遵守robots协议,User‐Agent定义等

4.创建爬虫文件:
(1)进入到spiders文件夹
cd 目录名字/目录名字/spiders
(2)scrapy genspider 爬虫名字 网页的域名
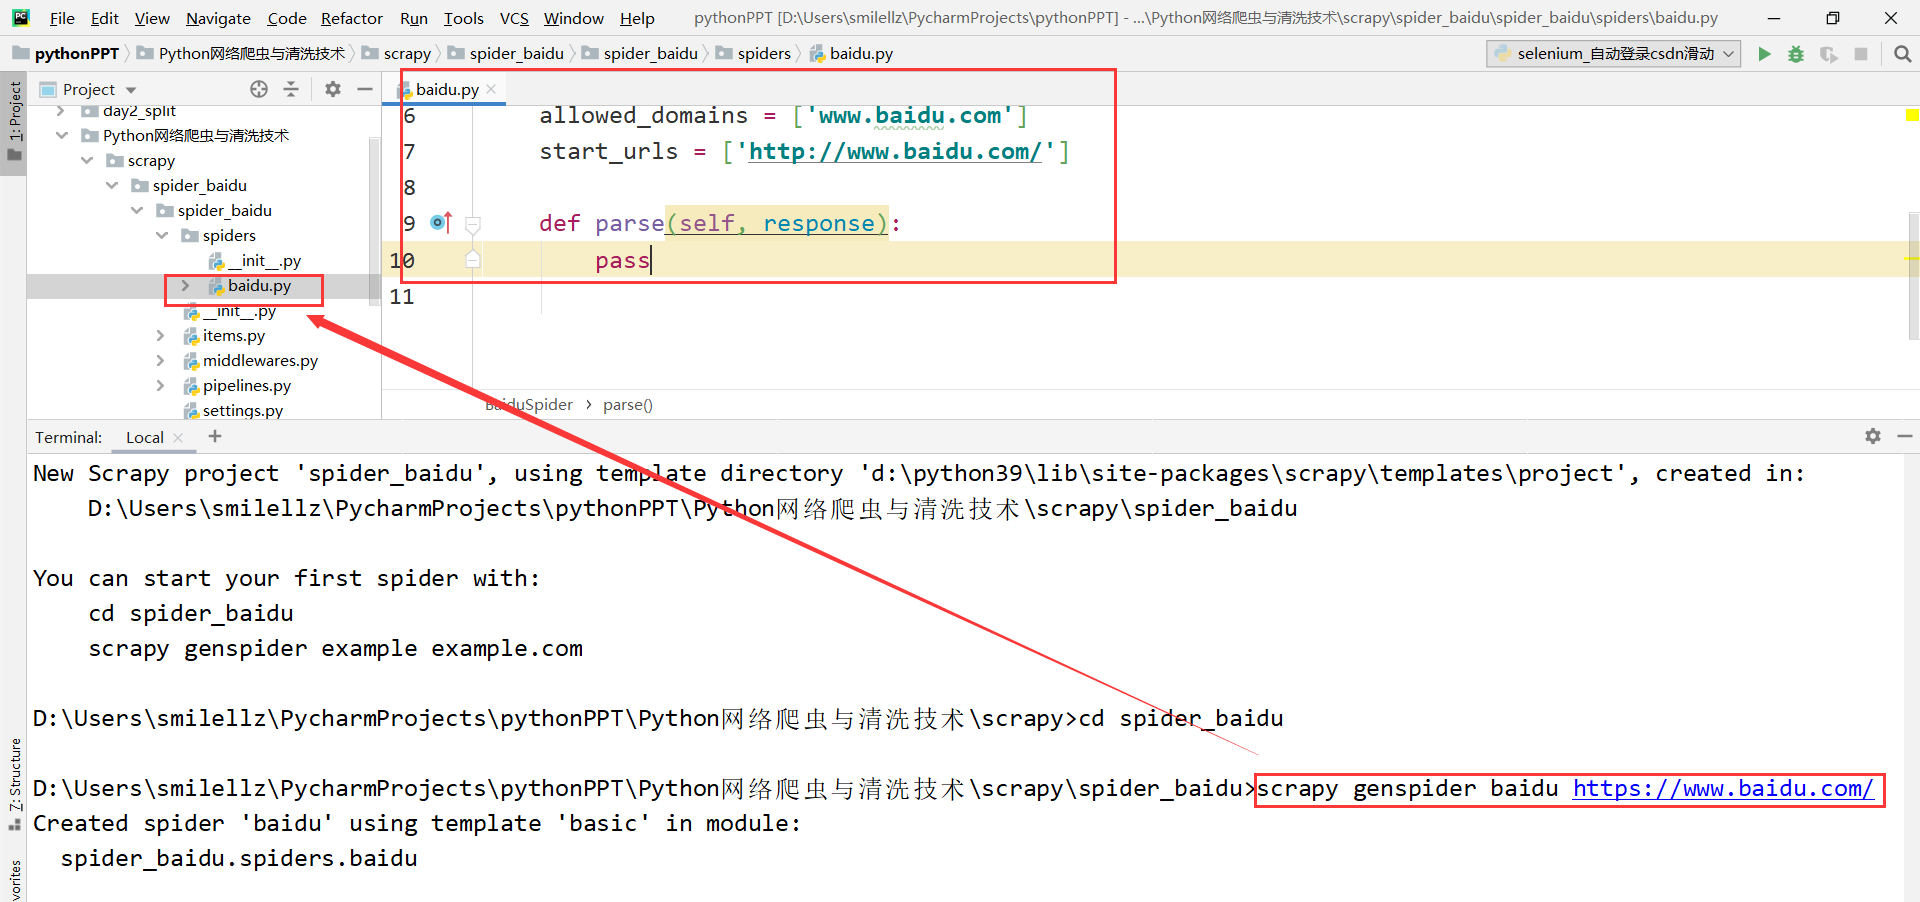
现以百度网站为例:
eg:scrapy genspider baidu https://www.baidu.com/
在这里插入图片描述
spider文件目录下出现baidu.py文件,点击后可以看到自动生成内容:
baidu.py爬虫文件的基本组成:
继承scrapy.Spider类
name = ‘baidu’ ‐‐‐》 运行爬虫文件时使用的名字
allowed_domains ‐‐‐》 爬虫允许的域名,在爬取的时候,如果不是此域名之下的url,会被过滤掉
start_urls ‐‐‐》 声明了爬虫的起始地址,可以写多个url,一般是一个
parse(self, response) ‐‐‐》解析数据的回调函数
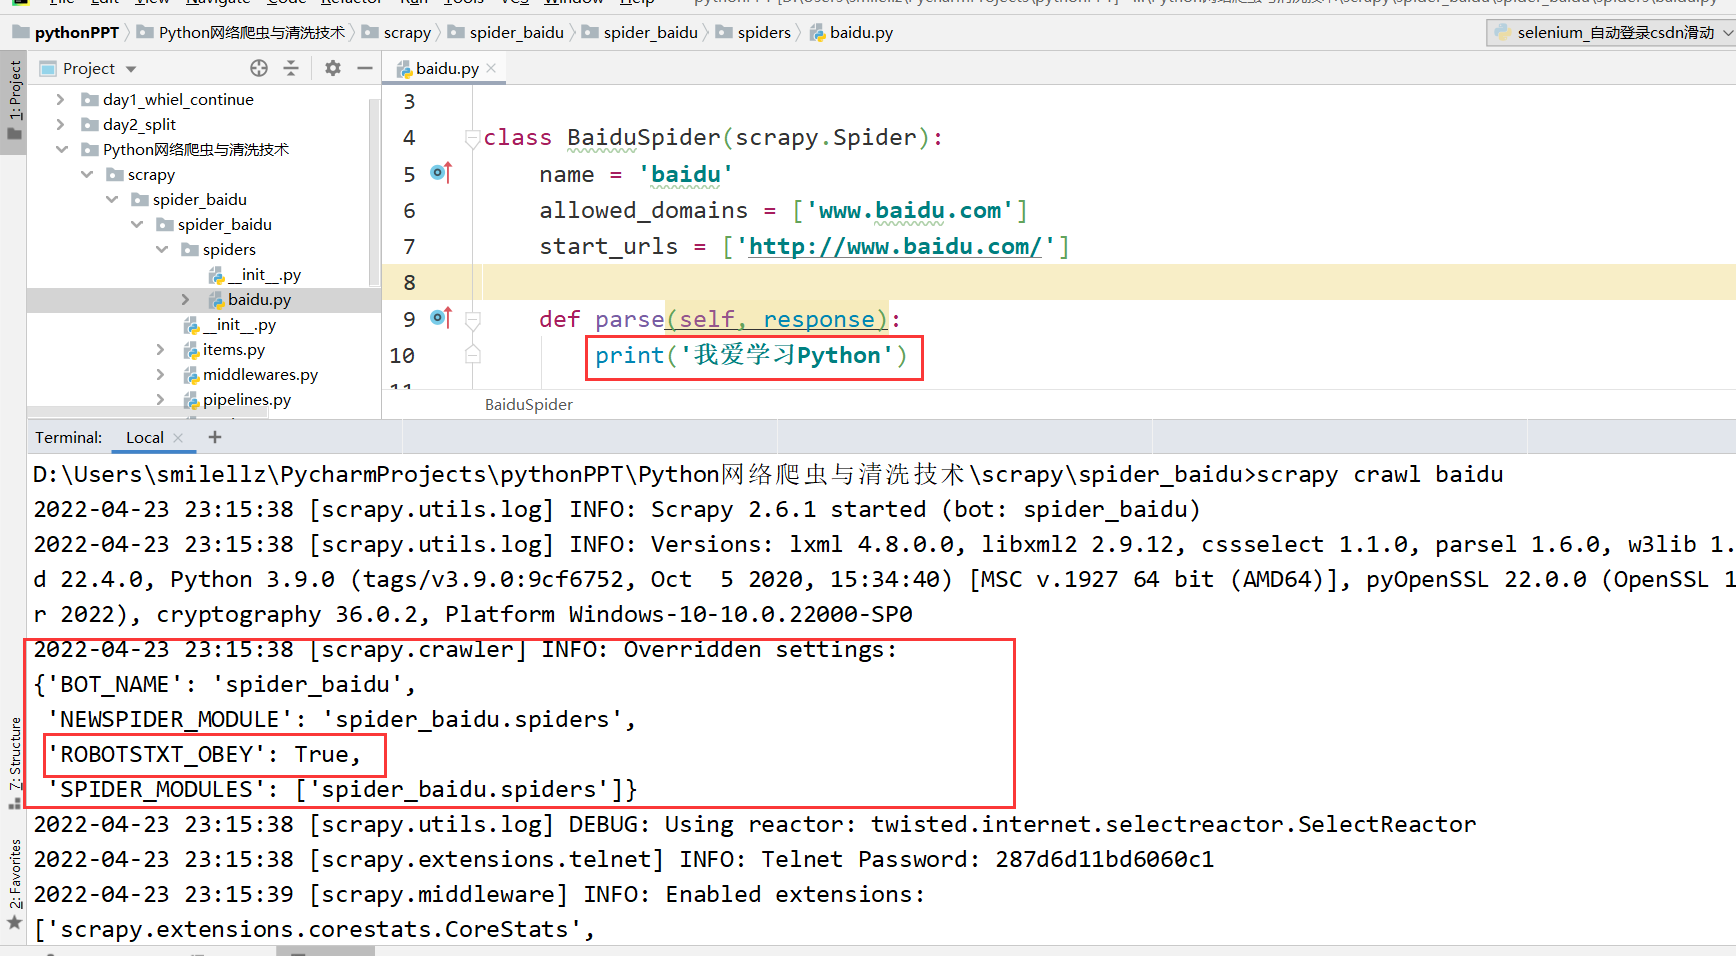
5.运行爬虫文件:
scrapy crawl 爬虫名称
eg:scrapy crawl baidu
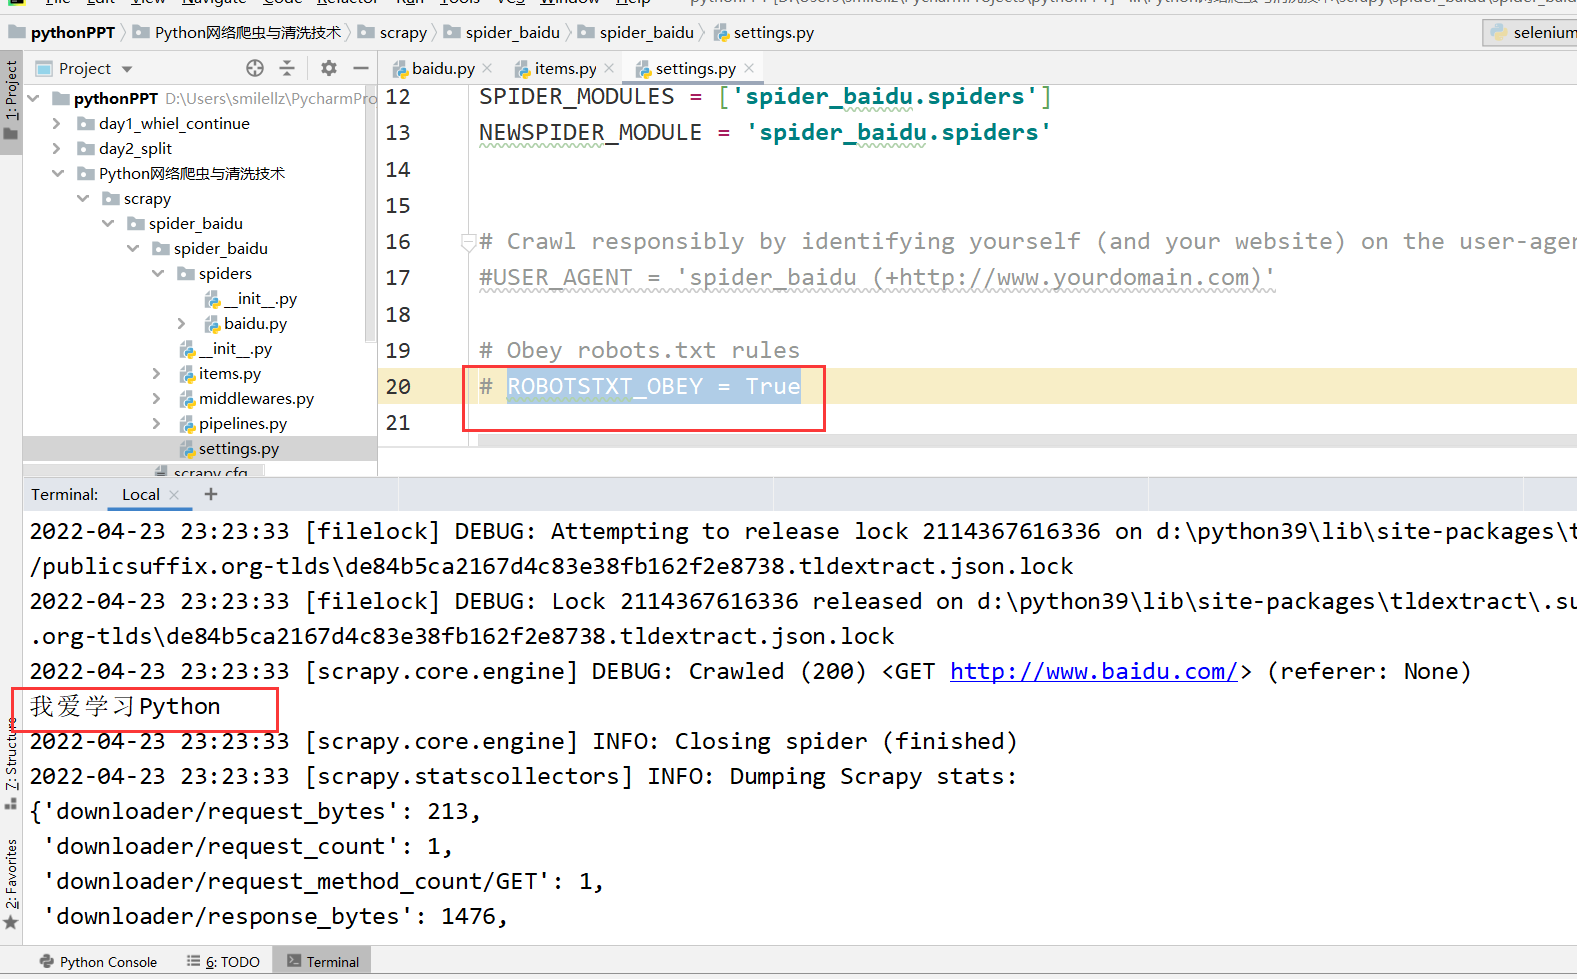
在这里插入图片描述
以上出现报错,只需在settings.py文件把ROBOTSTXT_OBEY = True注释掉再运行即可
在这里插入图片描述

再运行之后,如下图所示:
在这里插入图片描述

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容, 请发送邮件至 举报,一经查实,本站将立刻删除。

发布者:全栈程序员-站长,转载请注明出处:https://javaforall.net/193742.html原文链接:https://javaforall.net

赞 (0)
全栈程序员-站长的头像全栈程序员-站长

相关推荐

  • 公网ntp服务器地址(网站服务器)

    阿里云NTP服务器ntp1.aliyun.comntp2.aliyun.comntp3.aliyun.comntp4.aliyun.comntp5.aliyun.comntp6.aliyun.comntp7.aliyun.com腾讯云NTP服务器time1.cloud.tencent.comtime2.cloud.tencent.comtime3.cloud.ten…

    2022年4月11日
  • objective c源码_以下C代码有哪些错误

    objective c源码_以下C代码有哪些错误我是前言看开源代码时,总会看到一些大神级别的代码,给人眼前一亮的感觉,多数都是被淡忘的C语言语法,总结下objc写码中遇到的各类非主流代码技巧和一些妙用:[娱乐向]objc最短的方法声明[C]结构体的初始化[C]三元条件表达式的两元使用[C]数组的下标初始化[objc]可变参数类型的block[objc]readonly属性支持扩展的写法[C]小括号内联复合表达式[娱乐向]奇葩的C

    2022年10月18日
  • 缺陷报告编写规范[通俗易懂]

    缺陷报告编写规范[通俗易懂]引言 软件缺陷定义  软件缺陷(Defect):又叫做Bug。即为计算机软件、程序、web应用中存在的某种不符合正常运行的功能问题。也是错误、隐藏,让用户不满意的功能缺陷。从产品内部看,缺陷是软件产品开发或维护过程中存在的错误、毛病等各种问题;从产品外部看,缺陷是系统所需要实现的某种功能的失效或违背。 缺陷报告定义  缺陷报告把测试的过程和结果写成文档,并对发现的问题和缺陷进行分析,为…

    2022年9月18日
  • Fiori介绍_fil简介

    Fiori介绍_fil简介为什么写这篇文章Fiori作为SAP最新以及将来的趋势平台,目前发展的非常快,作为一个FIORI技术的关注者,也一直想写点东西来介绍一下.前几天公司组织了一次Fiori的讲座,我作为主讲也参考SAP的介绍制作了一份PPT,在博客也分享出来,大家拿去用吧.SAP前端方案一句话:尽量简单,尽量根据个人的需求而定制.SAPFIORI简介FIORI是什么新的面孔面向所有用户跨平台FIORI应用

    2022年10月23日
  • python3翻转字符串里的单词

    python3翻转字符串里的单词

    2021年4月16日
  • python自动补全设置_python自动缩进快捷键

    python自动补全设置_python自动缩进快捷键Hello,大家好,我是橘子呀~前几期橘子给大家介绍了Python是什么以及如何安装Python软件。也分享了如何系统的以及高效率的去学习Python这门课程,还有一些避雷建议,今天橘子就分享给大伙一点宝藏干货!!!藏不住的东西,不如扬了它!请大家把它收入囊中~不要辜负我的一片苦心~一、Pycharm常用快捷键(Windows)Ctrl+Q快速查看文档Ctrl+鼠标左键简介及代码定义…

    2022年8月27日

发表回复

您的邮箱地址不会被公开。 必填项已用 * 标注

关注全栈程序员社区公众号