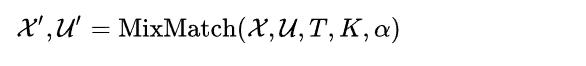半监督之mixmatch

半监督之mixmatch自洽正则化:以前遇到标记数据太少,监督学习泛化能力差的时候,人们一般进行训练数据增广,比如对图像做随机平移,缩放,旋转,扭曲,剪切,改变亮度,饱和度,加噪声等。数据增广能产生无数的修改过的新图像,扩大训练数据集。自洽正则化的思路是,对未标记数据进行数据增广,产生的新数据输入分类器,预测结果应保持自洽。即同一个数据增广产生的样本,模型预测结果应保持一致。此规则被加入到损失函数中,有如下形式,其中x是未标记数据,Augment(x)表示对x做随机增广产生的新数据,θ是模型参数,y是模型预测结.

大家好,又见面了,我是你们的朋友全栈君。如果您正在找激活码,请点击查看最新教程,关注关注公众号 “全栈程序员社区” 获取激活教程,可能之前旧版本教程已经失效.最新Idea2022.1教程亲测有效,一键激活。

Jetbrains全家桶1年46,售后保障稳定

自洽正则化:以前遇到标记数据太少,监督学习泛化能力差的时候,人们一般进行训练数据增广,比如对图像做随机平移,缩放,旋转,扭曲,剪切,改变亮度,饱和度,加噪声等。数据增广能产生无数的修改过的新图像,扩大训练数据集。自洽正则化的思路是,对未标记数据进行数据增广,产生的新数据输入分类器,预测结果应保持自洽。即同一个数据增广产生的样本,模型预测结果应保持一致。此规则被加入到损失函数中,有如下形式,
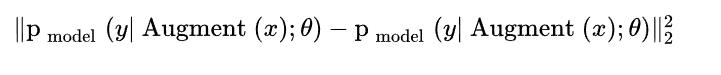

半监督之mixmatch

其中 x 是未标记数据,Augment(x) 表示对x做随机增广产生的新数据, θ 是模型参数,y 是模型预测结果。注意数据增广是随机操作,两个 Augment(x) 的输出不同。这个 L2 损失项,约束机器学习模型,对同一个图像做增广得到的所有新图像,作出自洽的预测。MixMatch 集成了自洽正则化。数据增广使用了对图像的随机左右翻转和剪切(Crop)。

第二种方案称作 最小化熵(Entropy Minimization)【5】。许多半监督学习方法都基于一个共识,即分类器的分类边界不应该穿过边际分布的高密度区域。具体做法就是强迫分类器对未标记数据作出低熵预测。实现方法是在损失函数中简单的增加一项,最小化 半监督之mixmatch 对应的熵。
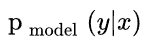
MixMatch 使用 “sharpening” 函数,最小化未标记数据的熵。这一部分后面会介绍。

第三种方案称作传统正则化(Traditional Regularization)。为了让模型泛化能力更好,一般的做法对模型参数做 L2 正则化,SGD下L2正则化等价于Weight Decay。MixMaxtch 使用了 Adam 优化器,而之前有篇文章发现 Adam 和 L2 正则化同时使用会有问题,因此 MixMatch 从谏如流使用了单独的Weight decay。

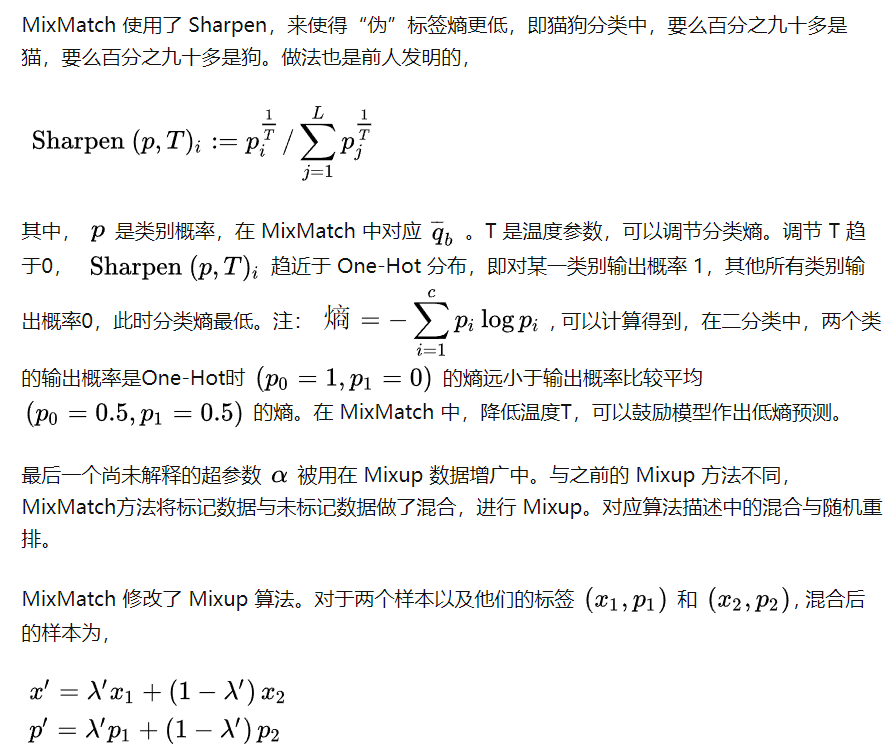
最近发明的一种数据增广方法叫 Mixup 【6】,从训练数据中任意抽样两个样本,构造混合样本和混合标签,作为新的增广数据,半监督之mixmatch
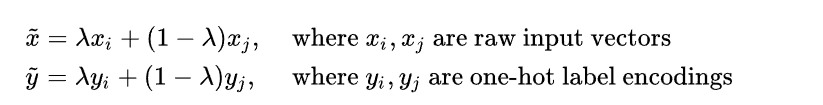
 

其中 lambda 是一个 0 到 1 之间的正数,代表两个样本的混合比例。MixMatch 将 Mixup 同时用在了标记数据和未标记数据中。

mixmatch的具体步骤:

  1. 使用 MixMatch 算法,对一个 Batch 的标记数据  x和一个 Batch 的未标记数据u 做数据增广,分别得到一个 Batch 的增广数据 x’和 K 个Batch的 u’。半监督之mixmatch


其中 T, K,  是超参数,后面会介绍。MixMatch 数据增广算法如下,
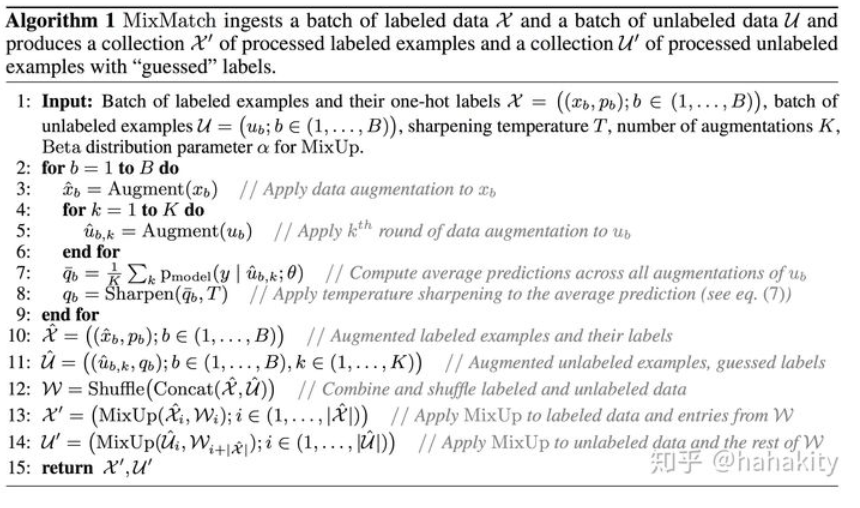
 半监督之mixmatch

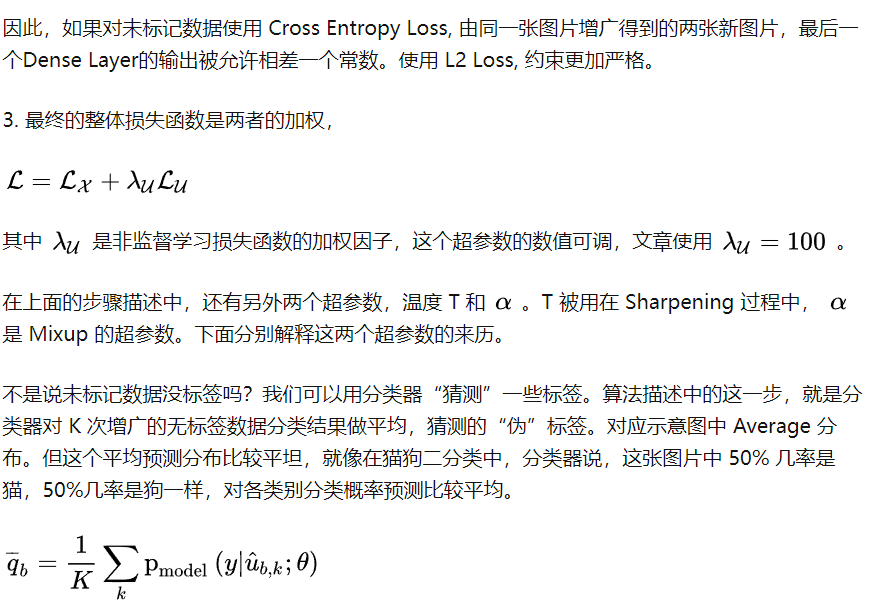
算法描述:for 循环对一个Batch的标记图片和未标记图片做数据增广。对标记图片,只做一次增广,标签不变,记为 p 。对未标记数据,做 K 次随机增广(文章中超参数K=2),输入分类器,得到平均分类概率,应用温度Sharpen 算法(T 是温度参数,此算法后面介绍),得到未标记数据的“猜测”标签  。此时增广后的标记数据  有一个Batch,增广后的未标记数据  有 K 个Batch。将  和  混合在一起,随机重排得到数据集  。最终 MixMatch 增广算法输出的,是将  与  做了MixUp() 的一个 Batch 的标记数据  ,以及  与  做了MixUp() 的 K 个Batch 的无标记增广数据.

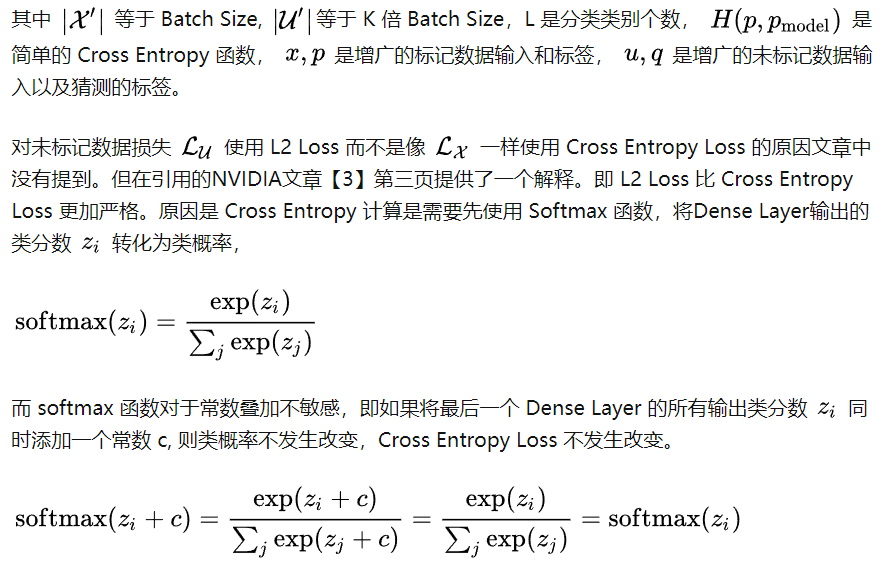
. 对增广后的标记数据 x ,和无标记增广数据u  分别计算损失项,   
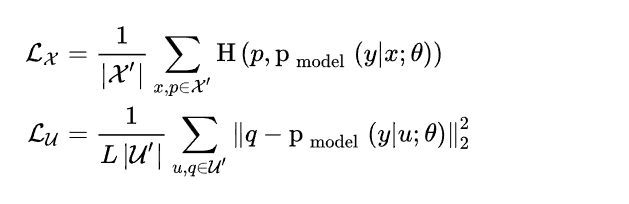
半监督之mixmatch

半监督之mixmatch 

半监督之mixmatch 

半监督之mixmatch 


版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容, 请发送邮件至 举报,一经查实,本站将立刻删除。

发布者:全栈程序员-站长,转载请注明出处:https://javaforall.net/203991.html原文链接:https://javaforall.net

赞 (0)
全栈程序员-站长的头像全栈程序员-站长


相关推荐

  • 分布式文件存储系统的优点和缺点

    分布式文件存储系统的优点和缺点分布式文件存储系统分布式:在hdfs中由多个服务器组成,每个服务器扮演着不同的角色HDFS适用于一次写入多次读出,不支持文件修改优点1高容错性一台宕机没有什么问题,不会造成一个数据整体丢失。丢失的部分数据丢失会很快从其他节点拉取并回复。2合存储大数据量的文件数量级GBTBPB都支持件规模适合存储百万规模的数据3硬件价格低廉可以使用廉价的物理机缺点1不适合存储小文件这个面试也可能会被问到,请重点理解造成namenode的元数据储存信息比较多文件过多会导致寻址时间较长,组

    2022年6月8日
  • Mac JetBrains全家桶软件激活码_最新在线免费激活[通俗易懂]

    (Mac JetBrains全家桶软件激活码)最近有小伙伴私信我,问我这边有没有免费的intellijIdea的激活码,然后我将全栈君台教程分享给他了。激活成功之后他一直表示感谢,哈哈~https://javaforall.net/100143.htmlIntelliJ2021最新激活注册码,破解教程可免费永久激活,亲测有效,上面是详细链接哦~00OE…

    2022年3月30日
  • phpstorm 中git 的使用

    phpstorm 中git 的使用

    2021年10月17日
  • 【2021最新版】MyBatis面试题总结(38道题含答案解析)[通俗易懂]

    【2021最新版】MyBatis面试题总结(38道题含答案解析)[通俗易懂]文章目录1、什么是Mybatis?2、Mybaits的优点?3、MyBatis框架的缺点?4、MyBatis框架适用场合5、MyBatis与Hibernate有哪些不同?6、#{}和${}的区别是什么?7、当实体类中的属性名和表中的字段名不一样,怎么办?8、模糊查询like语句该怎么写?9、通常一个Xml映射文件,都会写一个Dao接口与之对应,请问,这个Dao接口的工作原理是什么?Dao接口里的方法,参数不同时,方法能重载吗?10、Mybatis是如何进行分页的?分页插件的原理是什么?11、Myba

    2022年5月1日
  • fsync

    fsync转载:https://www.jb51.net/article/101062.htm脏页:linux内核中的概念,因为硬盘的读写速度远赶不上内存的速度,系统就把读写比较频繁的数据事先放到内存中,以提高读写速度,这就叫高速缓存,linux是以页作为高速缓存的单位,当进程修改了高速缓存里的数据时,该页就被内核标记为脏页,内核将会在合适的时间把脏页的数据写到磁盘中去,以保持高速缓存中的数据和磁盘中的数…

    2022年5月31日
  • cpickle支持的python版本_Python中cPickle

    cpickle支持的python版本_Python中cPicklecPickle模块:在python中,一般可以使用pickle类来进行python对象序列化,而cPickle提供了一个更快速简单的接口,如python文档所说:“cPickle-Afasterpickle”。cPickle可以对任意一种类型的python对象进行序列化操作,比如:list,dict,甚至是一个类的对象等。而所谓的序列化,是为了能完整地保存并能够完全可逆的恢复。在cPic…

    2022年6月22日

发表回复

您的邮箱地址不会被公开。 必填项已用 * 标注

关注全栈程序员社区公众号