
前言
SPI(Service Provider Interface):服务提供接口
本文主要介绍dubbo源码中大量使用的SPI机制,至于什么是SPI,请自行查阅
dubbo SPI
dubbo中提供了一个ExtensionLoader.getLoadingStrategies()方法,但是在dubbo3.0.6版本已经废弃,取而代之的是几个区分了模块的类,ApplicationModel、FrameworkModel、ModuleModel
dubbo中的spi规则是这样的,首先在META-INF/dubbo/internal下会有很多的SPI接口类,这些接口都是标记了@SPI注解的
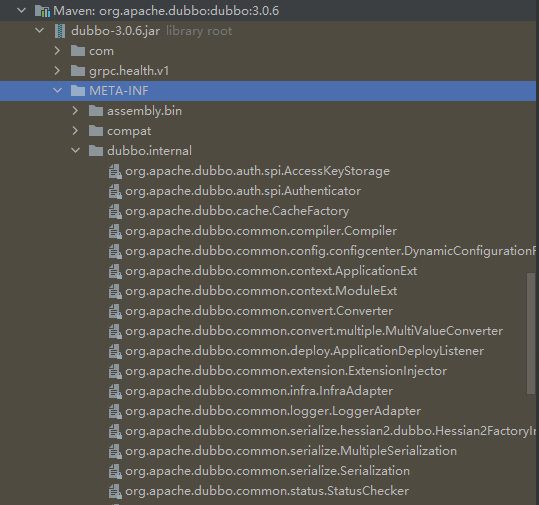

以其中的一个org.apache.dubbo.rpc.cluster.Cluster接口为例,其文件内容如下,以下value值都是Protocol接口的实现类
mock=org.apache.dubbo.rpc.cluster.support.wrapper.MockClusterWrapper
failover=org.apache.dubbo.rpc.cluster.support.FailoverCluster
failfast=org.apache.dubbo.rpc.cluster.support.FailfastCluster
failsafe=org.apache.dubbo.rpc.cluster.support.FailsafeCluster
failback=org.apache.dubbo.rpc.cluster.support.FailbackCluster
forking=org.apache.dubbo.rpc.cluster.support.ForkingCluster
available=org.apache.dubbo.rpc.cluster.support.AvailableCluster
mergeable=org.apache.dubbo.rpc.cluster.support.MergeableCluster
broadcast=org.apache.dubbo.rpc.cluster.support.BroadcastCluster
zone-aware=org.apache.dubbo.rpc.cluster.support.registry.ZoneAwareCluster
@SPI(Cluster.DEFAULT)
public interface Cluster {


    String DEFAULT = "failover";

    /** * Merge the directory invokers to a virtual invoker. * * @param <T> * @param directory * @return cluster invoker * @throws RpcException */
    @Adaptive
    <T> Invoker<T> join(Directory<T> directory, boolean buildFilterChain) throws RpcException;

    static Cluster getCluster(ScopeModel scopeModel, String name) {

        return getCluster(scopeModel, name, true);
    }

    static Cluster getCluster(ScopeModel scopeModel, String name, boolean wrap) {

        if (StringUtils.isEmpty(name)) {

            name = Cluster.DEFAULT;
        }
        return ScopeModelUtil.getApplicationModel(scopeModel).getExtensionLoader(Cluster.class).getExtension(name, wrap);
    }
}
基于名称的扩展点
Cluster failsafeCluster = ApplicationModel.defaultModel().getExtensionLoader(Cluster.class)
                .getExtension("failsafe");
看一下getExtension方法
public T getExtension(String name) {

        T extension = getExtension(name, true);
        if (extension == null) {

            throw new IllegalArgumentException("Not find extension: " + name);
        }
        return extension;
    }
调用底层getExtension时第二个参数表示是否需要包装,这里是true,何为包装呢
比如上述的一个org.apache.dubbo.rpc.cluster.support.wrapper.MockClusterWrapper,其后缀是Wrapper,官方的包装类基本都是以Wrapper结尾的,看一下实现类
public class MockClusterWrapper implements Cluster {


    private final Cluster cluster;

    public MockClusterWrapper(Cluster cluster) {

        this.cluster = cluster;
    }

    @Override
    public <T> Invoker<T> join(Directory<T> directory, boolean buildFilterChain) throws RpcException {

        return new MockClusterInvoker<T>(directory,
                this.cluster.join(directory, buildFilterChain));
    }

    public Cluster getCluster() {

        return cluster;
    }
}
它有一个构造器,接受了一个当前的接口对象Cluster,这是一种很明显的装饰器模式,当获取实现类时如果传递wrap参数是true时,会使用所有的包装类进行层层包装,用装饰器模式进行装饰
根据Cluster接口找到其中名为failsafe的实现类,这里是org.apache.dubbo.rpc.cluster.support.FailsafeCluster实现类,根据上述装饰器模式,因为这里只有一个包装类,所以这里获得的是MockClusterWrapper(FailsafeCluster)
自适应扩展点
Cluster adaptiveExtension = ApplicationModel.defaultModel().getExtensionLoader(Cluster.class)
                .getAdaptiveExtension();
什么是自适应扩展点呢,首先看一下Cluster接口,自适应接口的必须满足下述两个需求的其中之一
- 接口有@Adaptive注解
- 至少有一个方法是有@Adaptive注解的
场景1,接口上有@Adaptive注解,那么这里直接获取到该实现类
场景2,这种场景会比较复杂,会根据字节码重组,动态编译生成一个动态类,类似于jdk的动态代理,这里我从源码内部把生成的字节码的字符串找出来是这样的,生成到内存的是一个Cluster$Adaptive对象,可以看到其内部最终从Directory 里面getUrl之后,从url中获取了一个cluster参数,这个cluster参数可以在@Adaptive上指定,否则有默认的生成规则,当url中没有cluster参数时会使用@SPI注解中的默认值failover
基于这个自适应扩展点,那么使用这个类,如果url中的cluster不一样,那么就会使用不同的cluster实现类,实现根据url来动态的切换实现类,而获得的自适应扩展类则不需要任何变化
需要注意标记在方法上的支持自适应方法中必须要带url,或者其一个参数中通过getUrl方法可以获得到一个url,比如Directory,只有可以获取到url才能根据url进行自适应
public class Cluster$Adaptive implements org.apache.dubbo.rpc.cluster.Cluster {


    public Invoker join(Directory arg0, boolean arg1) throws org.apache.dubbo.rpc.RpcException {

        if (arg0 == null) throw new IllegalArgumentException("org.apache.dubbo.rpc.cluster.Directory argument == null");
        if (arg0.getUrl() == null)
            throw new IllegalArgumentException("org.apache.dubbo.rpc.cluster.Directory argument getUrl() == null");
        URL url = arg0.getUrl();
        // 获取url中cluster的参数
        String extName = url.getParameter("cluster", "failover");
        if (extName == null)
            throw new IllegalStateException("Failed to get extension (org.apache.dubbo.rpc.cluster.Cluster) name from url (" + url.toString() + ") use keys([cluster])");
        ScopeModel scopeModel = ScopeModelUtil.getOrDefault(url.getScopeModel(),Cluster.class);
        // 根据cluster的value获取
        Cluster extension =  scopeModel.getExtensionLoader(Cluster.class).getExtension(extName);
        return extension.join(arg0, arg1);
    }

    public org.apache.dubbo.rpc.cluster.Cluster getCluster(org.apache.dubbo.rpc.model.ScopeModel arg0, java.lang.String arg1) {

        throw new UnsupportedOperationException("The method public static org.apache.dubbo.rpc.cluster.Cluster org.apache.dubbo.rpc.cluster.Cluster.getCluster(org.apache.dubbo.rpc.model.ScopeModel,java.lang.String) of interface org.apache.dubbo.rpc.cluster.Cluster is not adaptive method!");
    }

    public org.apache.dubbo.rpc.cluster.Cluster getCluster(org.apache.dubbo.rpc.model.ScopeModel arg0, java.lang.String arg1, boolean arg2) {

        throw new UnsupportedOperationException("The method public static org.apache.dubbo.rpc.cluster.Cluster org.apache.dubbo.rpc.cluster.Cluster.getCluster(org.apache.dubbo.rpc.model.ScopeModel,java.lang.String,boolean) of interface org.apache.dubbo.rpc.cluster.Cluster is not adaptive method!");
    }
}
激活扩展点
激活扩展点的实现类上都会有@Activate注解,比如我自定义一个Filter的激活扩展点,我定义了value=mykey,表示只有当url中有mykey这样一个key才返回当前过滤器,group是分组,我设置了字符串provider和consumer,表示当我的group查询provider或者consumer时当前过滤器返回,并且在META-INF下定义好该SPI
@Activate(value = "myKey", group = {
   CommonConstants.PROVIDER, CommonConstants.CONSUMER})
public class LogFilter implements Filter {

    @Override
    public Result invoke(Invoker<?> invoker, Invocation invocation) throws RpcException {


        System.out.println("拦截所有dubbo调用-------------------------");

        return invoker.invoke(invocation);
    }
}
URL url = new URL("","",8080);
url = url.addParameter("myKey","111");
List<Filter> activateList = ApplicationModel.defaultModel().getDefaultModule().getExtensionLoader(Filter.class)
                .getActivateExtension(url, "","provider");
当我使用上述方法获取扩展点时即可拿到我自己自定义的LogFilter,因为我要过滤的group=provider,并且url中带了myKey这个key,并且返回了很多其他的Filter
这个激活扩展点机制,就很适合用于各种拦截的场景,比如我要拦截所有dubbo请求的发起,或者拦截所有当前服务的dubbo服务被调用,那么只要像我上述定义的LogFilter一样,指定好group即可,因为dubbo的源码内部就是有一个根据当前是provider还是consumer来获取所有Filter,组成一个调用链路的
根据SPI扩展自己的自定义插件
基于上述自适应扩展机制,比如我想设置某个服务的负载均衡策略为每次只选择第一个,那么只要这样写
根据LoadBalance spi机制,自定义自己的LoadBalance实现
public class FirstLoadBalance implements LoadBalance {

    @Override
    public <T> Invoker<T> select(List<Invoker<T>> invokers, URL url, Invocation invocation) throws RpcException {

        // 测试只选择第一个
        return invokers.get(0);
    }
}
在META-INF/dubbo/internal下定义org.apache.dubbo.rpc.cluster.LoadBalance文件,内容如下
first=com.example.consumer.spi.FirstLoadBalance
指定负载均衡策略,那么这个接口就会使用我们自定义的first的负载均衡策略了
    @DubboReference(
            protocol = "dubbo",
            loadbalance = "first",
            cluster = "failover",check = false,retries = 5)
    private SayHelloService sayHelloService;
发布者:全栈程序员-站长,转载请注明出处:https://javaforall.net/234412.html原文链接:https://javaforall.net



