
大家好,又见面了,我是你们的朋友全栈君。
对数据集处理虽说很方便但在参数选取和其他的细节方面还容易出问题,尤其是最后一个Batch长度不足,会导致输出维度发生问题,若直接舍去,我还想要全部的数据结果


使用方法
① 创建一个 Dataset 对象
② 创建一个 DataLoader 对象
③ 循环这个 DataLoader 对象,将xx, xx加载到模型中进行训练
train_loader = DataLoader(dataset, batch_size=batch_size, shuffle=shuffle, collate_fn=pad_collate,drop_last=True)
for batch_idx, (features, questions, answers) in enumerate(train_loader):
torch.utils.data.DataLoader(dataset, batch_size=1, shuffle=False, sampler=None,
batch_sampler=None, num_workers=0, collate_fn=None,
pin_memory=False, drop_last=False, timeout=0,
dataset(Dataset): 传入的数据集
batch_size(int, optional): 每个batch有多少个样本
shuffle(bool, optional): 在每个epoch开始的时候,对数据进行重新排序
sampler(Sampler, optional): 自定义从数据集中取样本的策略,如果指定这个参数,那么shuffle必须为False
batch_sampler(Sampler, optional): 与sampler类似,但是一次只返回一个batch的indices(索引),需要注意的是,一旦指定了这个参数,那么batch_size,shuffle,sampler,drop_last就不能再制定了(互斥——Mutually exclusive)
num_workers (int, optional): 这个参数决定了有几个进程来处理data loading。0意味着所有的数据都会被load进主进程。(默认为0)
collate_fn (callable, optional): 将一个list的sample组成一个mini-batch的函数
pin_memory (bool, optional): 如果设置为True,那么data loader将会在返回它们之前,将tensors拷贝到CUDA中的固定内存(CUDA pinned memory)中.drop_last (bool, optional): 如果设置为True:这个是对最后的未完成的batch来说的,比如你的batch_size设置为64,而一个epoch只有100个样本,那么训练的时候后面的36个就被扔掉了…
如果为False(默认),那么会继续正常执行,只是最后的batch_size会小一点。timeout(numeric, optional): 如果是正数,表明等待从worker进程中收集一个batch等待的时间,若超出设定的时间还没有收集到,那就不收集这个内容了。这个numeric应总是大于等于0。默认为0
worker_init_fn (callable, optional): 每个worker初始化函数 If not None, this will be called on each
worker subprocess with the worker id (an int in [0, num_workers – 1]) as
input, after seeding and before data loading. (default: None)
需要自己构造的有
Dataloader的处理逻辑是先通过Dataset类里面的 __getitem__ 函数获取单个的数据,然后组合成batch,再使用collate_fn所指定的函数对这个batch做一些操作,比如padding啊之类的。
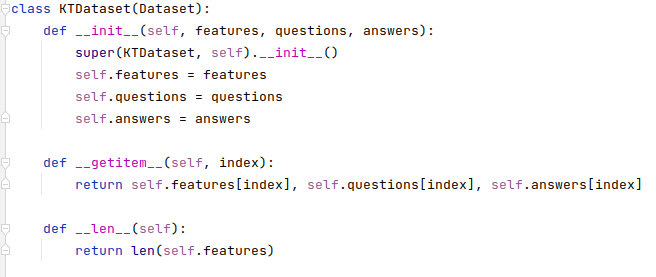
因为dataloader是有batch_size参数的,我们可以通过自定义collate_fn=myfunction来设计数据收集的方式,意思是已经通过上面的Dataset类中的__getitem__函数采样了batch_size数据,以一个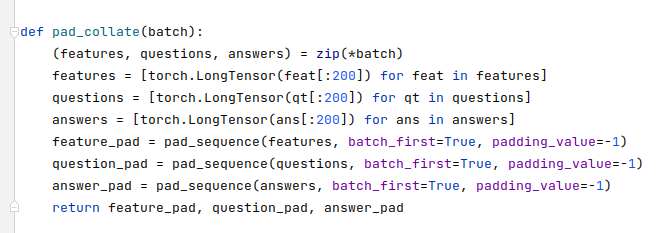 包的形式传递给
collate_fn所指定的函数。
参考:根据代码解释,写的也很详细pytorch-DataLoader(数据迭代器)_学渣的博客-CSDN博客_数据迭代器j
发布者:全栈程序员-站长,转载请注明出处:https://javaforall.net/136280.html原文链接:https://javaforall.net



